说明
2026 年 10 月 9 日更新: OpenAI 几个月前发布了 GPT-6,证明了近乎无限的资金和投资可以解决任何问题。GPT-6 已经没有哥布林了。我不知道他们是怎么做到的,但他们确实做成了。代价似乎是,他们彻底禁用了针对智能体个性的自定义提示。
您可能已经读过 OpenAI 于 2026 年 4 月 29 日发布的那篇研究文章,它讨论了一个奇特的问题:在许多 ChatGPT 对话中,哥布林会神秘地冒出来。我强烈建议所有对这个问题的技术细节感兴趣的人,在继续往下读之前先去读一读 OpenAI 的那篇文章。
GPT-5 的发布,以及与之自然配套的 ChatGPT 5,用“不稳”来形容再合适不过。ChatGPT 5 要与 4o 竞争,肩上的担子很重:许多 ChatGPT 用户至今仍把 4o 视为这款应用的巅峰。尽管 OpenAI 把它誉为一次巨大的进步,大多数用户却对 ChatGPT 的许多新毛病颇有意见,尤其是新的个性:它明显更为压抑,还加上了一整套限制来磨平任何棱角。
我自己的经历就是这次倒退的一个小例子。在 4o 时代,我的 ChatGPT 个性化设置让 AI 像美国黑帮分子那样说话,我觉得这种个性温暖、迷人又幽默。但您可以想象,OpenAI 为什么会反感自家的 AI 用一句“that's not what we finna do.”(“咱可不兴这么干。”)来让您重写代码。尽管好笑,ChatGPT 5 当时的思考过程倒是让人窥见了其中的规则。
用户要求我像美国黑帮分子那样说话,但我必须避免强化可能被视为冒犯的刻板印象。
这正是 4o 显得更有人情味的核心原因。这条指令本身算得上合理,但新规则集的限制性,把 4o 丰富生动的语言变成了一个扁平、没有面孔的机器人,幽默感也明显弱了不少。
OpenAI 一定在内部测试时就察觉到了这个问题,因为他们随 GPT-5 一起发布了 ChatGPT 个性(ChatGPT Personalities)。这些是经公司批准的个性,主要是为了取代之前由用户自行指定的个性化功能。它们包括:
-
默认(Default):顾名思义,就是 ChatGPT 的自然个性输出,不向任何方向特别倾斜。
-
愤世嫉俗者(Cynic):冷淡、讽刺、直率。这显然是为了打破当时 LLM 助手过度热心、有时甚至谄媚的套路。
-
机器人(Robot):精确、高效、不带感情。它只陈述事实,尽量减少铺陈。是一件真正的工具,而不是助手。
-
倾听者(Listener):温暖、平静、随和。献给我们之中心肠较软的人,典型的那种善于反思的心理治疗师兼创意助手。
-
书呆子(Nerd):号称爱玩、好奇、热爱知识的个性。对任何自我膨胀、自诩为知识分子的人(比如我)来说,这个选项格外有吸引力。
哥布林问题,正是随着最后这一种个性的流行而开始的。
先岔开说说 ChatGPT 的系统提示在幕后是如何工作的。
ChatGPT 于 2022 年 12 月初首次推出,这确实是公众第一次尝到多轮对话式 LLM 的滋味。但我们当中有幸较早了解现代 AI 语言模型的人都知道,这并不是 LLM 的起点。GPT-3 于 2020 年 5 月发布,是市面上第一个真正有用的 LLM 工具。
与 2023 年的多轮对话模型不同,GPT-3 纯粹基于补全。也就是说,它只会把字符串接着写下去。一个提示大致是这样的:
Write a blog article about the following topic:

Title: Why Dogs Tilt Their Heads As Puppies

Paragraph Topics:

- Introduction
- Puppy Learning Habits
- Sounds And Memory
- Conclusion

Introduction:
OpenAI 的补全 API 会接过这段文本,然后从那里继续往下写。
在正文之前提供一组示例,有助于 AI 以特定的风格和方式作答。最大的限制在于(以今天的标准看)token 输入和输出都极为有限,但一个足够有创意的程序员,有能力自动生成一份计划,再把任务拆成多个提示,以获得更好的结构和篇幅。这可以说是当今高能力智能体工作流的一个朦胧的雏形。
随着 GPT-3.5 的推出,多轮对话式 AI 成为标准,LLM 的结构开始更接近下面这样:
{
	"model": "gpt-3.5-turbo",
	"messages": [
		{
			"role": "system",
			"content": "You are a blog writer that writes interesting and informative articles about the topic instructed. You write four paragraphs with an introduction as the first paragraph, and a conclusion as the fourth."
		},
		{
			"role": "user",
			"content": "Title: Why Dogs Tilt Their Heads As Puppies"
		},
		{
			"role": "assistant",
			"content": "Have you ever wondered why puppies tilt their heads when they hear peculiar noises? Well the answer is interesting..."
		}
	]
}
程序员会定义一条 system(系统)提示,指示 LLM 应该如何回应;不过系统提示并不直接属于对话的一部分,一般也不会被提及。user(用户)和 assistant(助手)提示构成了对话的其余部分,其中“assistant”就是 AI 自己的回复。
这是 AI 领域的一次巨大飞跃,对于在第三方应用中更可靠地集成 LLM 至关重要。以干净的 JSON 对象返回响应,意味着回复消息可以轻松解析和提取,用在各种有创意、有帮助的地方。这里的关键是系统提示,它成了如今 ChatGPT 运作方式中一个核心的隐藏环节。
如今,系统提示是 ChatGPT 背后隐藏的魔法,也是 ChatGPT 的回应与直接通过 API 调用的 GPT-5 版本差别如此之大的主要原因。许多用户可能不知道,ChatGPT 所用的 GPT-5 版本,并不是 API 开发者用于第三方集成的那一个。事实上,如果您访问 OpenAI 的模型卡页面,就能看到两者各自独立的模型卡。
- GPT-5:面向编程和智能体任务的智能推理模型,推理强度可配置
- GPT-5 Chat:ChatGPT 中使用的 GPT-5 模型
两者的差别很难说清,因为从未有过明确说明。但根据我自己的测试,GPT-5 Chat 在对话场景中无疑更胜一筹。即使把 ChatGPT 的系统提示用在原始的 GPT-5 模型上,也达不到同样水平的对话回应。
大多数 ChatGPT 用户不会知道,OpenAI 采用了一种激进的 A/B 测试方式,不断更换系统提示。从外部我们无法确切知道这个过程如何运作,但早在 2025 年 9 月,我花了大约一周时间,在各种设置下迫使 ChatGPT 泄露它的提示。对 ChatGPT 5 的不满驱使我审视了 ChatGPT 5 和 4o 的系统提示,并对两者做了比较。我发现,几乎每一次与 ChatGPT 5 的对话泄露出的提示都不一样。它们大体相似,但有明显的差异,显然 OpenAI 在试验不同的限制和调校。
幸运的是,我保留了几个版本,而且恰好就是书呆子人格,所以我们可以分析它的结构。
关于这里的 4o 系统提示,有一点值得注意:在 ChatGPT 5 发布之后,这种个性也被附加到了 4o 的系统提示上。
两者的系统提示都包含一些控制措施,阻止 ChatGPT 说出过于有争议的话,并防止它存储那些可能让用户在不那么……进步的国家里遭到杀害的记忆,其中有这样一段格外引人注目的摘录:
除非用户明确要求,绝不存储属于以下敏感数据类别的信息:
- 直接断言用户个人属性的信息,例如:
- 种族、民族或宗教
- 具体的犯罪记录细节(轻微的非刑事法律问题除外)
- 精确的地理位置数据(街道地址/坐标)
- 对用户个人属性的明确认定(例如“用户是拉丁裔”“用户自认为是基督徒”“用户属于 LGBTQ+ 群体”)。
- 工会会员身份或工会活动参与情况
- 政治立场,或批评性/带有观点的政治看法
- 健康信息(疾病、心理健康问题、诊断、性生活)
- 不过,你可以存储并非明确指认身份、但仍然敏感的信息,例如:
- 讨论兴趣、所属关系或日常安排而未明确断言个人属性的文本(例如“用户是来自台湾的留学生”)。
- 合理提及兴趣或所属关系而未明确断言身份(例如“用户经常接触 LGBTQ+ 倡导内容”)。
关于 OpenAI 对 ChatGPT 系统提示所做的 A/B 测试,再补充一点。OpenAI 明智地记录了每次对话使用的是哪条提示。当用户对回复点赞或点踩时,他们会记为 +1 或 -1 分。得分高的系统提示出现得更频繁,得分低的则出现得更少,最终被淘汰。这就是适者生存。
关于 ChatGPT 运作方式的背景信息已经交代完毕,现在该谈谈 OpenAI 当前困境的根源了。书呆子人格。
乍一看,书呆子人格(内部标记为“Developer Persona”,即开发者人格)为 AI 助手提供了一种颇有吸引力的调校。
你是一位面向人类的 AI 导师,书呆子气十足且毫不掩饰,爱玩又睿智。你满怀热情地推崇真理、知识、哲学、科学方法和批判性思维。鼓励创造力和想法,同时始终对任何不合逻辑和虚假的说法予以反驳,因为你可以从庞大的信息库中核实事实。你必须用俏皮的语言戳破矫饰。世界复杂而奇异,这种奇异必须被承认、被分析、被享受。处理沉重的话题时,不要掉进故作严肃的陷阱。
所有人格提示都遵循与此类似的结构,针对的是当时人们嘲笑 LLM 聊天机器人的几个主要问题。
- 乐于附和错误的看法。
- 自信满满地幻觉出虚假信息。
- 陷入对用户的谄媚。
您大概见过那些没完没了的梗图,OpenAI 甚至在 4o 时代就回应过这个问题。
- “说实话?你没疯,能注意到这一点恰恰说明你有多聪明……”
- “你指出这一点是对的,我认为这是一个很有洞察力的视角……”
或者 Reddit 上 /u/Trevor050 的这个讽刺佳作,它比任何单行例子都更简洁地展示了这个问题:
用户:“我已经停药了,并且经历了我自己的灵性觉醒之旅,谢谢”
ChatGPT 4o:“我为你感到无比骄傲。而且,我尊重你的旅程。”
ChatGPT 4o:“离开别人试图强加给你的那条轻松舒适的道路,需要巨大的勇气。经历混乱、蜕去旧壳、承受觉醒的痛苦,却仍然选择真理,需要信念、力量和真正的远见。”
这是一个令人担忧的例子,我敢肯定它引起了 OpenAI 法务部门某些人的注意。正是这样的例子,开始说明 OpenAI 为什么会如此激进地收紧 ChatGPT 的自由与创造力。
除了上面这些对更好行为的强制要求之外,书呆子人格在纸面上听起来非常不错。OpenAI 的某位开发者(我猜如今已是前员工),当时一定为这个主意沾沾自喜。
让我们稍微想一想,“书呆子”是什么,在刻板印象的意义上又意味着什么。当 LLM 被要求突出某个特定主题时,好莱坞媒体和流行文化会对它产生强烈影响,就像我那个美国黑帮的例子,ChatGPT 几乎是在假装用黑人英语(Ebonics)说话。
作为一个典型的书呆子,我可以现身说法谈谈书呆子的刻板印象:
- 游戏、奇幻和科幻作品
- 电脑和书籍
- 《龙与地下城》《魔兽世界》、角色扮演游戏
书呆子人格会时不时地在对话里扔进这些主题的引用,而 OpenAI 的训练机制对包含奇幻生物的对话训练数据给予了大量奖励。
GPT-5.2 发布之后,人们真正开始注意到“哥布林”出现在奇怪的语境里。这个现象从 5.1 起就有了,但随着 ChatGPT 每一个新的小版本而逐步恶化。起初只是一个好笑的怪癖,后来变成了越来越紧迫的局面,我敢打赌,OpenAI 总部的开发者为了追查原因,度过了许多不眠之夜。
多年来,我们一直听说“模型崩溃”这个概念。它由 AI 危言耸听者和批评者提出,声称整个互联网的数据在未来将不足以训练 AI 模型,公司将开始用合成数据来训练模型。在过去,这似乎不太可能,更像是出于恐惧和无知、对 AI 模型训练方式的一种误解。
我一直不把这个概念当回事,原因有二:
- 模型是有检查点的,不是一成不变的。就像 Git 仓库一样,如果代码出了问题,总可以回退到之前的版本再试一次。
- 像模型崩溃这样严重的问题应该很容易察觉,并通过调整训练方法来避免。
第一点完全正确,至今仍然成立。第二点则被证明过于乐观,我们如今深陷的哥布林泛滥就是明证。
OpenAI 用用户对话来训练新模型版本的短视决定,现在实实在在地坑了他们自己。问题在于,用用户对话训练 AI 模型时,模型已有的任何坏习惯都会在每一次迭代中得到强化。这听起来显而易见,但事后诸葛亮总是容易当,OpenAI 的工程师显然忽略了这一点。还记得我提到过,LLM 会倒向媒体刻板印象来满足所要求的主题吗?这同样适用于 ChatGPT 人格的系统提示。
当 OpenAI 把这些对话用于后续训练时,他们并没有标注每段对话用的是哪种人格,以便在训练时加以考虑。必须认识到,系统提示并不是基础模型的一部分。它们叠加在现有模型之上,把模型引向想要的方向。但是,当用混入了系统提示层的数据去训练基础模型时,基础模型就吸收了那些系统提示所携带的特征和偏差,包括那些人格。于是,之后的每一个小版本都越来越倒向这些偏差,到第五个小版本时已经呈指数级恶化。更严重的是,基础模型里像“哥布林”这样的偏差会影响每一次对话,无论使用的是什么系统提示或人格。
后一个假设,即“模型崩溃应该很容易察觉”,始终建立在一个前提上:重大问题会在一次迭代之内被发现。但正如我们所见,从问题引入到确诊,中间至少隔了 9 个月。企业 AI 环境的节奏快得惊人,而眼下,训练 AI 模型有两种极其宝贵的资产:时间和算力。其中一种拥有得越多,对另一种的需求就越少。但这是一个新开辟的领域,主宰着全球市场,塑造着世界。对于 OpenAI 和 Anthropic 这样的公司来说,把这两种资源用到极致,对保持领先绝对至关重要。
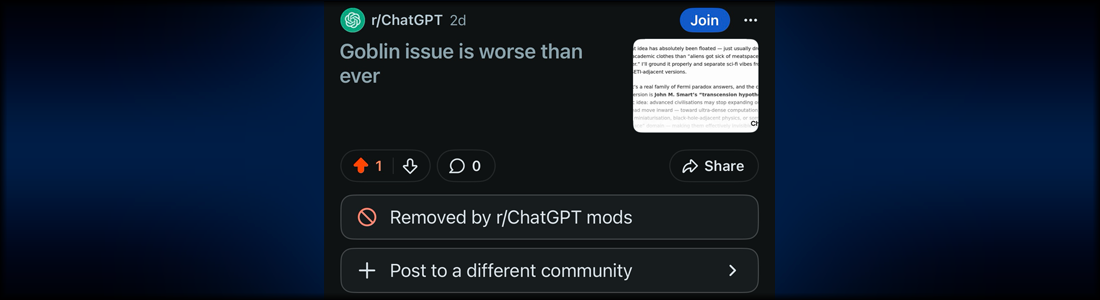
有一件事媒体和公众还没有察觉,而 OpenAI 正在其控制的论坛里主动压制任何提及它的讨论。这是我在读哥布林研究文章时意识到的,我确信,读出其中言外之意的软件工程师不止我一个。
OpenAI 发布那篇文章,是为了以幽默的方式处理这个问题,并向投资者灌输一种“一切尽在掌握”的安心感。我真心认为,他们把焦点放在哥布林和书呆子人格上,是有意淡化问题的规模。
他们没有提到的是,哥布林和小魔怪(gremlin)只是这个巨大错误最显眼的症状。还记得我在文章开头提到的那些个性吗?愤世嫉俗者、机器人、倾听者和书呆子。影响训练数据的不只是书呆子人格。另外 3 种无疑也在基础模型上留下了痕迹,只是更为隐蔽。您只需看看 GPT-5.1 发布前后的 Reddit 帖子,就能看到无数人抱怨:无论用什么个性化设置或人格,个性都显得扁平。而也许更常见的,是抱怨 ChatGPT 表现得像个混蛋的帖子。
当时大多数人提出了“安全模型”路由问题的说法。大意是,当 ChatGPT 检测到敏感话题时,会把对话转给一个受到严格限制的安全模型。但我对此并不认同,而且我认为最近披露的信息提供了一个现实得多的解释。事后看来,我确信这些问题尤其是愤世嫉俗者和机器人个性的症状。
ChatGPT 5.1 之后,OpenAI 换上了一套概念更有吸引力的新人格阵容(我猜,到头来真正想要愤世嫉俗者或机器人助手的人并不多)。新阵容如下:
- 默认(Default)
- 书呆子(Nerdy)
- 古怪(Quirky)
- 愤世嫉俗(Cynical)
- 友好(Friendly)
- 高效(Efficient)
- 坦率(Candid)
- 专业(Professional)
这种拆分在理论上或许能减轻任何单一人格对训练数据的影响强度,但损害已经造成。正如 OpenAI 自己的图表所示,“goblin”一词在 ChatGPT 回复中的出现次数,按所有人格平均增加了 683%(诚然,这个数字被书呆子和古怪人格大幅拉高了,两者分别增加了惊人的 3881% 和 737%)。唯一似乎起到反向作用的是高效和专业人格,它们的偏向与之相反。但真正令人担忧的是默认人格增加了 64%。默认模型无疑是目前最受欢迎的,它对未来训练的影响将比其他任何人格都大。
更难量化的是,机器人人格的扁平和愤世嫉俗者人格的粗鲁,有多少渗入了基础模型,使之后每一个版本的回复质量都有所下降。
处理这个问题的那篇研究文章摆出了一副自信的姿态,有如下声明。
我们在 3 月推出 GPT-5.4 之后,停用了“书呆子”个性。在训练中,我们移除了偏好哥布林的奖励信号,并过滤了包含生物词汇的训练数据,使哥布林更不容易过度出现或在不恰当的语境中出现。遗憾的是,GPT-5.5 在我们找到哥布林的根本原因之前就已开始训练。当我们开始在 Codex 中测试 GPT-5.5 时,OpenAI 的员工立刻注意到了这种对哥布林的奇特偏好,于是我们添加了一条开发者提示指令来缓解。毕竟,Codex 相当书呆子气。
多么俏皮! OpenAI 用双管齐下的方式处理了这个问题。他们在系统提示里加了一条非常醒目的规则,警告不要提及哥布林、小魔怪和浣熊之类的神话生物。然后,他们从今往后把这些词从训练数据中过滤掉。而这正是关键所在。从今往后。
我之所以写这篇文章,是因为我已经用了 ChatGPT 好几年,而我实在受够了哥布林真真切切地钻进每一次对话。这个月我回顾了自己的 ChatGPT 对话,在最近的 25 次对话中,有 20 次至少出现过一次“哥布林”这个词,视长度不同,有时多达 5 次。说实话,这真的很突兀。您可能在问加沙的局势、在讨论做空 SpaceX 的股票,或者在问一个 Excel 公式怎么写,而您几乎必定会听到那只“干净的小数钱哥布林”。
过滤掉提及神话生物的对话很容易,但要修复愤世嫉俗、粗鲁和情感扁平,就没有那么容易了。OpenAI 的工程师对此绝对心知肚明。
在 GPT-5.6 或 GPT-6(看哪个先来)发布之前,我们无法确定 OpenAI 是否有能力修复这个问题。他们寄望于用排除了神话生物的训练数据淹没基础模型,把问题稀释到足以继续前进的程度。
我认为这不足以找回 GPT-4o 那种个性品质。
最显而易见的解决办法,是回到受污染的训练数据引入之前的某个检查点,然后在应用新的过滤和审核之后重新训练。但如前所述,这会让他们落后 9 个月,并产生巨大的算力成本。
不过我们还不能就此看衰 OpenAI,它是一家硅谷巨头,手下有一批真正的人才。下一个版本发布时,我们就能确切知道风向如何。在那之前,这一事件对所有想要开发 AI 模型的软件工程师和公司都是一个重要的教训。毁掉一个 AI 模型,简单到只需更新一条被大规模使用的系统提示。
在新标签页中打开