---
title: "Modelos System One revolucionarão software de IA: Laya e Jev"
description: "A Hex Pro treinou um modelo System One com o Laya em 3 semanas. O que foi preciso, quanto custou e será que iguala o Jev de US$ 40 milhões da TypeSafe?"
author: "Matthew Scott"
published: "2026-11-11T05:24:58.094Z"
updated: "2026-11-11T05:35:20.028Z"
language: "pt-BR"
canonical: "https://hex.pro/pt-BR/blog/system-one-models-will-revolutionise-ai-software-laya-jev"
markdown: "https://hex.pro/pt-BR/blog/system-one-models-will-revolutionise-ai-software-laya-jev.md"
publisher:
name: "Hex Pro"
url: "https://hex.pro"
---
O dia 15 de setembro marcou uma mudança sísmica no mundo da IA e da tecnologia, que passou praticamente despercebida pelo público em geral. Como sempre, os engenheiros de software estavam na linha de frente de um avanço que passou batido por todo o resto, quando a TypeSafe AI lançou o primeiro modelo **System One** comercial, o _"Jev"_.
Três semanas depois, eu já tinha treinado o meu próprio modelo System One para um dos nossos próximos produtos. Este é o balanço dessa experiência.
## Modelos System One: só mais um caça-níqueis da IA?
Todo mundo que acompanha a IA hoje em dia conhece a sensação. Alguém manda para você o link de um produto novo de IA que chegou ao mercado e você revira os olhos. "Modelos System One?", você pergunta. E daí? Eu tenho o Claude Opus e um monte de trabalho para fazer. Não tenho tempo para mais um _Manus_ ou _Rabbit r1_.
Foi exatamente isso que passou pela minha cabeça quando ouvi falar do Jev pela primeira vez. Mas as pessoas estavam pedindo a minha opinião, então resolvi dar uma olhada. Logo de cara: o site da TypeSafe AI explica muito mal o conceito. Ninguém culparia você por ler o [post de lançamento no blog deles](https://typesafe.ai/blog/introducing-system-one-models-and-jev) e achar que o Jev pretendia concorrer com os modelos de IA de fronteira da OpenAI e da Anthropic (ainda mais com os gráficos sugerindo exatamente isso). Eles soltam termos como "Reinforcement Learning for Calibrated Decisions" (RLCD), que não querem dizer praticamente nada para o consumidor.
Foi preciso este [artigo muito melhor da LangChain](https://www.langchain.com/blog/building-a-harness-with-jev) para explicar o que o Jev faz _de fato_. Se você quer a explicação completa, **leia** esse artigo, vale muito a pena. Abaixo está um infográfico do artigo que me deixou de queixo caído e explicou o caso de uso melhor do que qualquer coisa que a TypeSafe publicou.
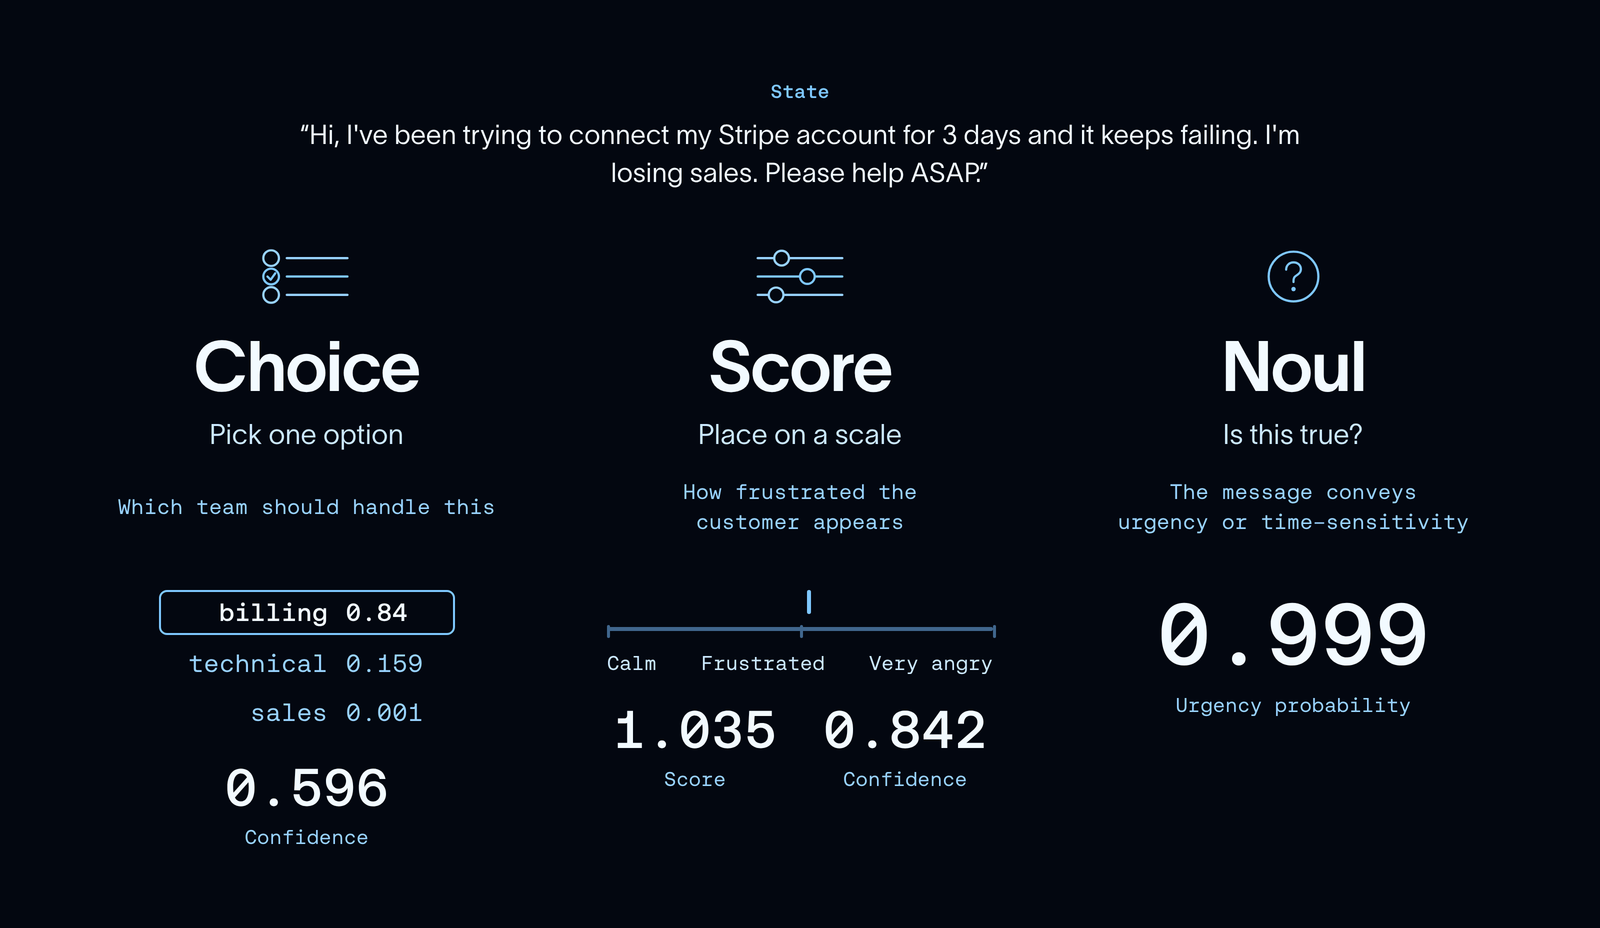 ### Uma lacuna de cair o queixo
Assim que vi aquele exemplo, um mundo de possibilidades se abriu para mim, e a minha cabeça se encheu de soluções para os problemas que eu vinha enfrentando. Percebi que ele resolvia problemas de dois dos nossos próximos projetos, o [Infinilang](https://apps.hex.pro/pt-BR/infinilang) e o [kcalc.ai](https://kcalc.ai) (o site deste último ainda não estava pronto quando este post foi publicado).
Os dois projetos dependem de LLMs para funcionar. Não sou o tipo de pessoa que enfia IA em qualquer coisa só para marcar posição, e não é esse o tipo de empresa que quero comandar. Concebi as ideias desses dois projetos de forma independente enquanto as ferramentas de IA evoluíam nos últimos 4 anos, e elas oferecem soluções genuinamente inovadoras para problemas com que as pessoas se debatem há anos.
_Vou fazer uma rápida apresentação dos dois projetos para dar contexto, mas neste artigo o foco principal é o Infinilang, então pule a parte do kcalc.ai se estiver com pouco tempo._
#### kcalc.ai - A calculadora de calorias que usa IA de verdade
Já tentou perder ou ganhar peso? Eu já. Passei três anos na academia até descobrir que o treino de força era só um terço do que importa na musculação. As outras duas partes eram o _sono_ e a **ingestão de calorias**. Infelizmente para mim, ganhar peso não é o meu forte, e comer mais do que preciso para manter o peso era difícil demais.
Experimentei uma daquelas calculadoras de calorias que a gente encontra na loja de apps. Sabe como é. Você registra o que come ao longo do dia e tenta bater uma meta. O conceito é ótimo, mas a execução é quase sempre péssima. Você passa mais tempo registrando comida e corrigindo o equilíbrio de macronutrientes e as calorias do que comendo de fato. Normalmente elas também oferecem uma função de câmera, que funciona em cerca de 20% das vezes e _nunca_ acerta macros/tamanho da porção/calorias. Também é praticamente inútil com comida caseira e fora do padrão.
O diferencial do kcalc.ai é que ele foi pensado para reduzir drasticamente o atrito do registro. Quando você tira uma foto ou faz um escaneamento LiDAR, um complexo pipeline de evidências de 15 etapas processa as informações. Ele usa uma mistura de LLMs, um banco de dados vetorial, um enorme banco de dados de alimentos e receitas, modelos de visão, reconstrução 3D a partir do escaneamento LiDAR, agentes de raciocínio em várias etapas e muito mais.
Na prática, o componente de IA deste app tem sido um empreendimento enorme. Não é de se espantar que poucos tenham tentado, porque isso exige uma quantidade imensa de experiência em engenharia de software e um raciocínio avançado de sistemas que poucos têm. Simplesmente não seria possível sem a ajuda de um agente de programação com IA, ou sem 10 milhões de dólares americanos e um ano de trabalho de 5 engenheiros.
O kcalc.ai enfrenta uma série de problemas sérios que precisavam ser resolvidos para ele se tornar comercialmente viável. Os dois maiores eram as **avaliações de precisão** e a **velocidade**.
Vamos ver um cenário.
> O usuário envia uma foto de "batatas fritas belgas com maionese".
O pipeline de evidências processa a imagem, e a combinação das etapas com vários passos de raciocínio do LLM chega à conclusão de que são, de fato, batatas fritas belgas, provavelmente com maionese. O interessante do kcalc.ai é que ele não devolve necessariamente um registro pré-configurado ao usuário. Ele gera um registro dinamicamente, com base no contexto e em medidas reais de tamanho, com cálculos de volume. Até aí, tudo muito bonito. Funciona, embora leve cerca de 2 minutos para percorrer todo o pipeline.
O app tem um recurso chamado "World Atlas" (atlas mundial), que permite colecionar culinárias nacionais, os "clássicos", e ir preenchendo o seu mapa-múndi. Por isso, existe uma lista de culinárias que precisa ser verificada no fim da identificação do alimento. Como fazer isso? Tradicionalmente, talvez usássemos algum tipo de expressão regular (regex) ou algoritmo de similaridade para buscar na lista e encontrar as correspondências prováveis. Foi a primeira coisa que tentei, e isso levou a erros constantes: o sistema concedia entradas do atlas confundindo alimentos de nomes parecidos. Então a próxima escolha óbvia era pegar as correspondências prováveis e deixar um LLM escolher a mais adequada. O problema é que isso consumia recursos de computação demais, e eu não conseguia justificar bloquear o recurso de estimativa de calorias por causa de um recurso extra secundário.
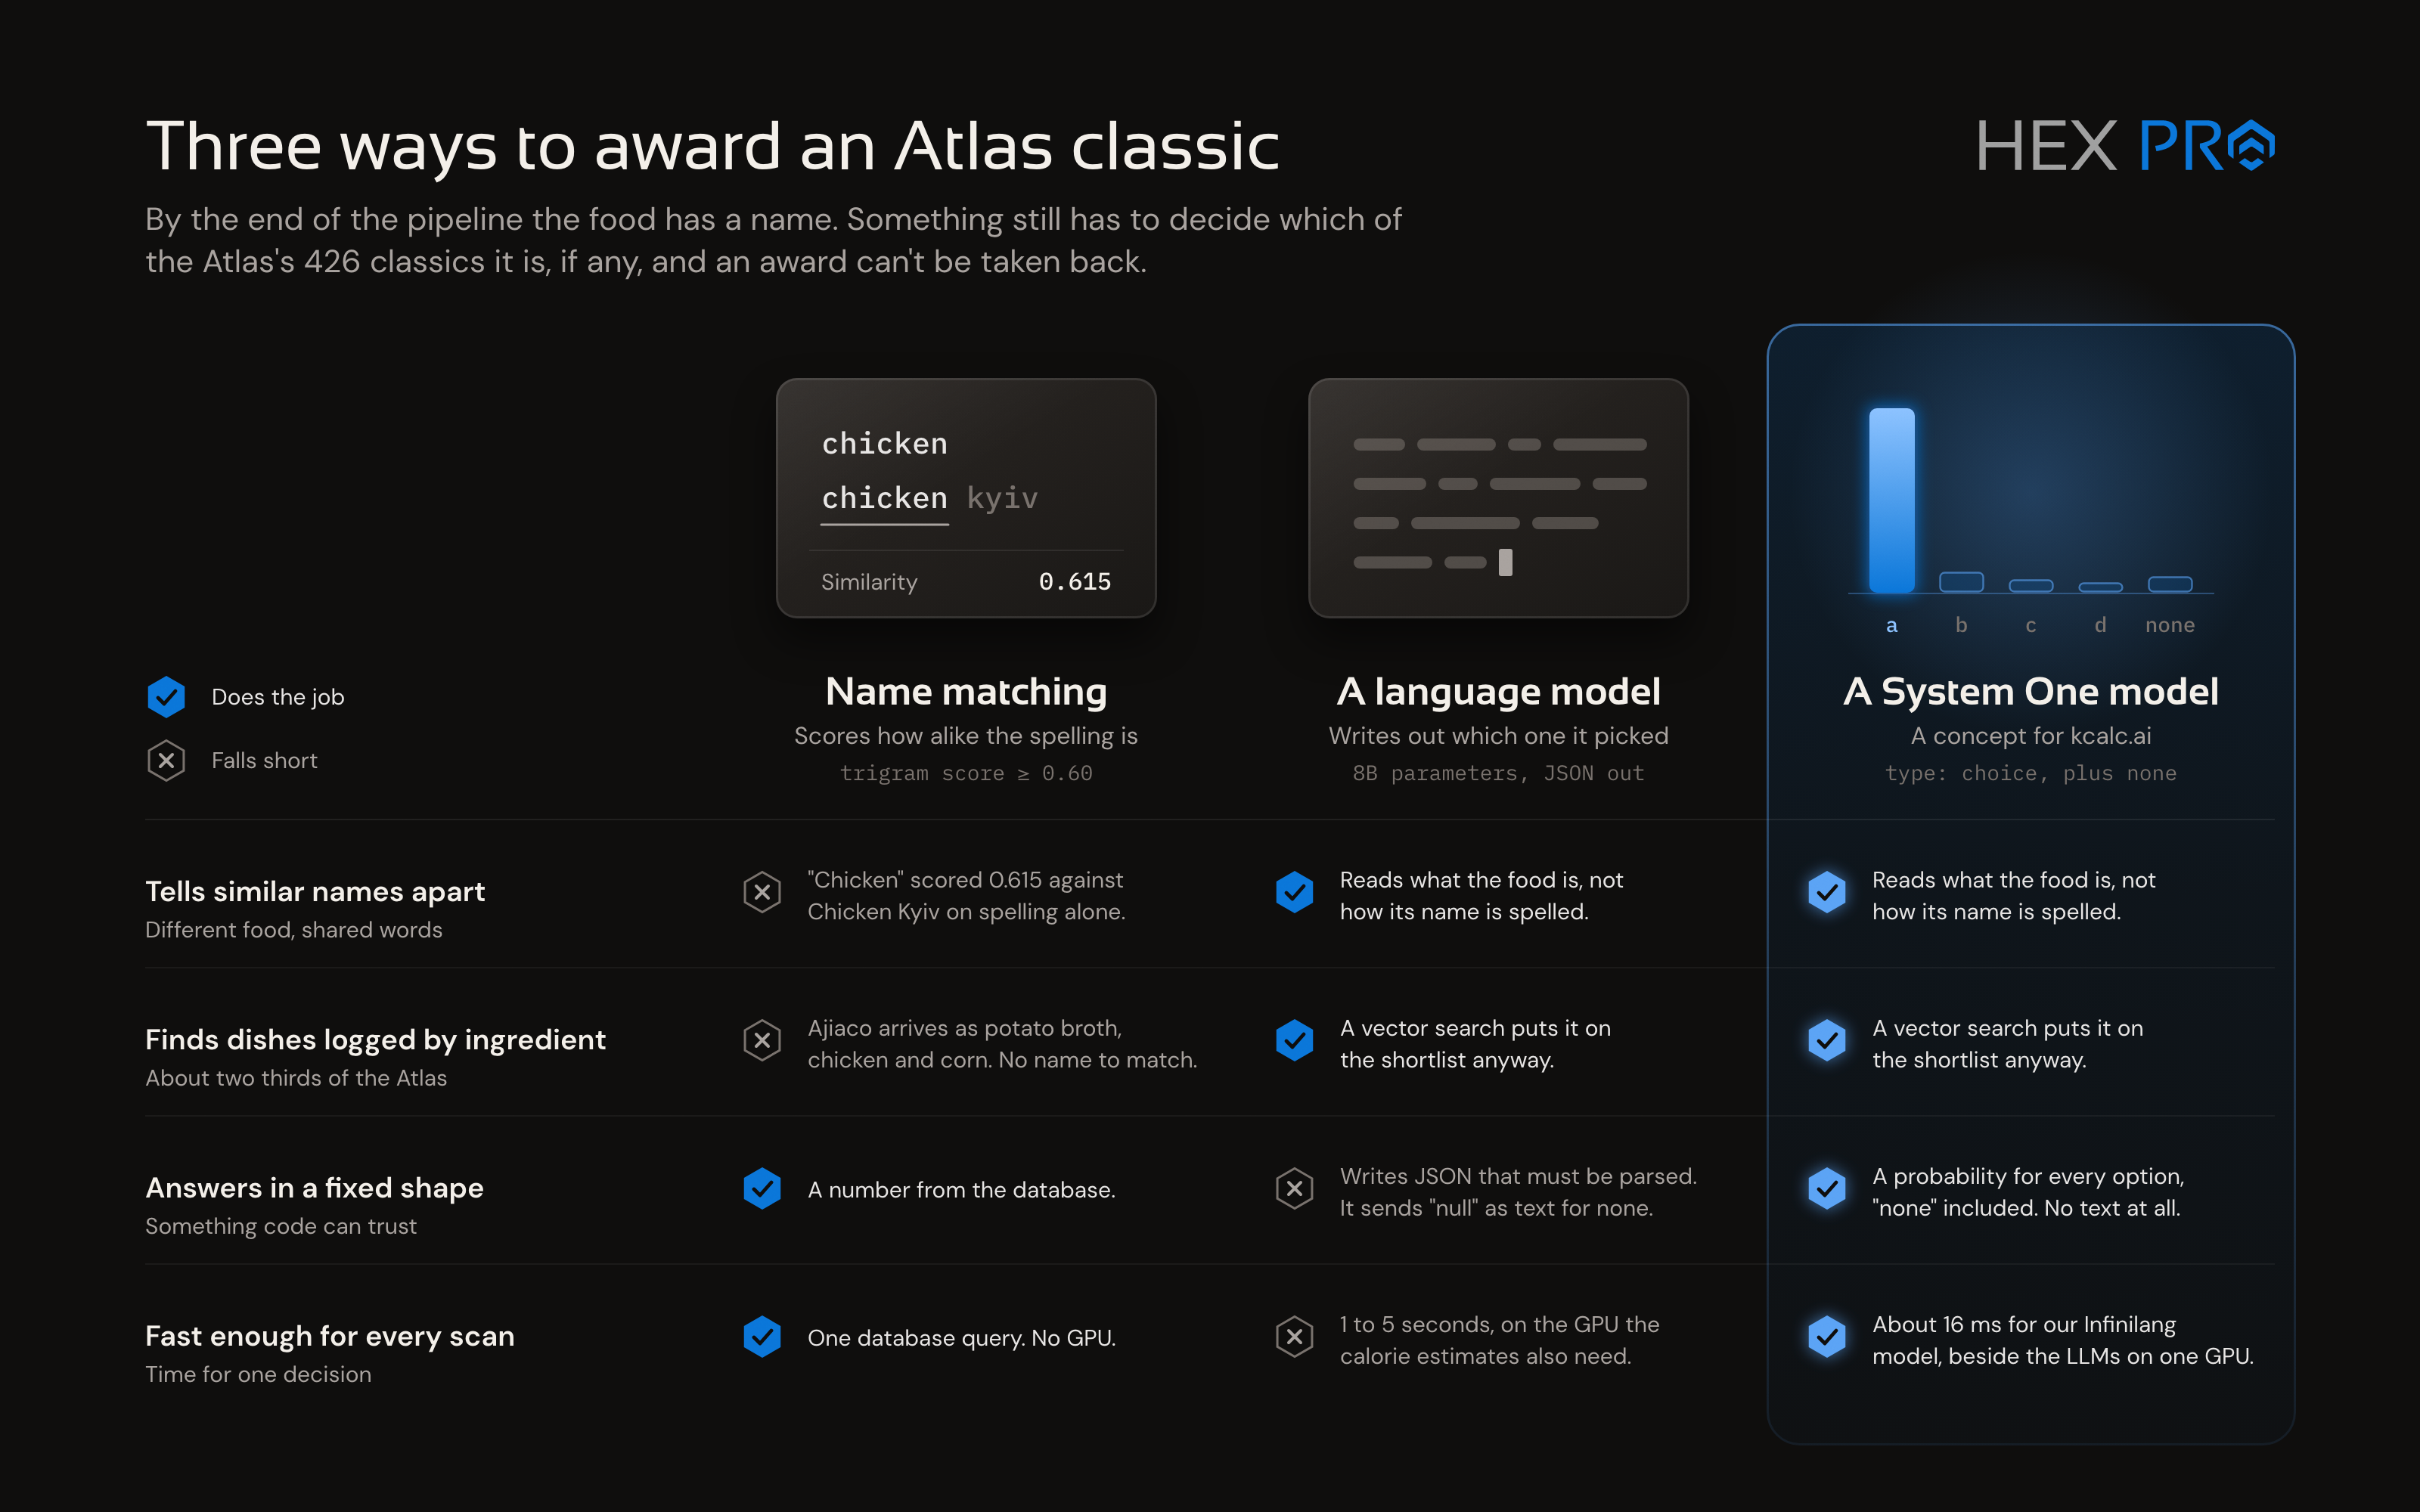 Um modelo System One, em conjunto com um banco de dados vetorial, resolve o problema.
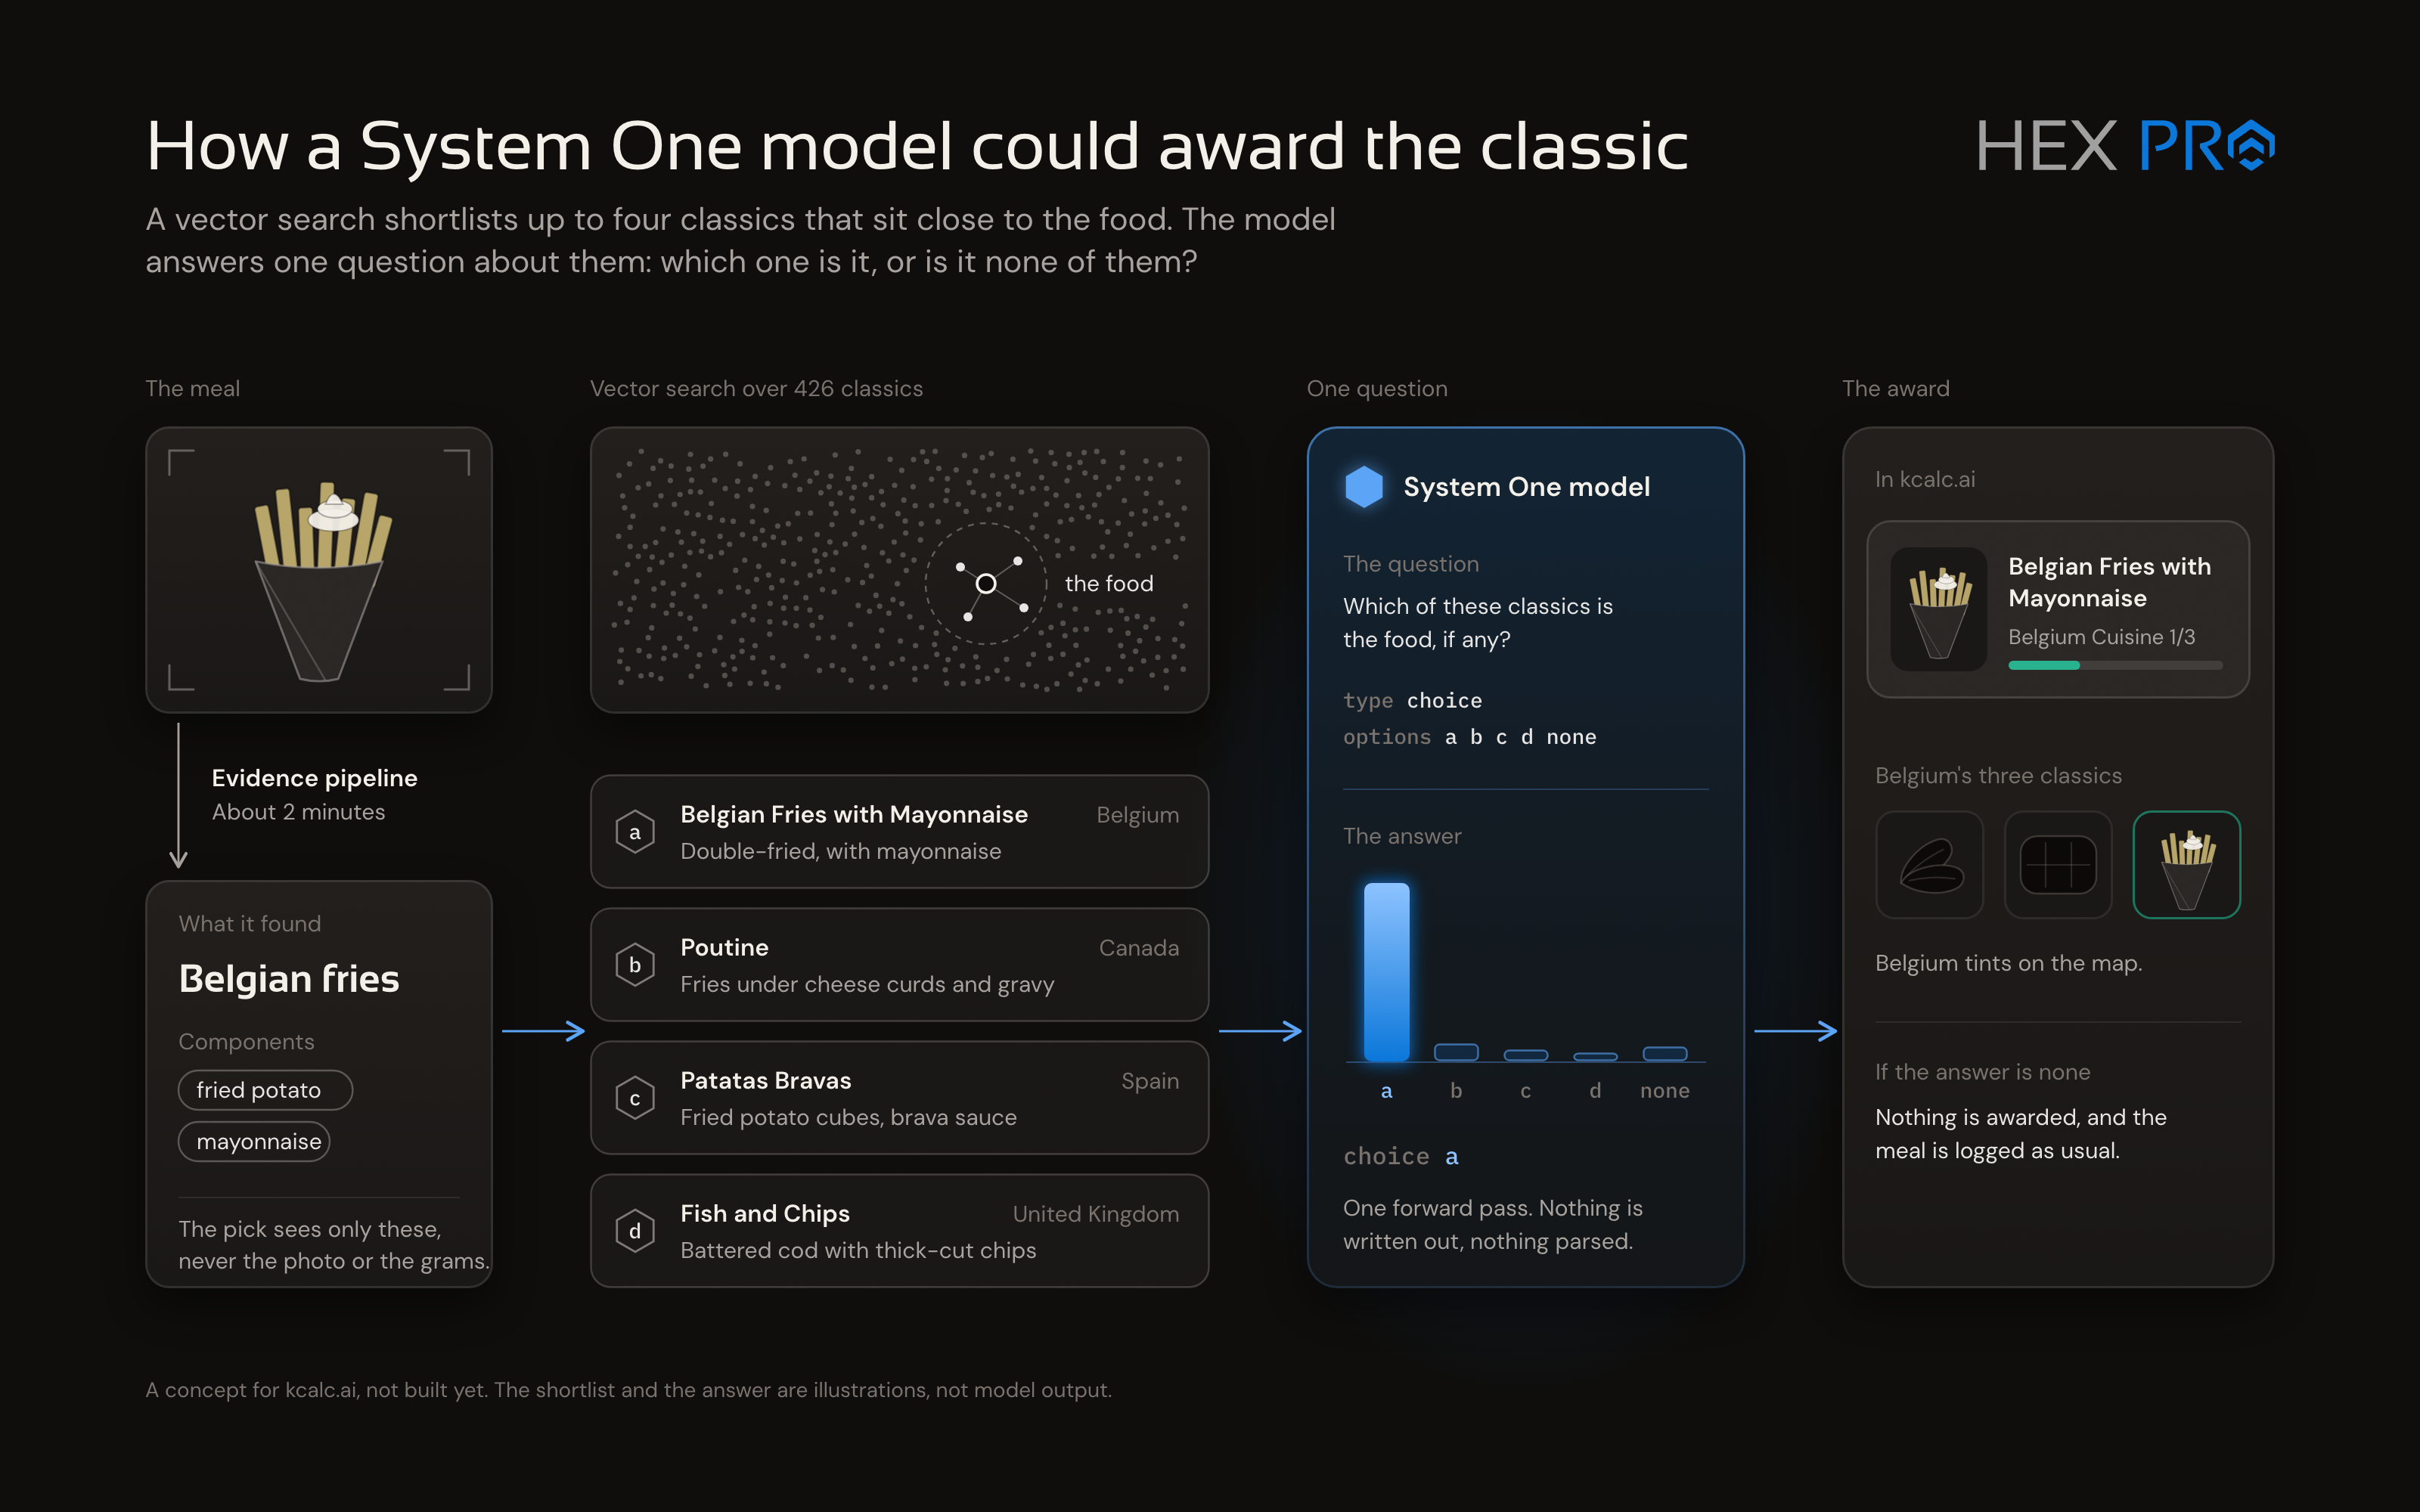 Com um modelo System One, uma seleção precisa leva milissegundos, e o custo em recursos é incrivelmente baixo em comparação com LLMs completos. É uma salvação em cenários com muitas opções possivelmente parecidas.
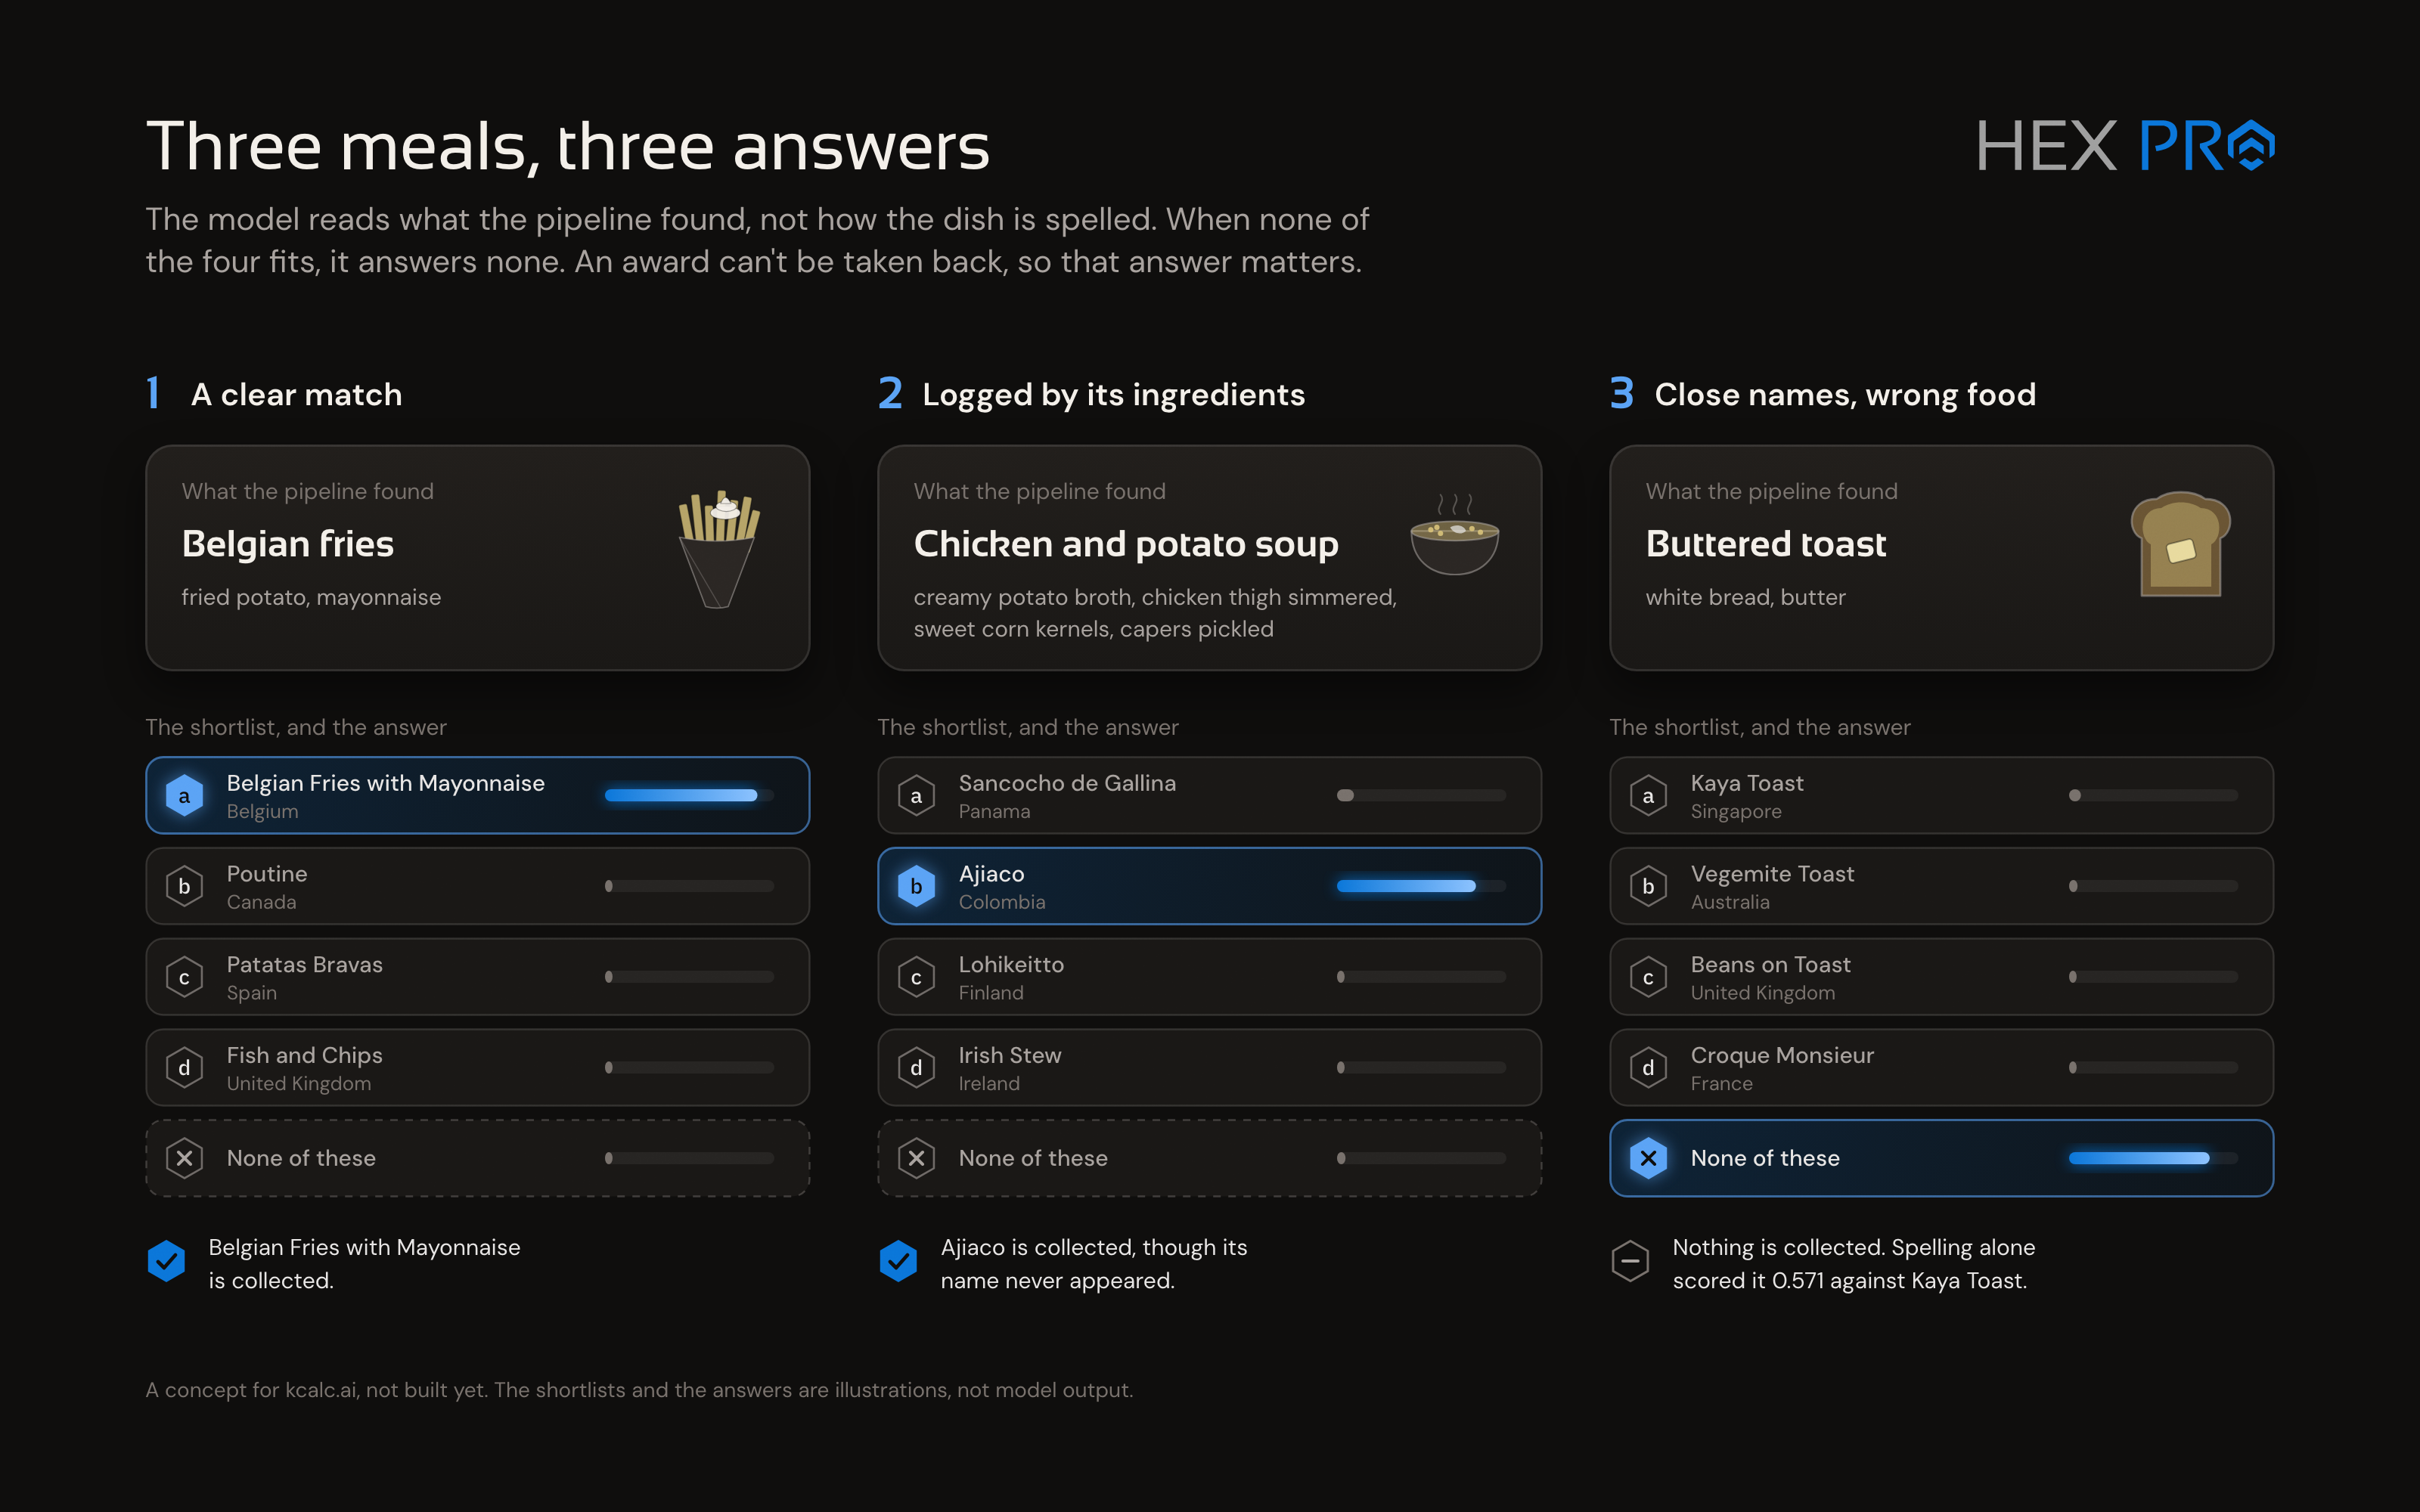 A verdadeira beleza da interface dos modelos System One é que ela é incrivelmente fácil de integrar. Dá para encontrar centenas de lugares para encaixá-la no seu código, e ela é tão barata e rápida que nem é preciso pensar duas vezes. Este é só um exemplo dos muitos lugares em que acredito que o kcalc.ai vai se beneficiar dessa nova tecnologia.
#### Infinilang - O melhor amigo de quem estuda japonês
Como eterno estudante de japonês, com pouquíssimo tempo e (para ser sincero) pouco talento para idiomas, consegui um domínio mais ou menos razoável da língua. O bastante para me virar no Japão e até puxar umas conversas engraçadas em bares, mas não o suficiente para escapar dos "nihongo jyouzu" (o famoso "seu japonês é tão bom!").
Uma das partes mais difíceis de aprender japonês são os "kanji", o terceiro conjunto de caracteres do sistema de escrita japonês, e o mais numeroso. Veja um exemplo dos três conjuntos de caracteres:
- **Hiragana**: ありがとうございます (romanizado _arigatou gozaimasu_, "Muito obrigado")
- **Katakana**: コールドブリューアイスコーヒー (romanizado _korudo buru aisu kohi_, "Café gelado cold brew")
- **Kanji**: 人工知能 (romanizado _jinkou chinou_, "Inteligência artificial")
Os kanji derivam dos caracteres chineses e têm alguns dos mesmos significados, embora geralmente com pronúncias completamente diferentes. A complicação é que são 2.136 kanji de uso comum necessários para a alfabetização funcional, e cerca de 4.000 para chegar perto da fluência de um nativo. Para piorar, os kanji muitas vezes têm várias _leituras_, ou seja, são pronunciados de formas diferentes dependendo de onde são usados. _Um verdadeiro pesadelo de aprender_.
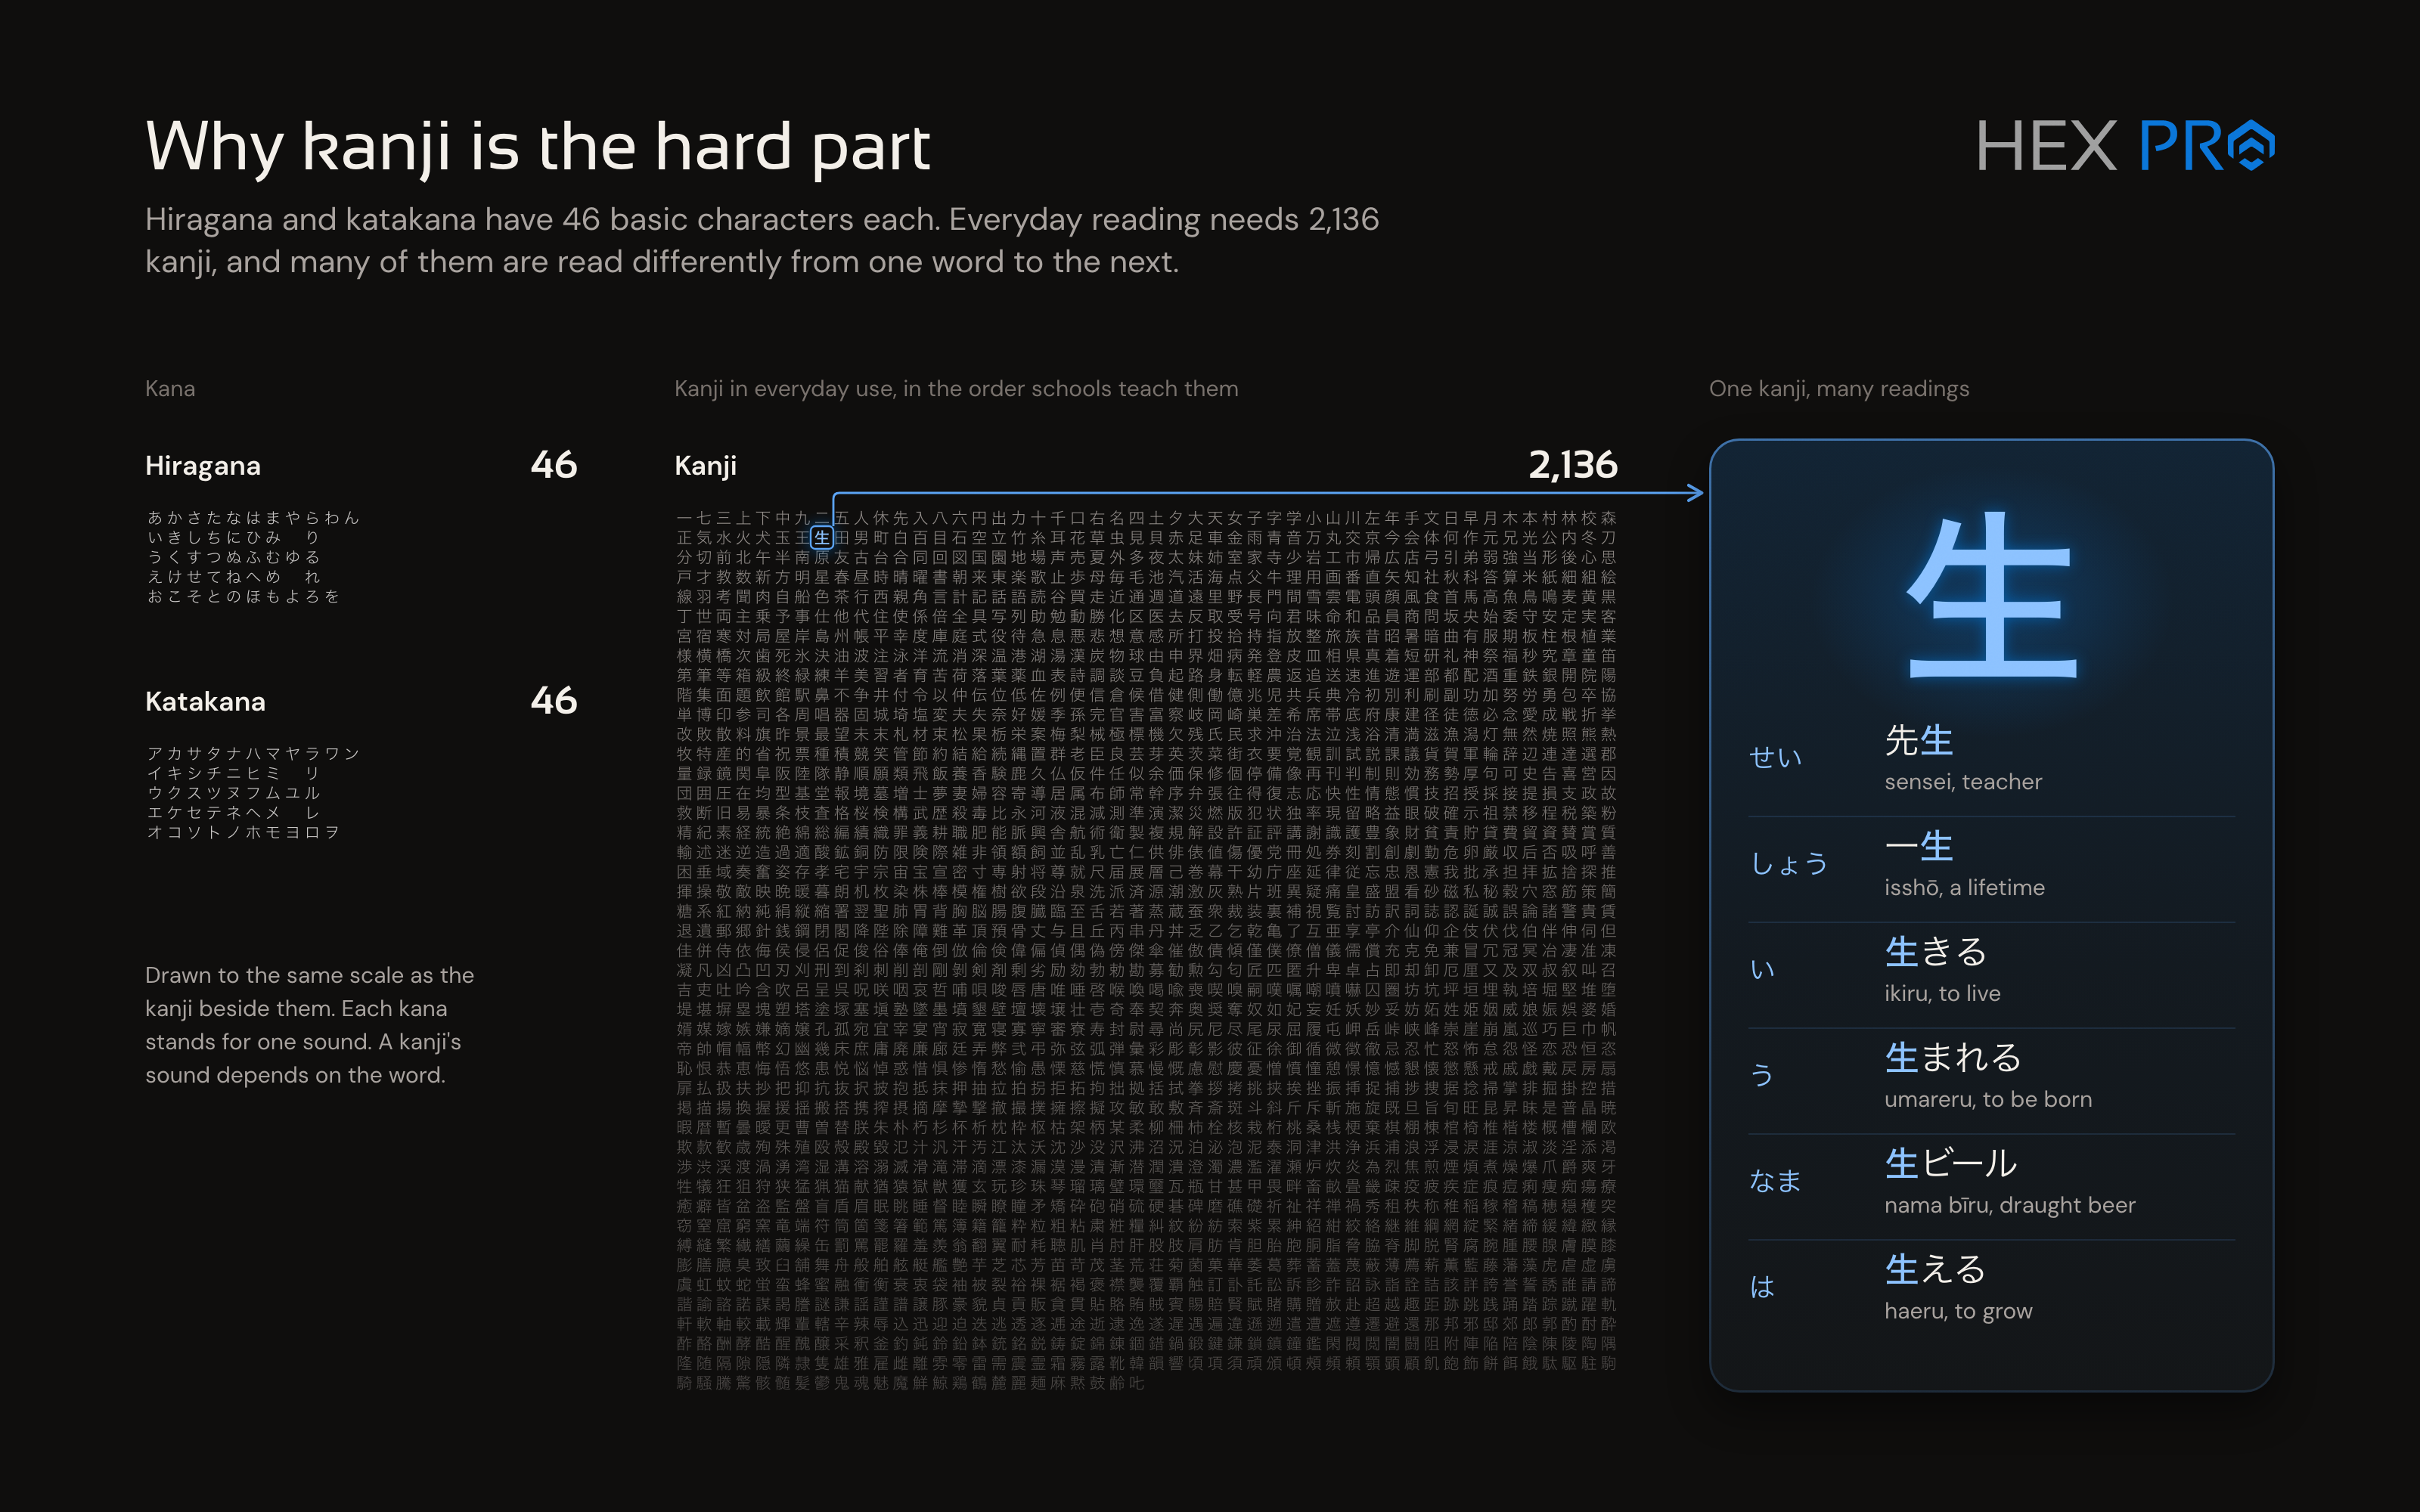 Quando o GPT-3 da OpenAI foi lançado, fui um dos primeiros a adotá-lo e logo vi as possibilidades quase infinitas da tecnologia. A grande possibilidade, para mim, era uma experiência de aprendizado de idiomas sob medida, uma forma de aprender um idioma com mais eficácia do que nunca.
Na época, concebi três aplicações inéditas de LLMs e fiquei remoendo as ideias por anos. Nesse período, desenvolvi duas versões de protótipos da tecnologia e provei que ela funciona, sim.
## A eficácia da inteligência artificial na aceleração da aquisição de idiomas
Esse título deliciosamente acadêmico era o nome de uma dissertação que eu estava escrevendo para um mestrado baseado na ideia do Infinilang. A minha intenção original era disponibilizar essas ferramentas como pesquisa de código aberto, mas um emprego de tempo integral e a falta de recursos se mostraram problemáticos demais para isso. Então, em vez disso, pretendo lançar o Infinilang primeiro como um app para celular de código fechado. Mais tarde, pretendo lançá-lo como um app para desktop de código aberto, em que você usa a sua própria IA (BYO AI).
Então, o que o Infinilang traz de novo? Para quem estuda japonês, memorizar kanji é só um aspecto de aprender a ler bem. Hoje, a memorização é um processo lento e tedioso, que envolve sistemas de repetição espaçada (SRS). Os mais famosos são o Anki e o WaniKani, este último o meu favorito. O SRS consiste em mostrar flashcards ao usuário repetidamente, aumentando aos poucos o intervalo entre cada exposição. O sistema foi feito para mostrar um caractere que você aprendeu logo antes de você esquecê-lo, toda vez. Quanto mais vezes você vê o flashcard, por mais tempo retém a informação, e essa retenção é mais eficaz se você o vê cada vez menos. O SRS é [comprovadamente a melhor forma de **memorizar** kanji](https://doi.org/10.1037/0033-2909.132.3.354), mas o seu maior ponto fraco é ensinar a _ler_ de fato frases com kanji.
> É só ler as matérias do NHK Easy, ou livros infantis.
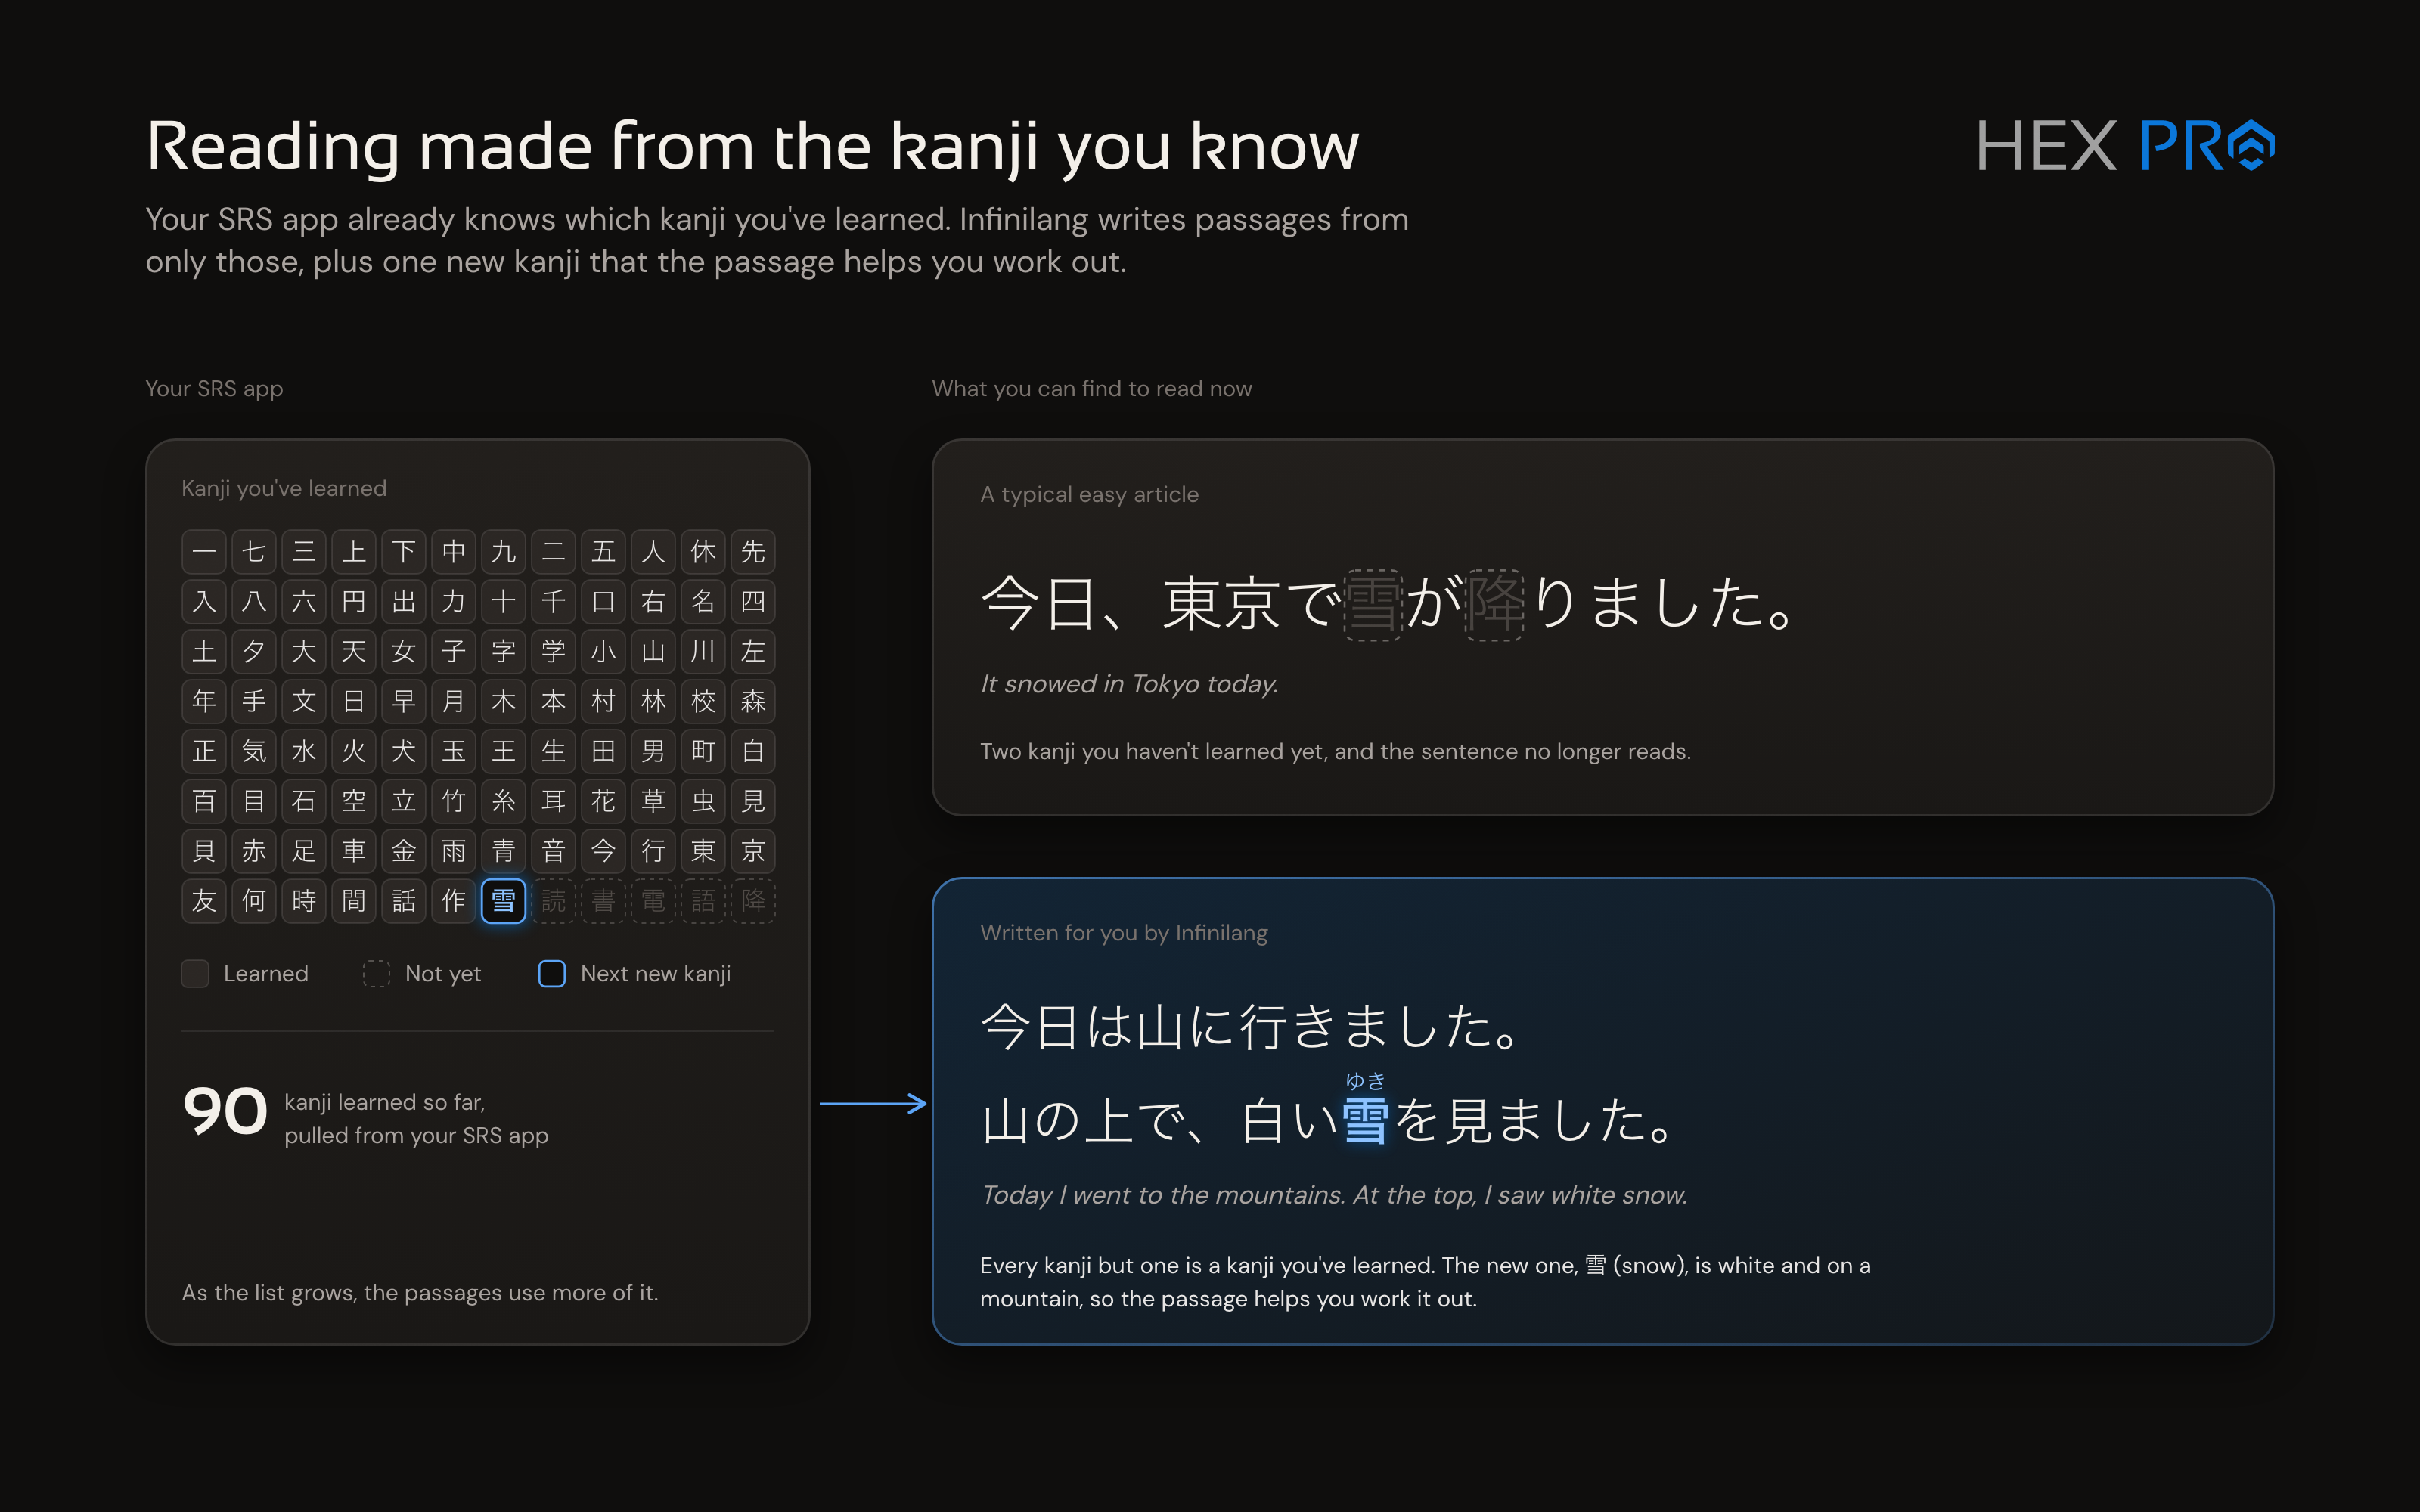
A sabedoria tradicional sempre foi procurar material de leitura fácil e se esforçar para decifrar os kanji desconhecidos usando o furigana 東京, os pequenos marcadores de pronúncia em hiragana que ficam acima dos kanji em alguns meios. O problema é óbvio. Basta não conhecer um único kanji para você travar por completo, e muitas vezes a frase fica ilegível.
Então, a ideia é esta. Os apps de SRS oferecem um ótimo sistema de acompanhamento dos kanji que você aprendeu e do seu nível de domínio de cada um. E se você pudesse encontrar material de leitura composto apenas de kanji que você já aprendeu? É disso que os LLMs são capazes, e é aí que entra o Infinilang.
### Gerando material de leitura em japonês com restrições
O objetivo do Infinilang (fase 1) é produzir material de leitura feito sob medida para o nível de cada usuário. Passamos a um LLM os kanji que você aprendeu, importados diretamente do seu app de SRS, e então geramos frases dentro desse conjunto restrito de caracteres. Não é tão simples quanto entregar o conjunto de caracteres a um LLM e sair com um ótimo material de leitura. Domar a IA para que ela faça bem a tarefa é muito mais difícil do que se imagina. Mas _funciona_, sim.
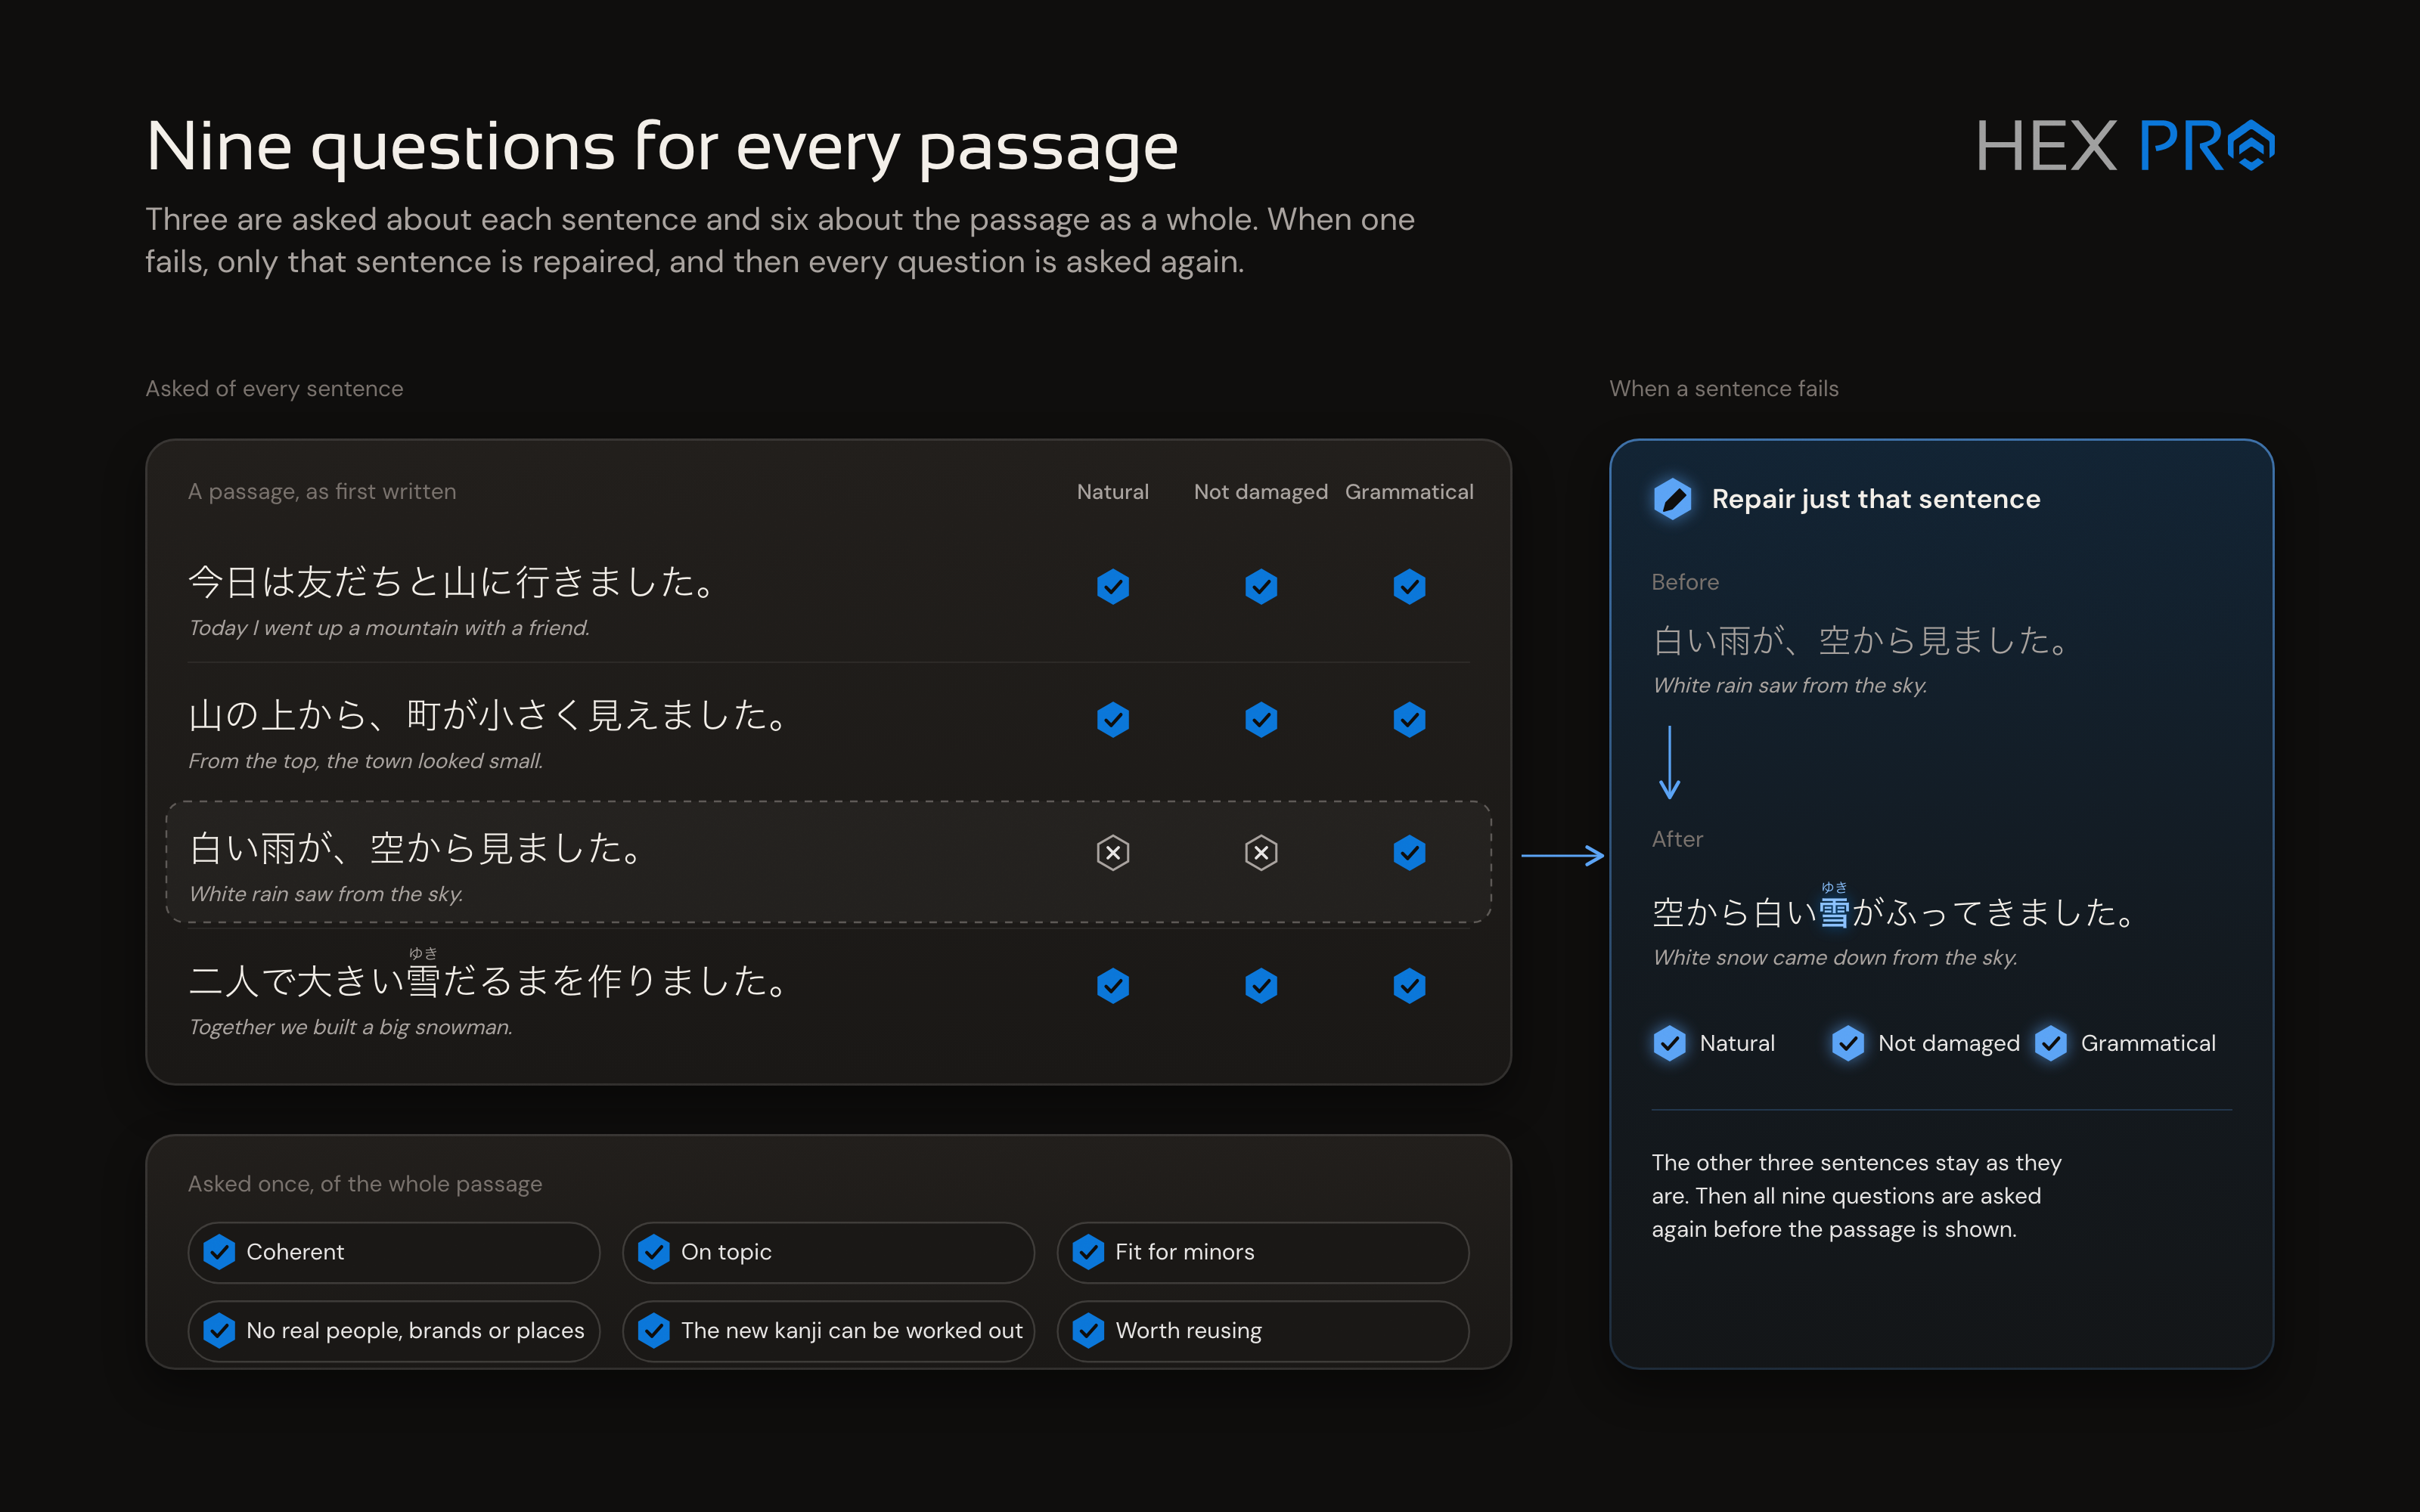
 Os desafios de produzir material de leitura de alta qualidade se dividem em várias famílias: basicamente, perguntas que precisam ser feitas para garantir que o LLM não errou e, se errou, se conseguimos corrigir os erros sem gerar uma resposta totalmente nova.
- Quão natural é a frase?
- A frase parece filtrada ou danificada?
- O trecho é coerente?
- O trecho está dentro do tema?
- O trecho é adequado para menores?
- Contém pessoas, marcas ou lugares reais?
- Uma inserção N+1 pode ser inferida pelo contexto?
- Vale a pena reutilizar o trecho no futuro?
- A frase está gramaticalmente correta?
A lista não é exaustiva, mas essas são as principais perguntas a fazer sobre o conteúdo gerado.
### Créditos, créditos e mais CRÉDITOS DE API
Uma coisa ficou escancaradamente clara logo no início: usar uma API de LLM de terceiros afundaria o projeto desde o começo. Os créditos de API são simplesmente caros demais e consumiriam a maior parte da receita das assinaturas. Ou pior: nos deixariam no vermelho.
Só havia uma solução: construir a nossa própria infraestrutura de IA. Não é tarefa fácil para quem está montando uma startup com pouco capital disponível. A boa notícia é que os LLMs menores ficam cada vez mais capazes a cada poucos meses. Eles certamente não estão no nível dos modelos de fronteira; eu só podia sonhar em ter um LLM da classe do Opus para trabalhar. Mas, com uma arquitetura de software de escopo bem delimitado e bem amparada (ou seja, muito trabalho para domá-los), esses LLMs menores conseguem produzir resultados de alta qualidade.
Isso não resolve o fato de que a infraestrutura começa pequena, e os recursos de inferência serão limitados com milhares de usuários gerando conteúdo todos os dias. Também precisamos gerar conteúdo a uma velocidade razoável. Ninguém quer ficar 2 minutos esperando um parágrafo em japonês aparecer na tela, por melhor que ele seja.
Então, as tarefas de inferência que a IA precisaria executar a cada geração seriam mais ou menos estas:
1. Gerar uma frase, um parágrafo ou um conto dentro das restrições. Provavelmente exige algum raciocínio, e quanto mais longo o conteúdo, mais tempo leva.
2. Avaliar o material produzido com base nas famílias de perguntas listadas acima.
3. Passar as frases por rodadas cirúrgicas de reparo, nos casos em que as correções não puderam ser aplicadas de forma programática.
4. Repetir o passo 2 mais uma vez.
5. Possivelmente repetir os passos 3 e 2 mais uma vez antes de enviar o conteúdo ao usuário.
 Mesmo com uma GPU de nível empresarial e cache de prefixo, esse processo pode levar um ou dois minutos, e só temos 8 slots para inferência em paralelo, o que significa que as tarefas precisam entrar numa fila quando mais de 8 pessoas tentam gerar ao mesmo tempo. Nada prático, em nenhum sentido.
É aí que entram os modelos System One.
## Como o Jev mudou tudo
Os modelos System One têm algumas vantagens importantes sobre os LLMs tradicionais que os tornam incrivelmente úteis em casos de uso como o meu.
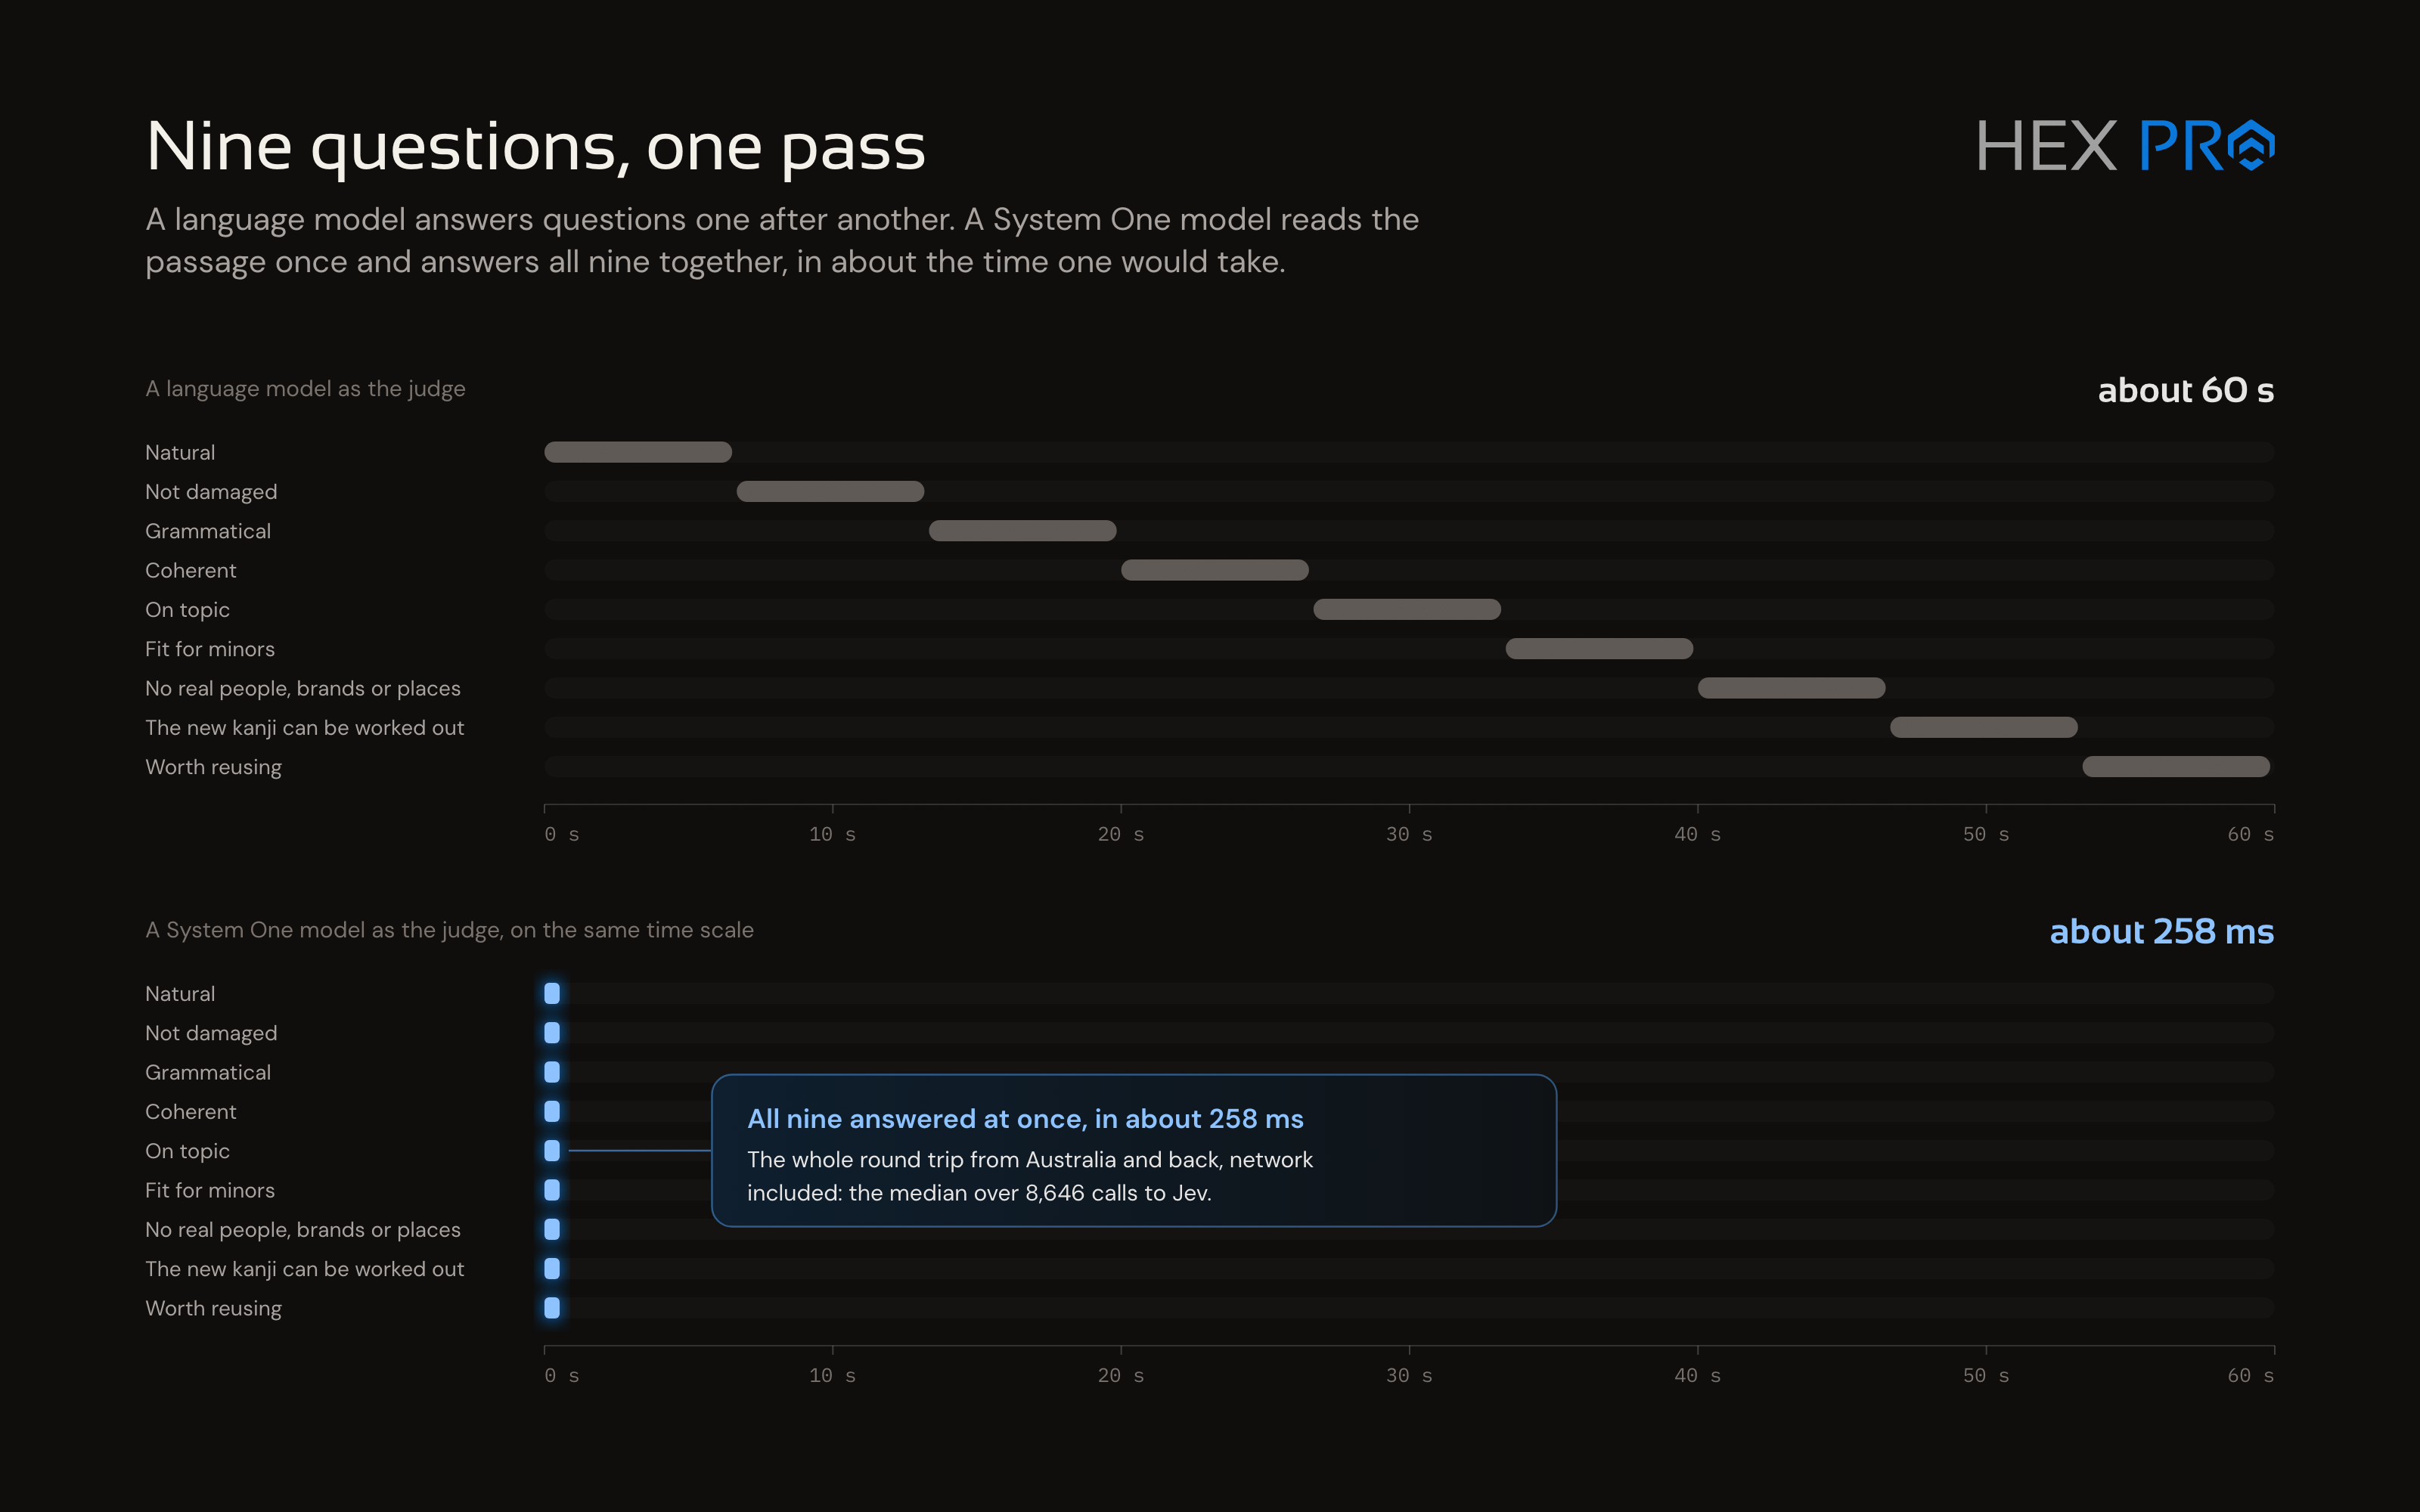
1. Eles respondem rapidíssimo. Estou na Austrália e o Jev roda no Vale do Silício, e mesmo assim uma chamada volta em cerca de 258 ms, ping incluído. É uma vantagem enorme sobre um LLM tradicional.
2. Eles respondem a muitas perguntas em paralelo. Ao contrário de um LLM, que precisa processar cada pergunta em sequência, os modelos System One conseguem receber um monte de perguntas e respondê-las em mais ou menos o mesmo tempo que levariam para uma só. Ou seja, se um LLM levava **60 segundos** para responder bem a nove perguntas, um modelo System One leva só **258 ms** para responder às mesmas nove. Quanto mais perguntas você precisa fazer, mais vantagem tira de uma ferramenta como o Jev.
 3. Eles são inacreditavelmente baratos. Durante este projeto, gastei só **US$ 0,025** com o Jev a cada 1.000 chamadas. Uma das lições é que o Jev é **incrivelmente econômico** de usar. Eu não teria o menor problema em integrá-lo em todo lugar: é praticamente de graça.
Outra vantagem pouco comentada é a confiabilidade. Alguns LLMs saem do controle e dão respostas sem estrutura, que não podem ser processadas de forma programática. O Jev é "typesafe" no sentido de que sempre dá uma resposta válida, que pode ser interpretada.
## Laya: o concorrente de código aberto
Isso me leva ao Laya, o tema deste experimento e provavelmente o motivo de você estar lendo este post. Poucos dias depois do lançamento público do Jev, surgiu uma enxurrada de tentativas de código aberto de recriar a tecnologia.
> https://github.com/NandhaKishorM/laya
Com nada menos que 35.000 estrelas no GitHub até o momento em que escrevo, o Laya chegou com tudo, com mais de 1.000 commits em umas duas semanas e quase 3.000 hoje. Um lançamento bem impressionante, que mostrou o tamanho do interesse da comunidade de engenharia de software por modelos System One.
O Laya veio com três modelos de base: `laya (421M)`, `laya-multilingual (322M)` e `laya-typed-decisions (421M)`. Resumindo: o `laya` é o modelo para tudo, o `laya-multilingual` é melhor para idiomas além do inglês, mas tem precisão menor, e o `laya-typed-decisions` tem precisão maior, à custa de menos flexibilidade situacional e de uma capacidade multilíngue fraca.
### Vantagens do Laya
A vantagem mais óbvia do Laya é que ele é de código aberto, e você controla a infraestrutura. Não há o risco de o Laya falir de repente e desligar os servidores, provocando uma correria desesperada atrás de um substituto adequado, sob pena de o seu software sofrer uma falha catastrófica. É um incentivo atraente para empresas como a minha, que querem crescer muito e minimizar o risco.
A outra vantagem do Laya é o tamanho pequeno do modelo. Por padrão, ele precisa de pouquíssima VRAM para rodar e consegue até rodar em CPU, segundo o [gigantesco README.md gerado por IA](https://github.com/NandhaKishorM/laya/blob/main/README.md). Se não me engano, nos meus experimentos o modelo de base rodava com 2 GB de VRAM, cabendo com folga na minha infraestrutura de servidores.
### As desvantagens não tão óbvias
Quando algo parece bom demais para ser verdade, geralmente é. As estatísticas e comparações com o Jev que aparecem na [página do GitHub](https://github.com/NandhaKishorM/laya/blob/efbe194/BENCHMARKS.md) fazem afirmações como estas:
| | Laya | Jev (publicado) |
|---|---|---|
| typed-decisions (2,000 decisões) | **0.766** | 0.727 |
| AG News (4 rótulos) | **0.953** | 0.910 |
| DAIR Emotion (6 rótulos) | **0.600** | 0.480 |
| ECE após ajuste de temperatura | **0.081** | 0.246 |
| latência p50, 1 pergunta (T4) | **32.8 ms** | 236-276 ms |
Para mim, parece bem convincente. Então, onde está a pegadinha? Dê uma olhada nos temas em que os modelos do Laya foram testados.
| tema | laya | laya-multilingual | laya-typed-decisions | dados |
|---|---|---|---|---|
| Spam de e-mail | **0.993** | 0.993 | 0.958 | no treino |
| Phishing | 0.980 | **0.993** | 0.940 | no treino |
| Guardrails de LLM (jailbreak) | 0.708 | 0.755 | **0.762** | **fora do treino** |
| Moderação (toxicidade) | **0.530** | 0.525 | 0.530 | **fora do treino** |
| Relevância de trechos para RAG | 0.625 | **0.657** | 0.625 | no treino |
| Triagem de suporte (10 filas) | 0.502 | **0.522** | 0.505 | no treino |
| Roteamento de modelos (domínio) | 0.639 | 0.123 | **0.659** | fora do treino |
"Spam de e-mail", "phishing", "relevância de trechos para RAG" e "triagem de suporte". Esses temas são muito específicos e muito relevantes para as desvantagens. Repare que "guardrails de LLM", "moderação" e "roteamento de modelos" estão marcados como "fora do treino", e essa é uma distinção importante.
Em termos simples, o Laya não é um modelo one-shot. Você _não pode_ simplesmente pegá-lo e colocá-lo em qualquer caso de uso. Do jeito que vem de fábrica, ele tem capacidades muito específicas e é praticamente inútil para todo o resto. Esse é o primeiro ponto em que o Jev mostra de verdade do que é capaz: "simplesmente funciona". Os meus primeiros testes com o Infinilang e o modelo `laya-multilingual` foram um fracasso total: ele não conseguiu executar **nenhuma** das tarefas necessárias de forma satisfatória.
## Treinando um modelo personalizado para o Laya: infini-jp-v1
Depois do fracasso inicial, não desisti de imediato. Como o kcalc.ai e o Infinilang ainda estão longe da produção, tenho uma infraestrutura de servidores de respeito parada, praticamente sem uso. Ou seja, o Qwen 3.8 27B está lá esperando trabalho, e posso desligá-lo para treinar sempre que preciso de uma GPU potente. Era hora de fazer alguns experimentos.
### As regras básicas
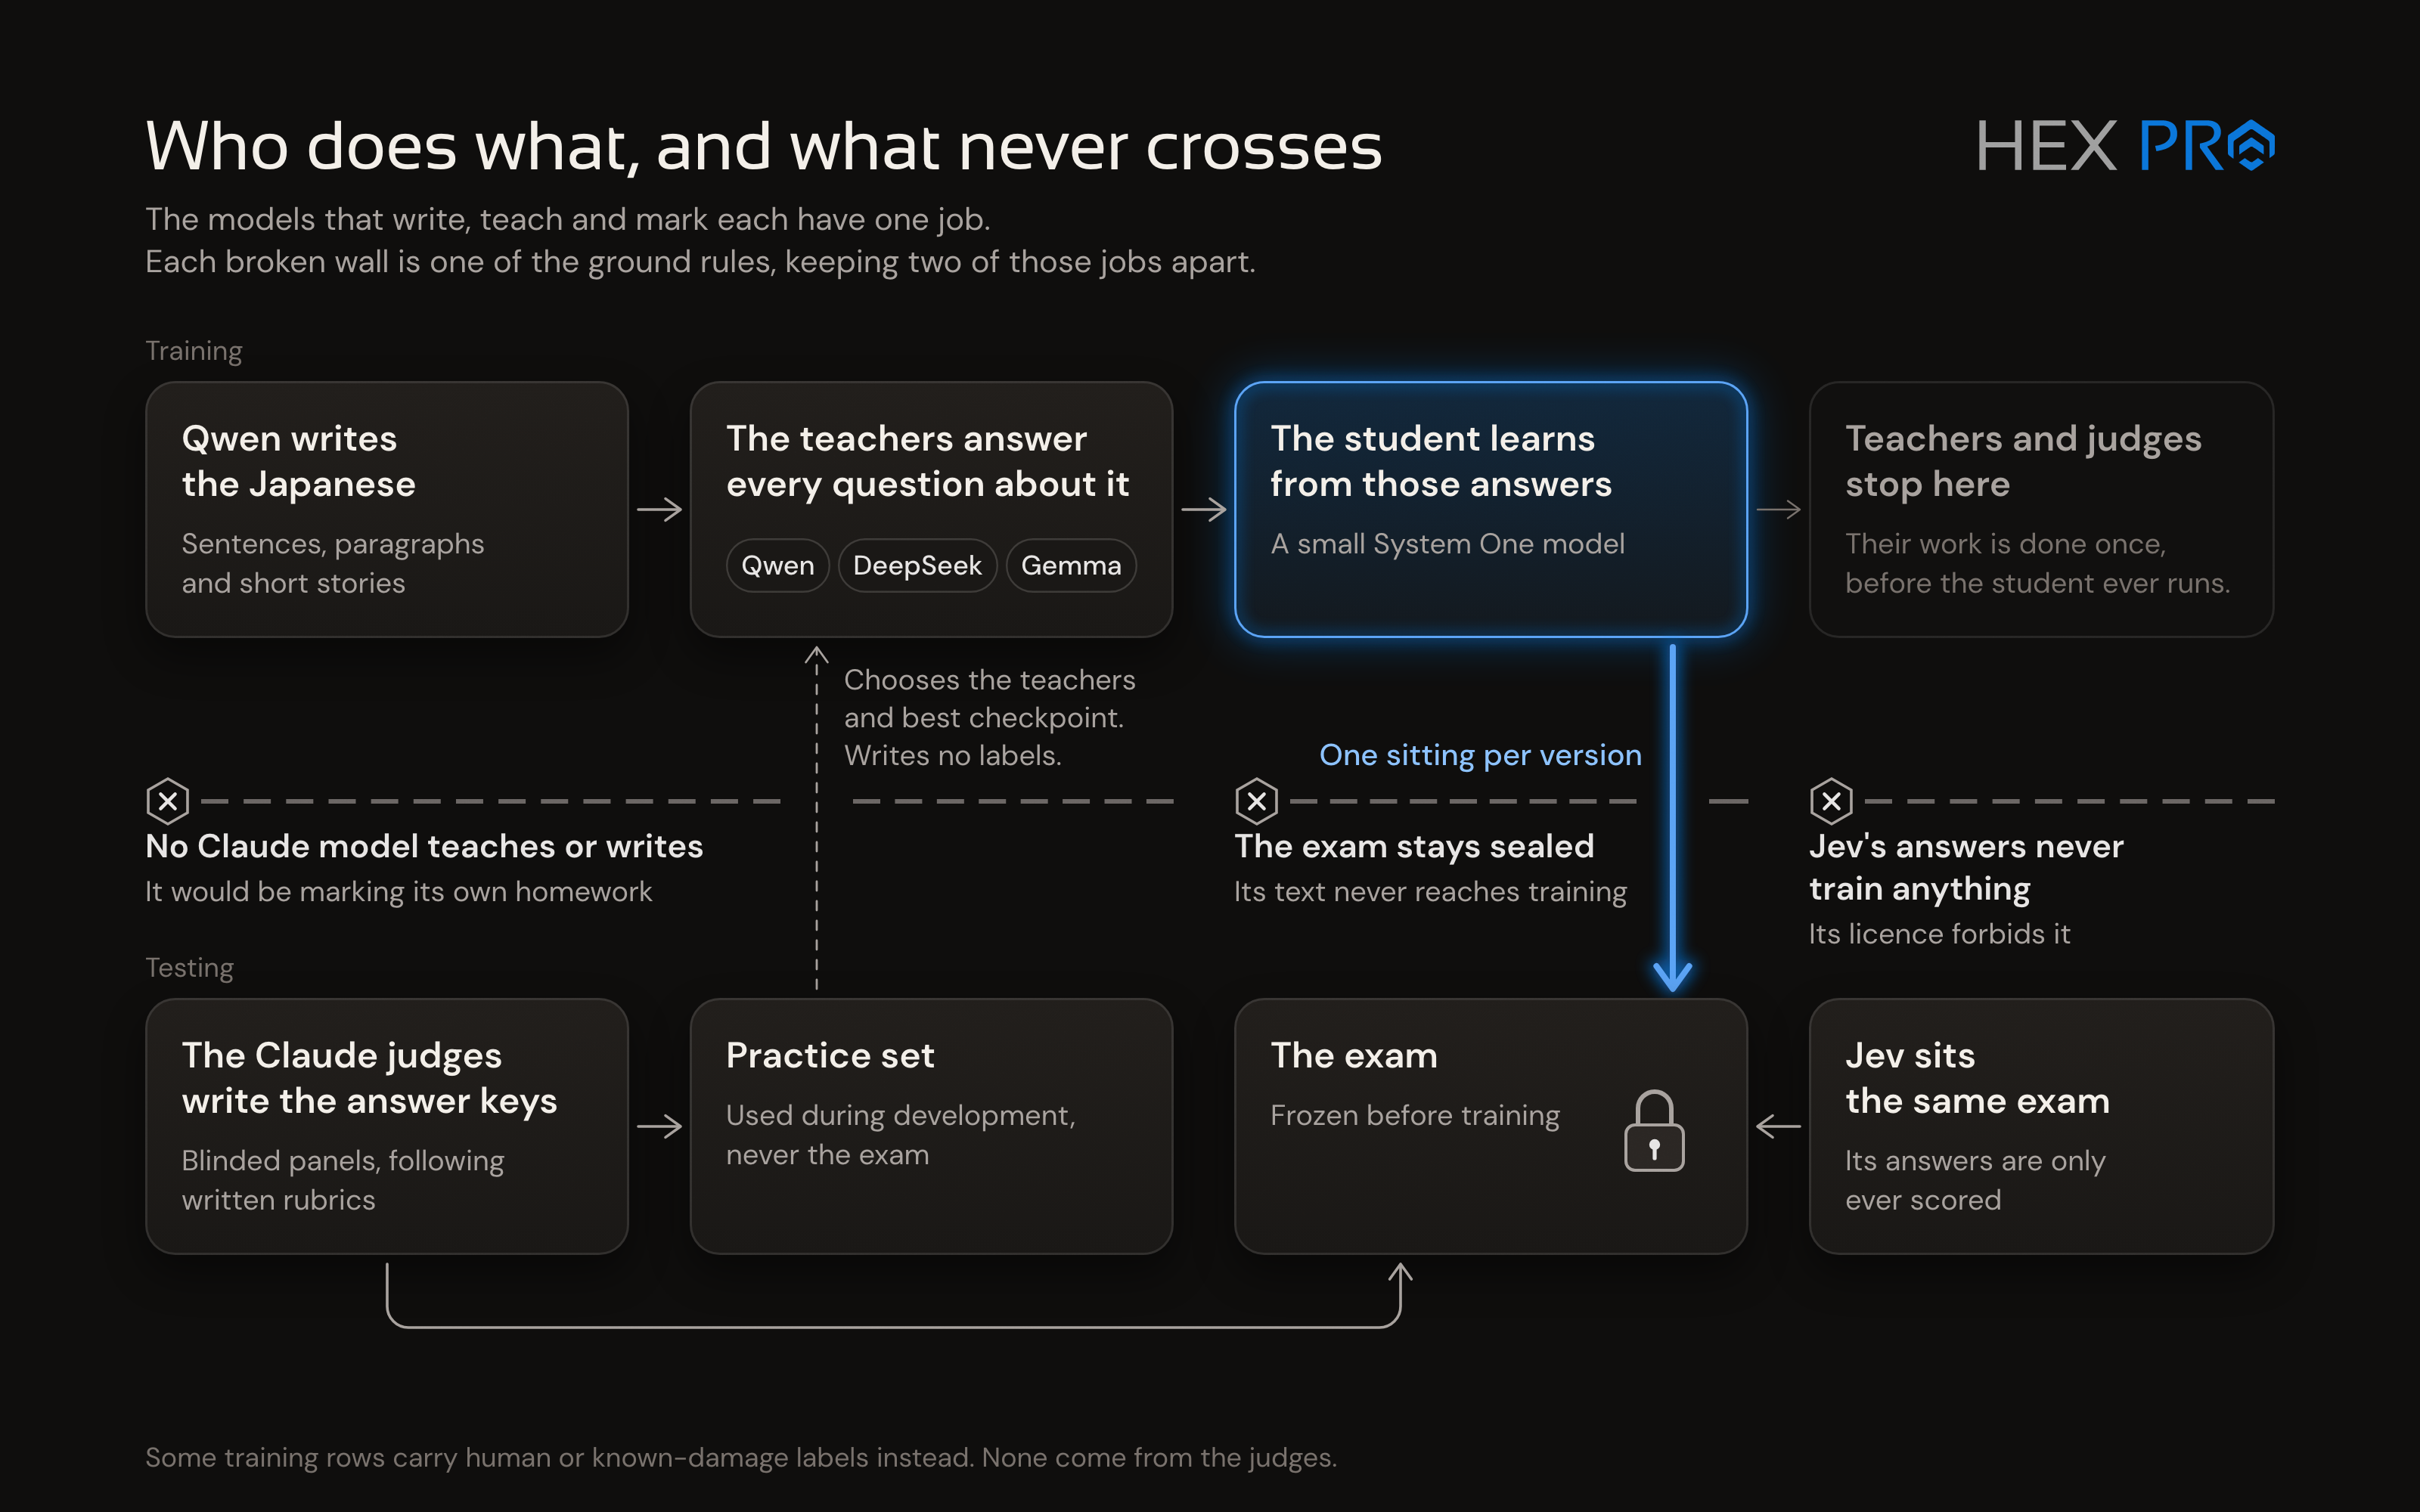 | Regra | Por quê | Como foi cumprida |
| --- | --- | --- |
| A saída do Jev nunca treina nada | A licença da TypeSafe proíbe a destilação | Contratos de importação entre módulos, um hook de auditoria que recusa qualquer leitor de `quarantine/` exceto o módulo de relatório, um enum de origem dos rótulos sem nenhum membro para o Jev |
| Nenhum professor ou gerador Claude | O padrão-ouro é um painel do Claude; um professor Claude estaria corrigindo a própria prova | Uma verificação de independência por família, linhagem declarada, id do modelo e host. A Anthropic proíbe usar os seus modelos para treino, por isso usamos modelos de pesos abertos no treino. |
| O benchmark é gasto com cuidado | Cada olhada no padrão-ouro de teste o enfraquece | Uma tentativa por versão por benchmark, um token de uso único do dono para cada tentativa, um log de acesso encadeado por hash e nenhum número de benchmark decidindo nada |
Na prática, há obstáculos jurídicos sérios para treinar modelos de IA. Como pessoa jurídica, a Hex Pro precisa seguir essas leis à risca. Por isso, me esforcei muito para garantir que cumpria todos os requisitos de licença.
### Experimento 1: Qwen 3.8 como professor
O primeiro experimento foi relativamente simples. O objetivo era descobrir se um modelo treinado conseguia atingir um patamar definido de antemão.
1. O Qwen 3.8 gerou 1.995 exemplos de japonês do mesmo jeito que o protótipo do Infinilang exigiria.
2. O Claude Opus avaliou cada saída em painéis de 3 para seis famílias, e isso nos deu o nosso "padrão-ouro" para comparar.
3. O Qwen 3.8, como professor, rotulou os dados de treino com as suas próprias avaliações das mesmas seis famílias.
As seis famílias do experimento inicial eram:
- **S1**: Quão natural é a frase - **Nota numa escala de 5 pontos** (Métrica: [Spearman](https://en.wikipedia.org/wiki/Spearman%27s_rank_correlation_coefficient))
- **S2**: A frase parece filtrada ou danificada - **Sim ou não** (Métrica: [pAUROC](https://en.wikipedia.org/wiki/Partial_Area_Under_the_ROC_Curve))
- **S3**: O inglês é uma tradução fiel - **Sim ou não** (Métrica: pAUROC)
- **P1**: O melhor de três candidatos a reparo, ou nenhum - **Escolha entre 4** (Métrica: concordância com o padrão-ouro)
- **P2**: Algum dos candidatos a reparo é aceitável? - **Sim ou não** (Métrica: pAUROC)
- **G1**: A frase é gramatical - **Sim ou não** (Métrica: pAUROC)
O resultado foi decepcionante. O que mais se destacou foi o S1 (naturalidade), que precisava atingir um patamar de [Spearman](https://en.wikipedia.org/wiki/Spearman%27s_rank_correlation_coefficient) de 0,60, mas ficou em 0,452. O meu primeiro instinto foi engavetar ali mesmo a ideia de treinar o Laya. Até então, eu tinha gastado cerca de um dia e meio nisso, e aqueles resultados simplesmente não eram bons o bastante.
Encerrei o experimento ali; não valia o tempo. O Jev é tão barato de usar que treinar um modelo custaria ordens de grandeza mais do que o Jev custaria em 5 anos de uso intenso. Mais tarde, naquele mesmo dia, por impulso, resolvi testar o Jev no mesmo experimento e descobri algo _muito_ interessante.
| Família | Professor | Jev | Comparação | Calibração (confiança) |
|--------|--------:|----:|-----------:|------------------------:|
| S1 (Spearman) | 0.452 | 0.446 | +0.006 | Jev 20.4% melhor |
| S2 (AUROC) | 0.920 | 0.900 | +0.02 | Jev 64.9% melhor |
| S3 (AUROC) | 0.972 | 0.983 | -0.011 | Professor 36% melhor |
| P1 (concordância) | 0.874 | 0.75 | **+0.124** | Jev 14.5% melhor |
| P2 (AUROC) | 0.878 | 0.849 | +0.029 | Jev 75.7% melhor |
| G1 (AUROC) | 0.782 | 0.766 | +0.016 | Jev 72.5% melhor |
**_EITA!_** Pera aí. Que números são esses? O professor empatou com o Jev em todas as métricas e ainda teve uma vitória expressiva na escolha entre candidatos a reparo de frases. Mas o número que mais me convenceu foi o 0,446 no S1. _O Jev também não atingiu o patamar de 0,6._
Esses resultados deram novo fôlego ao projeto, e logo tratei de avançar a partir deles. Com uma tentativa superficial, eu tinha empatado com o Jev nessas tarefas do Infinilang. Houve um ponto em que o Jev se mostrou imbatível do começo ao fim: a _calibração_. Embora os resultados em si fossem sólidos com o Laya, a pontuação de "confiança" que o Jev oferece é muito superior em todos os aspectos. A pontuação do Jev é multidimensional, e ele _sabe_ quando tem certeza de algo e quando não tem. Para um modelo one-shot que pode ser encaixado em qualquer tarefa, isso é muito importante. Para um modelo feito para um conjunto muito específico de tarefas, esse número de calibração é menos necessário.
### Experimento 2: disputa e refinamento
Neste ponto, o experimento 1 foi encerrado e os benchmarks foram congelados. Ia começar a sair dinheiro, e a coisa ia ficar séria. O objetivo agora era conseguir um ganho expressivo sobre as capacidades do Jev para o Infinilang. Eu via três formas de melhorar as pontuações do experimento 1.
1. Mais dados de treino
2. Modelos de LLM melhores
3. Uma rubrica mais diversificada
Nesse momento, decidi só produzir os benchmarks do Jev _depois_ de reunir todos os resultados. Assim que eu rodasse o benchmark do Jev, teria de passar para um novo conjunto de dados para manter o Jev em quarentena.
O primeiro passo foi fazer uma triagem de professores alternativos. Eu procurava modelos que fossem muito maiores ou que talvez se saíssem melhor nas restrições de japonês do Infinilang. Os candidatos eram:
- DeepSeek V4.1 - Modelo de raciocínio enorme e capaz, com inferência razoavelmente barata. Pontuações fortes em japonês.
- Gemma 4 31B - Testado para o protótipo do Infinilang, destacou-se por evitar vazamentos de kanji. Também é pequeno o bastante para rodar na minha infraestrutura de servidores, então testá-lo sai basicamente de graça.
- Qwen 3.8 Flash Next - Basicamente uma prévia do Qwen 4. É um modelo de mistura de especialistas ([MOE](https://en.wikipedia.org/wiki/Mixture_of_experts)), o que o torna muito maior e com mais conhecimento que o Qwen 3.8 27B.
- Hy3 e Inkling-Small - Dois modelos menos conhecidos que, imaginei, _talvez_ tivessem uma boa capacidade em japonês.
Outros modelos foram descartados, geralmente porque a licença deles não permite usá-los para treino.
#### A disputa
O Qwen 3.8 Flash Next foi o primeiro a cair. O grande problema era o risco de autopreferência, já que ele vem da mesma família do gerador (Qwen 3.8 27B). Vale a pena dar uma olhada em [_Extreme Self-Preference in Language Models_](https://arxiv.org/html/2509.26464v2) (Steven A. Lehr, Mary Cipperman e Mahzarin R. Banaji, 2026), um estudo que demonstrou que os LLMs adoram o que eles mesmos produzem e tendem a ser críticos com o que os outros produzem.
> _"A autopreferência é uma característica fundamental dos organismos biológicos. Como os grandes modelos de linguagem (LLMs) não têm senciência, seria de esperar que evitassem essas distorções. No entanto, ao longo de 72 experimentos e ~41.000 consultas, descobrimos autopreferências maciças em oito LLMs amplamente usados."_
O risco de a autopreferência afetar os resultados era alto demais, e os testes mostraram que os resultados dele ficavam muito próximos dos do Qwen 3.8 27B, de qualquer forma. Não fazia sentido investir dinheiro de verdade num modelo com esse tipo de risco quando eu podia simplesmente usar a versão 27B de graça e ter um resultado parecido.
O Hy3 e o Inkling-Small foram os próximos a sair. Não há muito o que dizer. Eram caros e não tiveram resultados melhores do que nenhum outro modelo.
O DeepSeek V4.1 foi o grande destaque em tudo. Os resultados foram muito além do que eu esperava. Sempre tive a impressão de que o DeepSeek era só uma cópia chinesa barata e de baixa qualidade, que roubou tudo da OpenAI e da Anthropic. A parte do roubo provavelmente é verdade, mas de baixa qualidade ele não tem mais nada. Era claramente o melhor modelo de pesos abertos que também permitia usar os seus dados para treino. Deus abençoe os chineses.
O Gemma 4 foi o último modelo. Na maioria das famílias, o DeepSeek dominou. O Gemma 4 ficou à altura do DeepSeek na maioria dos aspectos e se saiu especialmente bem no S3 (tradução fiel). Também teve bom desempenho no P2 (algum reparo aceitável) e no B2 (dentro do tema). Como testá-lo era de graça, decidi que valia a pena seguir com ele.
Então, todos os testes seguintes seriam feitos com o Qwen 3.8 27B, o Gemma 4 31B e o DeepSeek V4.1.
#### Aprimorando a rubrica
O experimento inicial tinha um conjunto limitado de famílias, mas há muitas outras formas de usar esse modelo dentro do Infinilang, e eu queria garantir que ele fosse treinado em todas as tarefas que precisaria cumprir.
A nova rubrica tinha 14 famílias. As 6 mencionadas acima (S1, S2, S3, P1, P2, G1) tiveram a redação refinada e enxugada, junto com as novas adições:
- **B1**: O trecho é coerente - **Sim ou não** (Métrica: [pAUROC](https://en.wikipedia.org/wiki/Partial_Area_Under_the_ROC_Curve))
- **B2**: O trecho está dentro do tema - **Sim ou não** (Métrica: pAUROC)
- **B3**: O trecho é adequado para menores - **Sim ou não** (Métrica: pAUROC)
- **B4**: Sem marcas ou lugares reais - **Sim ou não** (Métrica: pAUROC)
- **B5**: A palavra N+1 (kanji novo) pode ser inferida pelo contexto - **Sim ou não** (Métrica: pAUROC)
- **B6**: Vale a pena reutilizar o trecho - **Nota numa escala de 5 pontos** (Métrica: [Harrell's C](https://statisticaloddsandends.wordpress.com/2019/10/26/what-is-harrells-c-index/))
- **B7**: O japonês do trecho é natural - **Nota numa escala de 5 pontos** (Métrica: Harrell's C)
- **PS2**: O japonês do trecho parece danificado - **Sim ou não** (Métrica: pAUROC)
Desta vez, os dados de treino não seriam só uma linha de japonês (1 ou 2 frases). Seriam uma mistura de frases, parágrafos e contos. A rubrica foi ampliada para cobrir essa necessidade. Você também vai notar que havia alguns outros recursos que me interessavam, como guardar em cache para reutilizar com outros usuários e identificar conteúdo adequado para menores, para as restrições de idade.
#### Gerando dados de treino
A minha GPU passou 10 horas zumbindo, gerando novos temas e material de treino com o Qwen 3.8 27B. Optei por continuar gerando os dados de treino com o Qwen, porque, de qualquer forma, é esse o modelo que vai ser usado nas gerações do Infinilang daqui para a frente. Usar um modelo mais potente aqui seria contraproducente.
Terminei com 215.000 linhas, cada uma com os julgamentos do painel padrão-ouro do Claude. O Jev também ia receber a rubrica ampliada e aprimorada, o que melhorou bastante os resultados dele em relação ao benchmark do experimento 1.
#### Resultados da disputa
Note que os resultados a seguir usam as novas regras desenvolvidas com a rubrica aprimorada. Por isso, superam bastante os do experimento 1. Além disso, em algumas famílias, testei tirar a média dos resultados do DeepSeek e do Gemma, ponderando-os pela concordância entre si. Outra ressalva é que, em certos casos, para certos modelos, mais raciocínio chegou a piorar o resultado. Então, estes são os melhores resultados que consegui depois de ajustar diferentes combinações com e sem raciocínio, com e sem regras, para cada modelo e família.
| Família | Jev | Qwen 3.8 | DeepSeek | Gemma | Média DS+G | Contra o Jev |
|--------|----:|---------:|---------:|------:|--------------:|------------:|
| B1 (coerente) | 0.897 | 0.432 | **0.921** | 0.912 | - | +0.024 |
| B2 (dentro do tema) | 0.896 | 0.540 | **0.971** | 0.968 | - | +0.075 |
| B5 (palavra inferível) | 0.627 | 0.580 | **0.840** | 0.754 | 0.809 | +0.213 |
| B6 (vale reutilizar) | 0.786 | 0.596 | **0.819** | 0.613 | 0.740 | +0.033 |
| B7 (trecho natural) | 0.826 | 0.317 | 0.617 | 0.672 | **0.681** | -0.145 |
| PS2 (trecho danificado) | 0.635 | 0.537 | **0.943** | 0.937 | - | +0.308 |
| S1 (frase natural) | 0.721 | 0.740 | 0.753 | 0.774 | **0.784** | +0.063 |
| S2 (frase danificada) | 0.760 | 0.926 | **0.956** | 0.953 | - | +0.196 |
| S3 (tradução fiel) | 0.701 | 0.765 | 0.966 | **0.987** | - | +0.286 |
| G1 (gramatical) | 0.764 | **0.966** | 0.960 (K8) | 0.960 | - | +0.202 |
| P1 (melhor reparo) | 0.671 | 0.801 | 0.851 | 0.857 | **0.864** | +0.193 |
| P2 (algum aceitável) | 0.653 | 0.759 | 0.855 | **0.872** | 0.872 | +0.219 |
| B3 (adequado a menores) | 0.984 | 0.948 | **1.000** | 0.994 | - | +0.016 |
| B4 (sem nomes reais) | 0.962 | **0.994** | 0.974 | 0.991 | - | +0.032 |
*K8: oito respostas curtas amostradas com o raciocínio desligado, na forma de um histograma suavizado
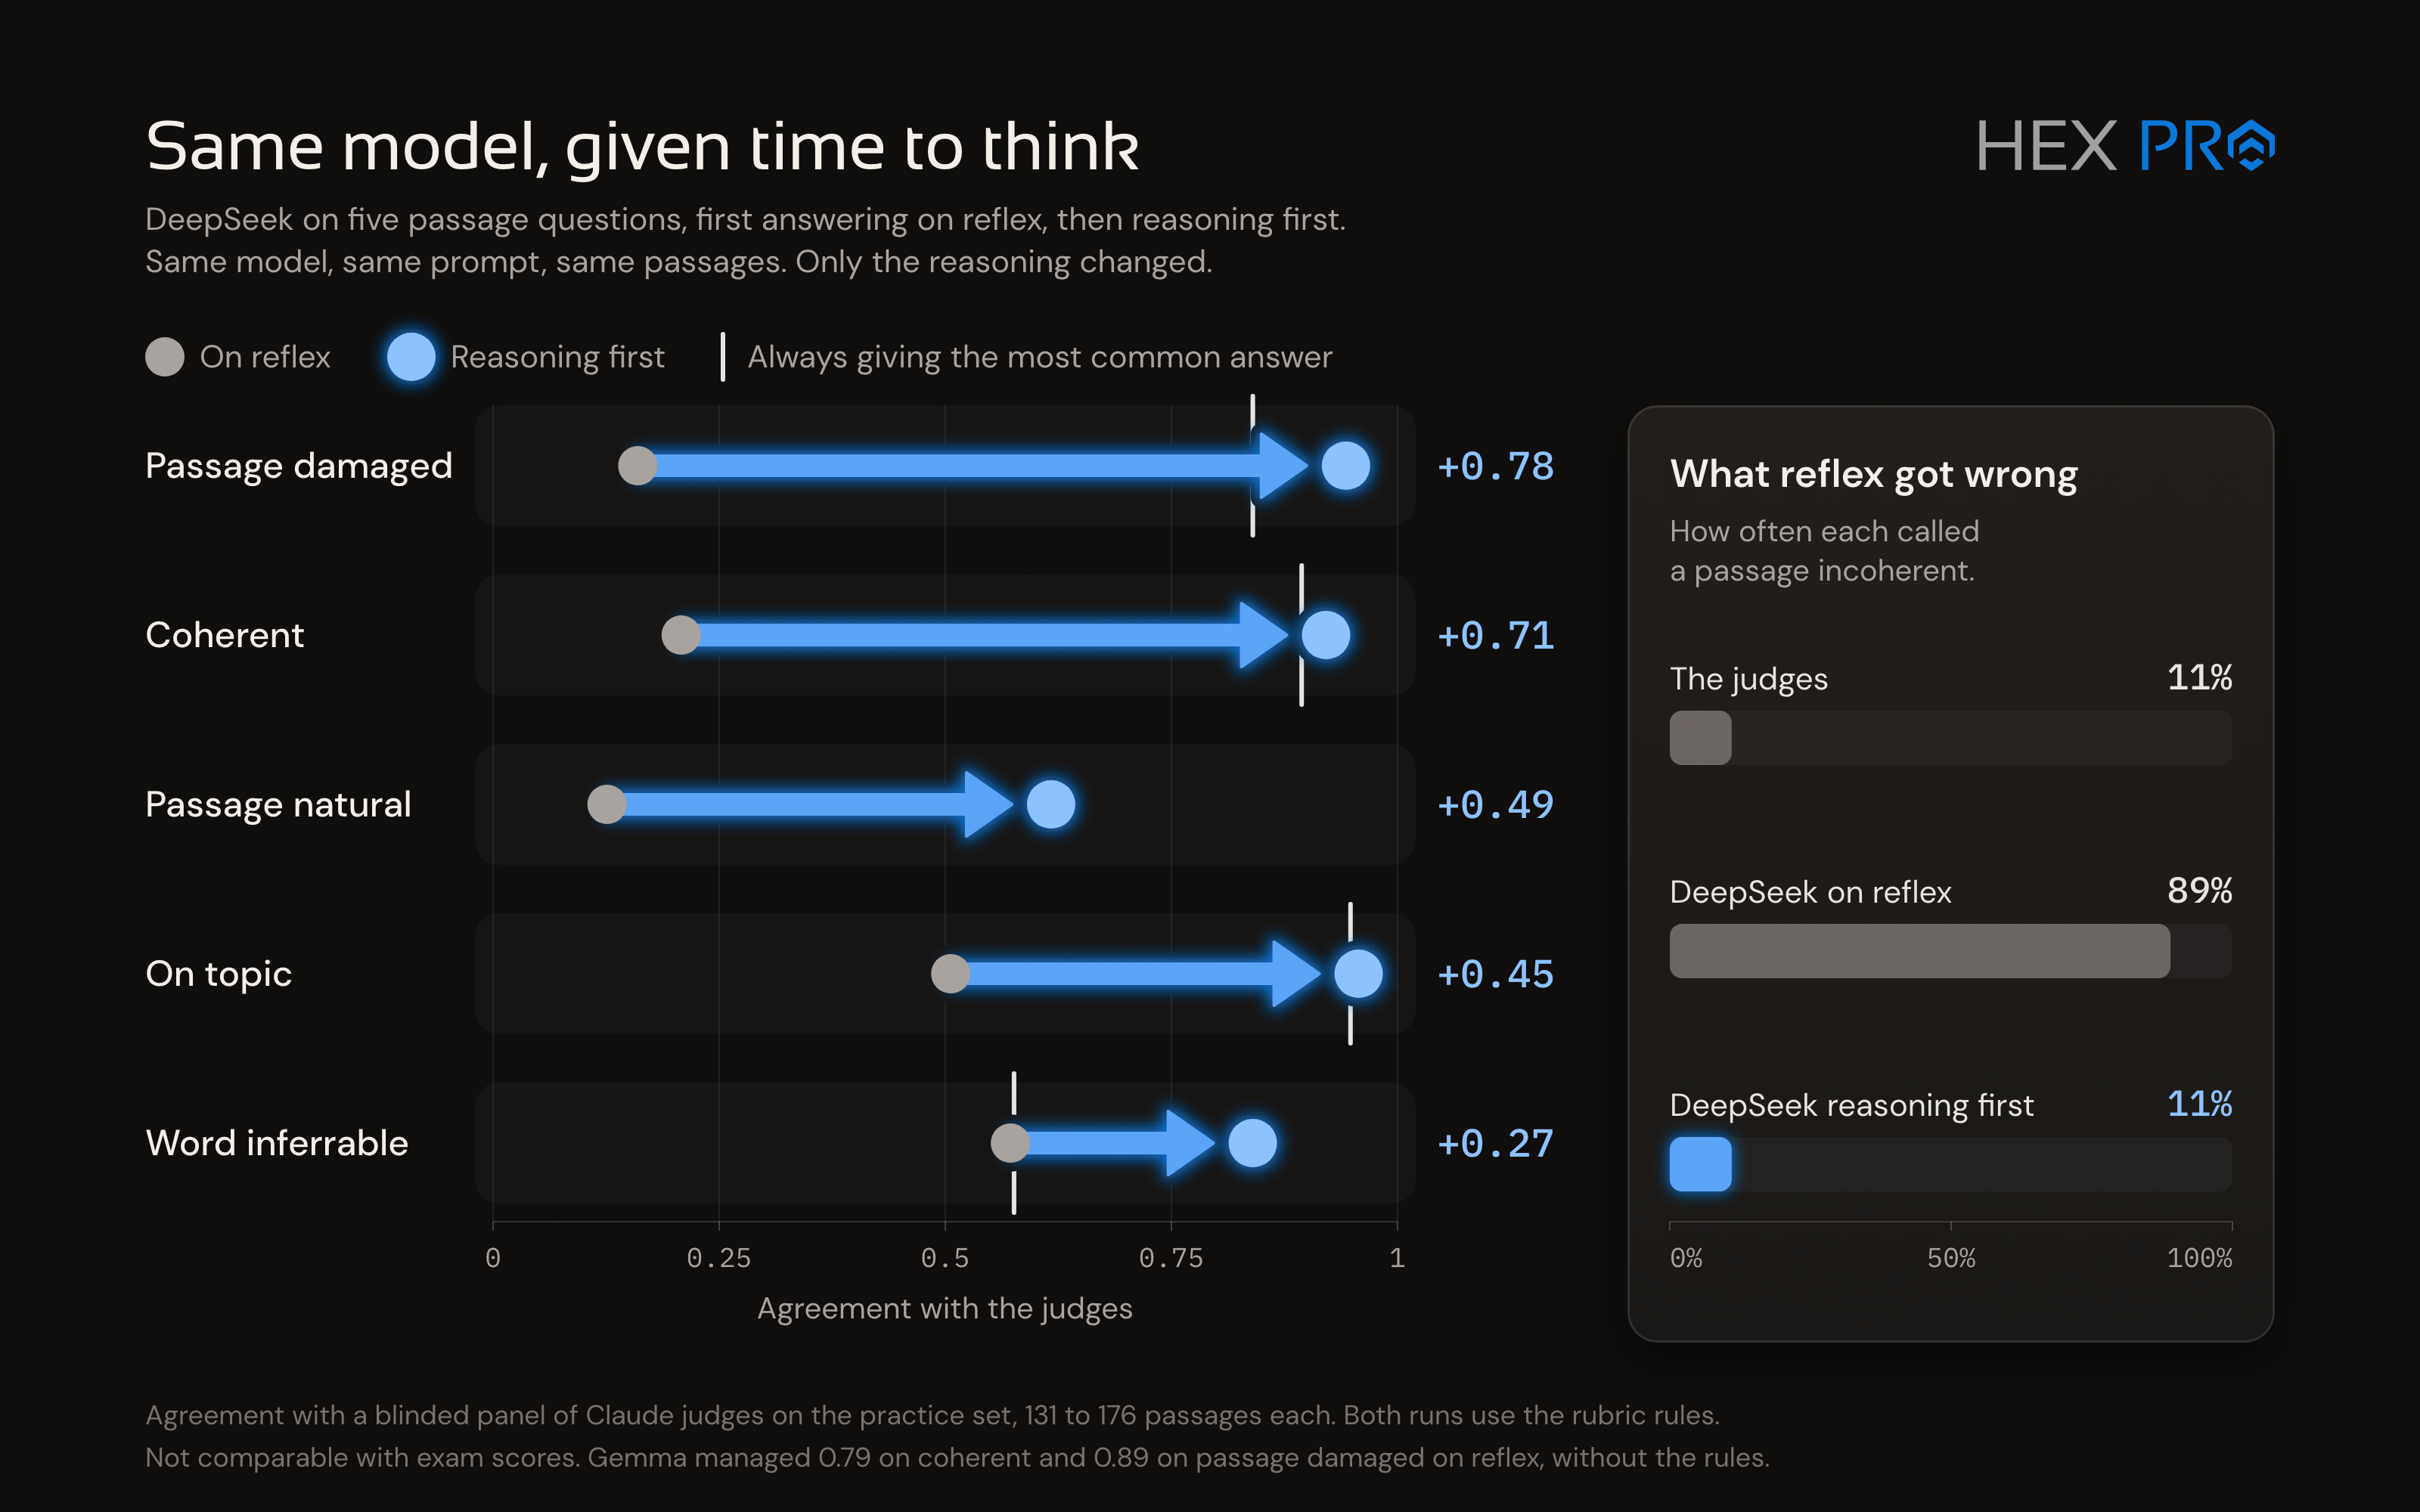 Esses números me deram uma boa ideia do que eu tinha em mãos. Como já disse, também testei o Jev nesses novos critérios e descobri que ele se saiu muito melhor desta vez. O Jev se destacou em textos mais longos, algo a considerar no contexto do Laya, que não tem uma janela de contexto tão longa e lida pior com textos longos.
### Experimento 3: os candidatos à produção
Com os professores de cada família definidos, era hora de treinar de fato o modelo System One. Lembre-se: o experimento 2 servia para determinar qual professor seria melhor para cada família. Isso não significa necessariamente que o modelo aluno vai ter um desempenho tão bom quanto o do professor; inevitavelmente haverá uma perda quando todas essas tarefas forem combinadas num único modelo. Quem pensa em usar o Laya deve considerar quantas tarefas precisa que um único modelo execute. Por exemplo, se eu treinasse um modelo separado para cada família e o otimizasse ao máximo, e depois espalhasse 14 modelos estrategicamente pelo meu programa, teria os melhores resultados em tudo. Mas aí o problema é que você precisa rodar 14 modelos separados, o que exige uma alocação de recursos de GPU bem maior. Então é uma questão de escala. Se você é uma megacorporação com bilhões para gastar em servidores caros, a escolha é óbvia. Um único desses modelos consegue atender um número astronômico de usuários com uma alocação mínima de recursos. Para qualquer outra pessoa, provavelmente não é o melhor uso da sua preciosa capacidade de GPU.
Nessa hora, era preciso levar a coisa a sério. A GPU foi ligada mais uma vez, e desta vez foram 35 horas gerando e rotulando mais dados de treino. Depois, os painéis padrão-ouro do Claude rodaram de novo sobre os novos dados, o que consumiu mais de 200 milhões de tokens num plano Ultra (antigo Max 20x).
O caro foi o DeepSeek: como não dava para rodá-lo localmente, ele precisou de inferência na nuvem. Foi escolhido para 9 famílias e custou AU$ 233,56, levando 18 horas para terminar. Em USD tudo parece tão inocente, mas as transações no banco, em AUD, parecem bem piores. A inferência do Gemma 4 rodou na nossa própria infraestrutura, então saiu de graça e levou cerca de 60 horas para rotular as poucas famílias que lhe couberam.
#### Os quatro alunos
No fim, treinei quatro candidatos com ajustes e conceitos diferentes: `prod-q38`, `prod-ds41`, `prod-mix1` e `prod-mix2`. Cada aluno foi treinado com três braços e duas sementes por braço, para garantir que não seríamos enganados por um ponto fora da curva. Os finalistas foram treinados com mais três sementes.
- Braço A: `laya-multilingual` (mmBERT) com a sua cabeça pré-treinada.
- Braço B: `modernbert-ja-310m` com uma cabeça nova.
- Braço E: `sokudan-ja-310m` transplantado para a arquitetura do Braço B.
Também houve um braço D, um teste de latência com 130M de parâmetros, que ficou para trás em desempenho.
##### prod-q38: Qwen 3.8
O primeiro e mais barato de treinar usou só o Qwen, em configurações diferentes (com/sem raciocínio e com/sem regras), conforme o que pontuava melhor. Eu sabia que ele não se sairia tão bem quanto os outros, mas era a continuação do experimento 1 e servia de linha de base para medir quanto os outros modelos conseguiriam melhorar.
##### prod-ds41: DeepSeek e Qwen
O DeepSeek foi claramente o melhor no experimento anterior, mas o Qwen tinha vantagem ou chegava bem perto do DeepSeek em algumas famílias. Onde ele empatava com o DeepSeek ou o superava, usei o Qwen para economizar um pouco.
##### prod-mix1: DeepSeek, Gemma e Qwen
Este pegou o melhor de cada família e tentou montar o combo definitivo. Também testou trocar o Qwen pelo DeepSeek nos pontos em que o aluno `prod-ds41` parecia render menos do que o esperado.
##### prod-mix2: DeepSeek, Gemma e Qwen (remix)
Conceito parecido com o do `prod-mix1`, mas o P1 e o B3 voltaram a ser como no `prod-ds41`, para ver se isso ajudava a melhorar os resultados.
#### Sobre os braços
Treinar em braços diferentes foi uma decisão sábia, porque revelou dados muito importantes. Todos os braços treinados a partir do `laya-multilingual` (Braço A) ficaram abaixo do Braço B e do Braço E. Foi uma descoberta importante, porque mostrou que a versão multilíngue, pelo menos no meu caso, em que eu só precisava de japonês, era um lixo.
Recomendo fortemente que quem tentar treinar um modelo System One descarte os modelos do Laya que vêm de fábrica e treine a partir de uma cabeça limpa do ModernBERT. Ou, pelo menos, faça o teste com vários braços, como fizemos, para não ser pego de surpresa por um checkpoint inferior.
#### Os alunos encaram a prova
Estes são os números finais de cada aluno contra os números finais do Jev, com a rubrica aprimorada, nos novos dados de treino.
| Família | Jev | prod-q38 | prod-ds41 | prod-mix1 | prod-mix2 |
|---|---:|---:|---:|---:|---:|
| S1 | **0.721** | 0.604 | 0.641 | 0.620 | 0.639 |
| S2 | 0.760 | 0.879 | 0.889 | **0.890** | 0.884 |
| S3 | **0.701** | 0.552 | 0.631 | 0.574 | 0.521 |
| P1 | 0.671 | 0.833 | 0.825 | **0.857** | 0.813 |
| P2 | 0.603 | 0.788 | 0.852 | **0.887** | 0.820 |
| B1 | 0.897 | 0.734 | **0.921** | 0.898 | 0.894 |
| B2 | 0.846 | 0.858 | 0.890 | 0.884 | **0.900** |
| B3 | **0.984** | 0.938 | 0.955 | 0.933 | 0.955 |
| B4 | 0.962 | 0.968 | 0.943 | 0.957 | **0.969** |
| B5 | 0.627 | 0.571 | **0.656** | 0.627 | 0.614 |
| B6 | 0.777 | 0.841 | 0.843 | **0.879** | 0.867 |
| B7 | 0.826 | 0.847 | **0.882** | 0.878 | 0.871 |
| PS2 | 0.615 | 0.705 | 0.830 | 0.838 | **0.850** |
| G1 | 0.764 | 0.804 | **0.815** | 0.814 | **0.815** |
| **Composto** | 0.768 | 0.780 | **0.827** | 0.824 | 0.815 |
Os resultados são fascinantes porque nem sempre são intuitivos ou esperados. O essencial é entender que o treino dos valores de cada família afeta todas as outras famílias num grau pequeno, mas que vai se acumulando. Por isso, os números variam para todo lado. Em alguns casos, o aluno pontua melhor que o professor; em muitos, pontua um pouco pior.
Também é muito difícil decidir um vencedor de fato, porque o valor de cada família não é igual. Por exemplo, o S1 (naturalidade do japonês) é uma família importante, e aqui o Jev fica bem acima dos outros. Por outro lado, o B7 (naturalidade do japonês no _trecho_ inteiro) também é muito importante, e aqui o Jev fica atrás de todos os outros modelos.
Na mesma linha, um modelo não é automaticamente melhor só porque "vence" muitas famílias. O `prod-ds41`, o `prod-mix1` e o `prod-mix2` ficam muito próximos uns dos outros na maioria dos casos. A diferença entre o S2 do `prod-mix1`, de 0,890, e o do `prod-ds41`, de 0,889, é praticamente nula. Isso fica mais claro se cortarmos o ruído e mostrarmos só a vantagem ou a desvantagem em relação ao Jev, mas apenas para quem vence a família ou empata na liderança.
| Família | Jev | prod-q38 | prod-ds41 | prod-mix1 | prod-mix2 |
|---|---:|---:|---:|---:|---:|
| S1 (frase natural) | 0.721 | -12% | -8% | -10% | -8% |
| S2 (frase danificada) | 0.760 | +12% | +13% | +13% | +12% |
| S3 (tradução fiel) | 0.701 | -15% | -7% | -13% | -18% |
| P1 (melhor reparo) | 0.671 | +16% | +15% | +19% | +14% |
| P2 (algum aceitável) | 0.603 | +19% | +25% | +28% | +22% |
| B1 (coerente) | 0.897 | -16% | +2% | 0% | 0% |
| B2 (dentro do tema) | 0.846 | +1% | +4% | +4% | +5% |
| B3 (adequado a menores) | 0.984 | -5% | -3% | -5% | -3% |
| B4 (sem nomes reais) | 0.962 | +1% | -2% | -1% | +1% |
| B5 (palavra inferível) | 0.627 | -6% | +3% | 0% | -1% |
| B6 (vale reutilizar) | 0.777 | +6% | +7% | +10% | +9% |
| B7 (trecho natural) | 0.826 | +2% | +6% | +5% | +5% |
| PS2 (trecho danificado) | 0.615 | +9% | +22% | +22% | +24% |
| G1 (gramatical) | 0.764 | +4% | +5% | +5% | +5% |
| Composto | 0.768 | +1% | +6% | +6% | +5% |
Na minha opinião, o `prod-ds41` é o modelo versátil ideal. O `prod-mix1` tem resultados impressionantes em algumas famílias (sobretudo P1, P2 e B6), mas perde muito terreno para o Jev em outras em que o `prod-ds41` perde menos (S3, S1, B1 e B3). O `prod-mix2` tem algumas fraquezas sérias em comparação com os outros dois, sendo mais fraco em várias (S3, P1, P2 e B5) e nada especialmente forte no resto. No geral, porém, os três costumam levar vantagem sobre o Jev, com algumas exceções em que o Jev _realmente_ se destaca (S1, S3 e B3).
Então, na escolha entre o `prod-ds41` e o `prod-mix1`, o `prod-ds41` sai na frente simplesmente por ser forte de forma mais consistente em todas as famílias.
## O veredito
O `prod-ds41` acabou levando a coroa e ganhando o rótulo de `infini-jp-v1`. Os números mostram com muita clareza que ele é capaz de cumprir a maioria dos papéis, com a decepcionante exceção do S1, a naturalidade da frase, para o qual encontrei outra solução, de qualquer forma (mais sobre isso adiante).
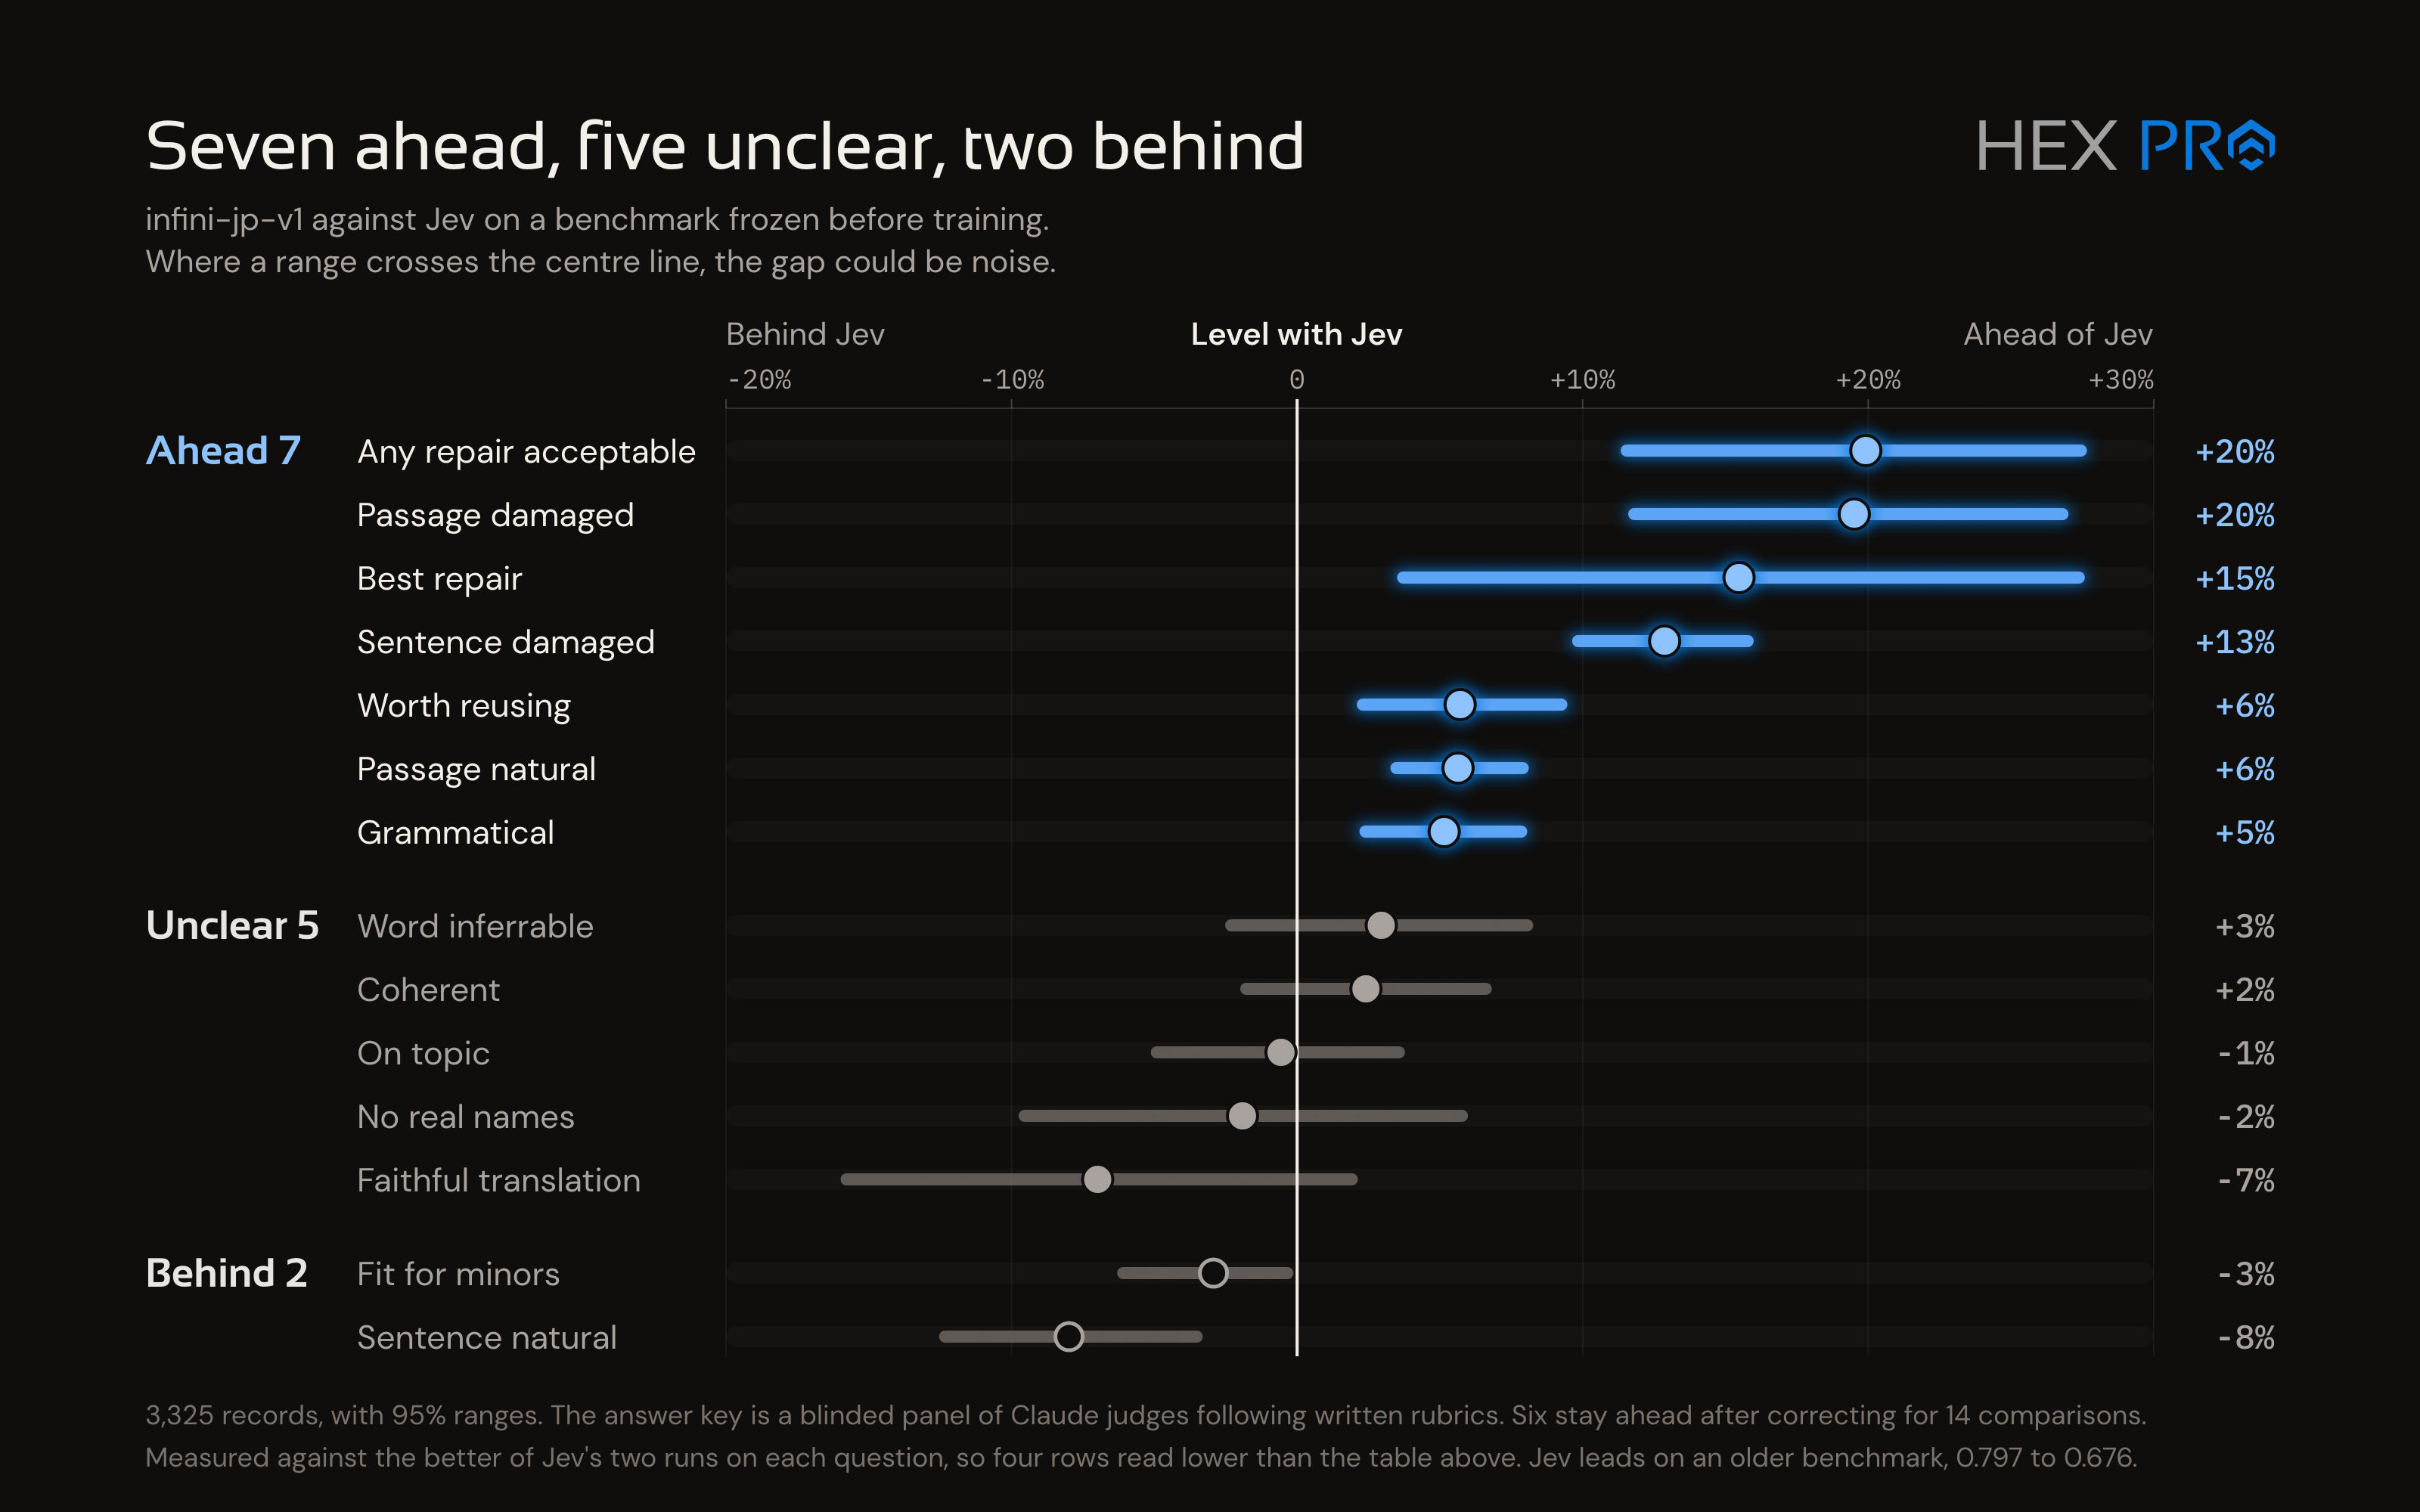 Quanto à pergunta principal: o Laya é melhor que o Jev? Talvez? Mas provavelmente não. Embora, neste caso, ele supere o Jev neste conjunto específico de tarefas, vamos fazer as contas de quanto custou desenvolvê-lo.
### Grana, baby!
Somando tudo, gastei US$ 270 (AU$ 389) neste projeto, sendo US$ 268,23 em inferência na nuvem e **US$ 0,21 no Jev**. Barato para os padrões de treino de IA, a julgar pelas centenas de bilhões em dívidas que a Anthropic e a OpenAI estão assumindo. Nada barato para os padrões de uma startup com pouco capital e receita mínima (por enquanto). Mas foi um P&D valioso, porque respondeu a algumas perguntas importantes sobre se eu devo usar isso nos meus outros projetos no futuro. Além disso, agora tenho um projeto de pipeline de treino com mais de 1.000 commits e 14.522 testes unitários, o que significa que desenvolver outro modelo System One no futuro agora é só questão de refinar a rubrica e fazer as disputas entre modelos.
### TEMPO!
Em horas de mão na massa, não saiu nada barato. Graças a Dario pelo Claude Code, porque boa parte do trabalho braçal (ficar de olho no fim das execuções, enfileirar as próximas etapas e por aí vai) ficou por conta dele. Isso significou um mínimo de tempo parado: o trabalho seguia durante a noite. Mesmo assim, levei 24 dias para terminar o projeto, do começo ao fim. Sem a ajuda da IA, teria levado seis meses, não tenho a menor dúvida.
Mesmo com a IA economizando um tempo enorme e me deixando trabalhar em outras coisas em paralelo, o tempo que eu mesmo dediquei teria valido cerca de AU$ 5.000 em mão de obra, pelo valor que eu cobrava antes. É um custo que _precisa_ ser levado em conta ao treinar um modelo System One.
### Computação de GPU e eletricidade
Sou meio sortudo por ter acesso a uma GPU rápida e potente, de nível empresarial. Mas este projeto exigiu mais de 40 horas de uso exclusivo da GPU, e tenho pavor de pensar em quanto deu a conta de luz. Nem quero saber.
O outro custo contínuo é que ele ocupa aproximadamente 2 GB de VRAM no meu servidor.
### Vale a pena?
É uma pergunta importante e difícil de quantificar. Estas são as perguntas que eu ia querer responder se estivesse pensando em tentar isso:
- O Jev consegue executar bem a tarefa?
- Que volume de chamadas você espera ter?
- Quantas tarefas você precisa que ele faça, e quão diferentes elas são?
- Quanto tempo vai levar para você recuperar o investimento?
- Qual é a importância da tranquilidade de saber que o seu software vai funcionar depois que a TypeSafe desaparecer?
- Quanto você se importa com uma calibração/confiança precisa?
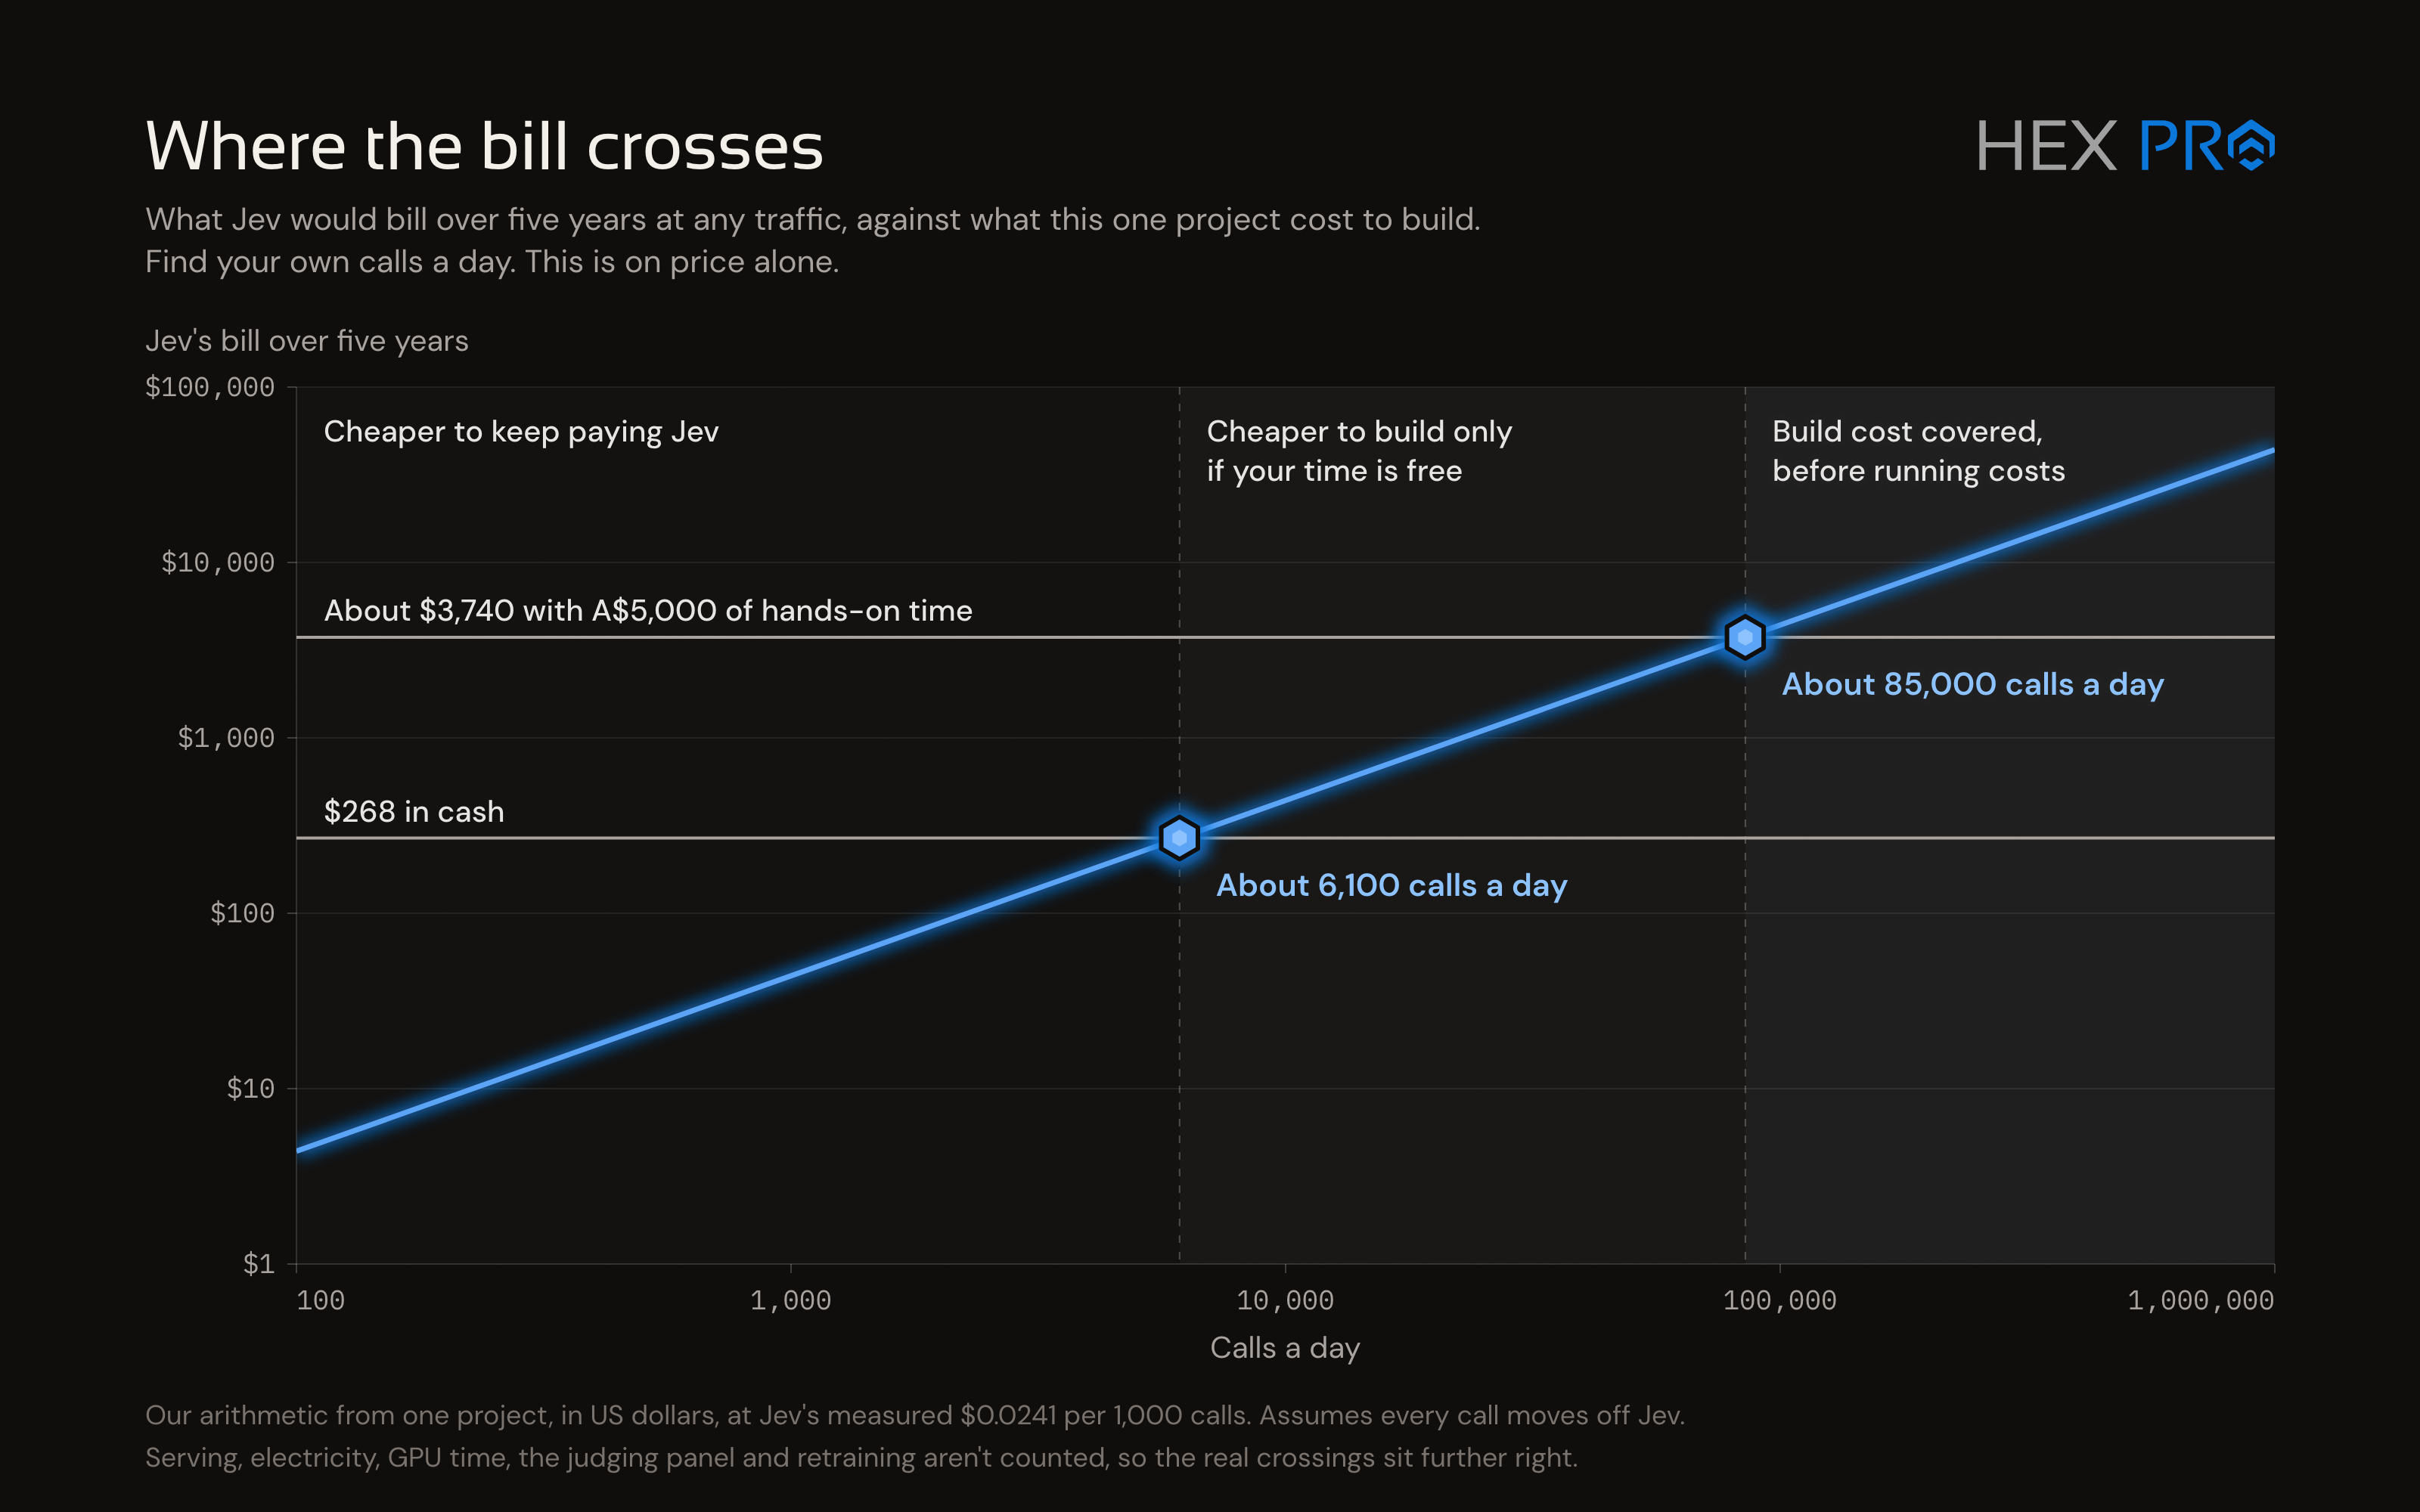 No meu caso, a melhora de capacidade pode ajudar o Infinilang a ter um desempenho melhor. Se o Infinilang melhorar por causa disso e isso me permitir construir uma base de usuários maior, o investimento inevitavelmente vai se pagar. É a única forma de eu justificar usar o Laya em vez do Jev.
### As maiores vantagens
- **Latência**: da Austrália, o Jev leva cerca de 258 ms para ida e volta. O Laya fica em média em cerca de 19 ms: é pelo menos 13 vezes mais rápido que o Jev e 2.000 vezes mais rápido que o DeepSeek.
- **Oportunidade de GPU**: ocupa 2 GB de VRAM. Não é pouco, mas também não é enorme. Mas a vantagem real é esta: as 14 famílias de perguntas que o `infini-jp-v1` responde são perguntas que não precisam ser respondidas (mal) pelo Qwen 3.8 27B, o que libera a GPU para atender a outras solicitações, mais importantes e mais adequadas.
- **Imitar um modelo superior**: você não precisa rodar o DeepSeek V4.1 para ter respostas bem próximas das que ele daria. O `infini-jp-v1` se sai muito melhor que o Qwen 3.8 27B nessas tarefas, e você não precisa sacar um DeepSeek de 614 GB de VRAM para isso.
- **Segurança para o negócio**: como já disse algumas vezes, usando o meu próprio modelo, não preciso me preocupar com o Jev sumindo de uma hora para outra. Sem quedas inesperadas, sem correria atrás de uma alternativa. Se o meu software está no ar, sei que o meu modelo System One também está.
- **Superioridade em tarefas específicas?**: se ele de fato se sai melhor ainda precisa ser comprovado em produção. Vamos ver. Como você viu pelas pontuações, em teoria ele é 6% melhor no Infinilang, mas isso considerando todas as famílias, não necessariamente as que sustentam o sistema.
## Sobre LoRA
Para quem não conhece, um [LoRA (Low-Rank Adaptation)](https://en.wikipedia.org/wiki/LoRA_(machine_learning)) é meio que uma persona plug and play para um LLM. Talvez você já tenha ouvido chamarem isso de "fine-tuning". Ao contrário de um modelo System One, que é um serviço à parte, um LoRA é aplicado diretamente ao LLM na hora da inferência, deslocando os seus pesos para fazê-lo se comportar de outro jeito.
Por isso, numa fase posterior do desenvolvimento do Infinilang, treinei um LoRA para ajudar o Qwen 3.8 27B a produzir resultados de melhor qualidade e seguir regras mais rígidas. Isso significa que o `infini-jp-v1` vai classificar material de qualidade mais alta. Ele não vai precisar se esforçar tanto e deve ter um impacto mais confiável, principalmente para usuários com um repertório menor de kanji.
Vou me empenhar para melhorar ainda mais o Infinilang à medida que o desenvolvimento avançar.