---
title: "Les modèles System One vont révolutionner l'IA : Laya et Jev"
description: "Hex Pro a entraîné un modèle System One avec Laya en 3 semaines. Quel effort, quel coût ? Vaut-il le Jev de TypeSafe à 40 millions de dollars américains ?"
author: "Matthew Scott"
published: "2026-11-11T05:24:58.094Z"
updated: "2026-11-11T05:35:02.609Z"
language: "fr"
canonical: "https://hex.pro/fr/blog/system-one-models-will-revolutionise-ai-software-laya-jev"
markdown: "https://hex.pro/fr/blog/system-one-models-will-revolutionise-ai-software-laya-jev.md"
publisher:
name: "Hex Pro"
url: "https://hex.pro"
---
Le 15 septembre, le monde de l'IA et de la tech a connu un véritable séisme, passé largement inaperçu auprès du grand public. Comme d'habitude, les ingénieurs logiciels étaient en première ligne de cette avancée passée sous le nez de tous les autres : TypeSafe AI venait de sortir le premier modèle **System One** commercial, _« Jev »_.
Trois semaines plus tard, j'avais entraîné mon propre modèle System One pour l'un de nos futurs produits. Voici le bilan de cette expérience.
## Modèles System One : encore une pompe à fric de l'IA ?
Quiconque suit l'IA en ce moment connaît ce sentiment. Quelqu'un vous envoie le lien d'un nouveau produit d'IA et vous levez les yeux au ciel. « Des modèles System One ? » demandez-vous. Qui ça intéresse ? J'ai Claude Opus et une tonne de travail. Je n'ai pas de temps à perdre avec un nouveau _Manus_ ou un nouveau _Rabbit r1_.
C'est exactement ce qui m'est passé par la tête la première fois que j'ai entendu parler de Jev. Mais on me demandait mon avis, alors j'ai décidé de me pencher sur la question. Disons-le d'emblée : le site de TypeSafe AI explique très mal le concept. On vous pardonnerait de lire leur [article de blog annonçant la sortie](https://typesafe.ai/blog/introducing-system-one-models-and-jev) et d'en conclure qu'il s'agissait d'un concurrent des modèles d'IA les plus avancés d'OpenAI et d'Anthropic (d'autant que les graphiques laissent entendre exactement cela). Ils emploient à tout-va des expressions comme « Reinforcement Learning for Calibrated Decisions » (RLCD), qui ne veulent pratiquement rien dire pour le consommateur lambda.
Il a fallu cet [article de LangChain, bien meilleur](https://www.langchain.com/blog/building-a-harness-with-jev), pour comprendre ce que fait _réellement_ Jev. Si vous voulez l'explication complète, **lisez** cet article, il en vaut vraiment la peine. Voici une infographie tirée de l'article, qui m'a complètement retourné et qui illustre le cas d'usage mieux que tout ce que TypeSafe a publié.
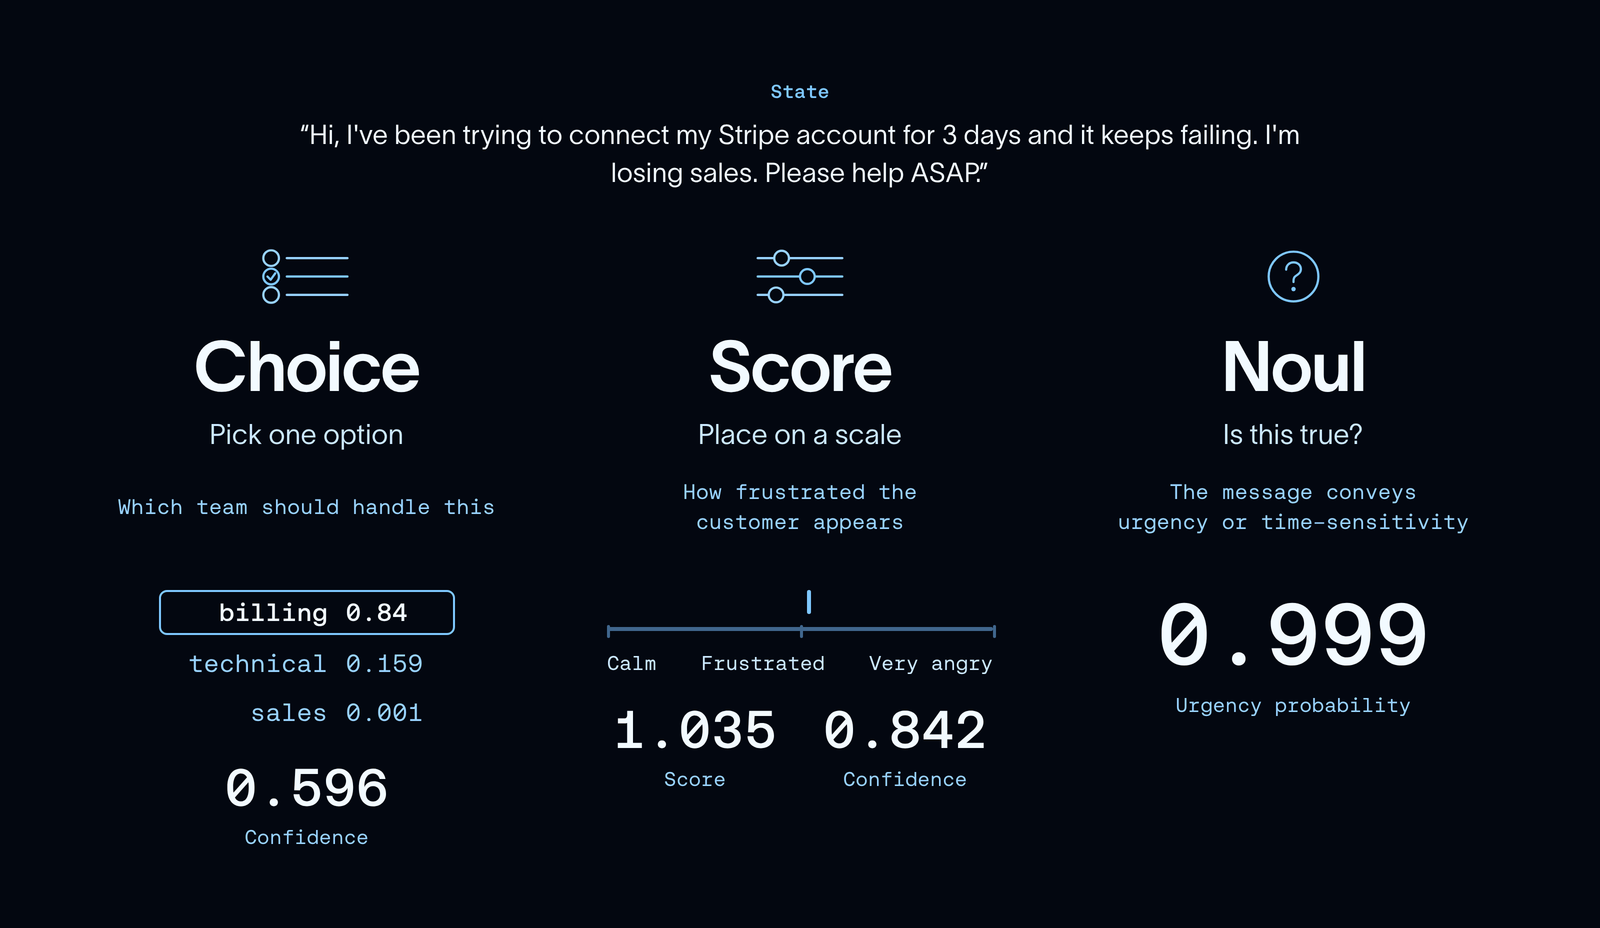 ### Une lacune hallucinante
Dès que j'ai vu cet exemple, un monde de possibilités s'est ouvert à moi, et mon esprit a été submergé par toutes les solutions que cela apportait aux problèmes auxquels je faisais face. J'ai compris que cela résolvait des problèmes dans deux de nos futurs projets, [Infinilang](https://apps.hex.pro/fr/infinilang) et [kcalc.ai](https://kcalc.ai) (le site de ce dernier n'est pas terminé à l'heure où j'écris ces lignes).
Les deux projets reposent sur des LLM pour fonctionner. Je ne suis pas du genre à fourrer de l'IA dans n'importe quoi pour prouver quelque chose, et ce n'est pas le genre d'entreprise que je veux diriger. J'ai imaginé ces deux projets séparément, au fil du développement des outils d'IA de ces 4 dernières années, et ils apportent des solutions réellement innovantes à des problèmes auxquels l'humanité se heurte depuis des années.
_Je vais présenter rapidement ces deux projets pour vous donner le contexte, mais cet article porte surtout sur Infinilang, alors sautez la partie sur kcalc.ai si vous manquez de temps._
#### kcalc.ai : le calculateur de calories qui utilise vraiment l'IA
Vous avez déjà essayé de perdre ou de prendre du poids ? Moi, oui. J'ai fréquenté la salle de sport pendant trois ans avant de comprendre que l'entraînement en force ne représentait qu'un tiers de l'équation en musculation. Les deux autres tiers, c'étaient le _sommeil_ et l'**apport calorique**. Malheureusement pour moi, prendre du poids n'est pas mon fort, et manger plus que ce dont j'ai besoin pour maintenir mon poids était trop difficile.
J'ai essayé un de ces calculateurs de calories qu'on trouve dans les boutiques d'applications. Vous voyez le genre : on note ce qu'on mange tout au long de la journée et on essaie d'atteindre un objectif. Le concept est excellent, mais l'exécution est presque toujours désastreuse. On passe plus de temps à saisir ses repas et à corriger l'équilibre des macronutriments et les calories qu'à manger. Ces applications proposent généralement aussi une fonction appareil photo, qui marche environ 20 % du temps et ne trouve _jamais_ les bonnes macros, la bonne portion ou les bonnes calories. Elles sont aussi quasiment inutiles pour les plats faits maison et les aliments qui sortent de l'ordinaire.
Là où kcalc.ai se démarque, c'est que l'application vise à rendre la saisie beaucoup moins pénible. Lorsque vous prenez une photo ou effectuez un scan LiDAR, un pipeline d'indices complexe en 15 étapes traite l'information. Il combine des LLM, une base de données vectorielle, une immense base de données d'aliments et de recettes, des modèles de vision, la reconstruction 3D de scans LiDAR, des agents de raisonnement en plusieurs étapes, et bien plus encore.
Concrètement, la partie IA de cette application a été un chantier colossal. Rien d'étonnant à ce que peu de gens s'y soient essayés : cela demande une immense expérience en génie logiciel et une réflexion systémique poussée que peu possèdent. Ce ne serait tout simplement pas possible sans l'aide d'un agent de codage IA, ou sans 10 millions de dollars américains et une année de travail de 5 ingénieurs.
kcalc.ai devait régler un certain nombre de problèmes sérieux pour devenir commercialement viable. Les deux plus gros étaient l'**évaluation de la précision** et la **vitesse**.
Prenons un scénario.
> L'utilisateur envoie une photo de « Frites belges à la mayonnaise ».
Le pipeline d'indices traite l'image, et la combinaison de ses différentes phases, associée à plusieurs étapes de raisonnement par LLM, aboutit à la conclusion qu'il s'agit bien de frites belges, probablement avec de la mayonnaise. Ce qui est intéressant avec kcalc.ai, c'est que l'application ne renvoie pas forcément une fiche préconfigurée à l'utilisateur. Elle génère une fiche à la volée, en fonction du contexte et de mesures de taille réelles, avec des calculs de volume. Tout cela est bien beau. Ça fonctionne, même s'il faut environ 2 minutes pour traverser tout le pipeline.
L'application comprend une fonction « World Atlas » qui permet aux utilisateurs de collectionner les cuisines nationales, ou « classiques », et de remplir leur carte du monde. Il faut donc vérifier une liste de cuisines à la fin de l'identification des aliments. Comment faire ? Traditionnellement, on aurait utilisé une expression régulière (Regex) ou un algorithme de similarité pour parcourir la liste et trouver les correspondances probables. C'est la première chose que j'ai essayée, et elle a conduit à des erreurs systématiques : le système attribuait des entrées de l'atlas en confondant des plats aux noms proches. Le choix évident suivant consistait à récupérer les correspondances probables et à laisser un LLM choisir la plus appropriée. Le problème, c'est que cela consommait trop de ressources de calcul, et je ne pouvais pas justifier de bloquer l'estimation des calories pour une fonction secondaire.
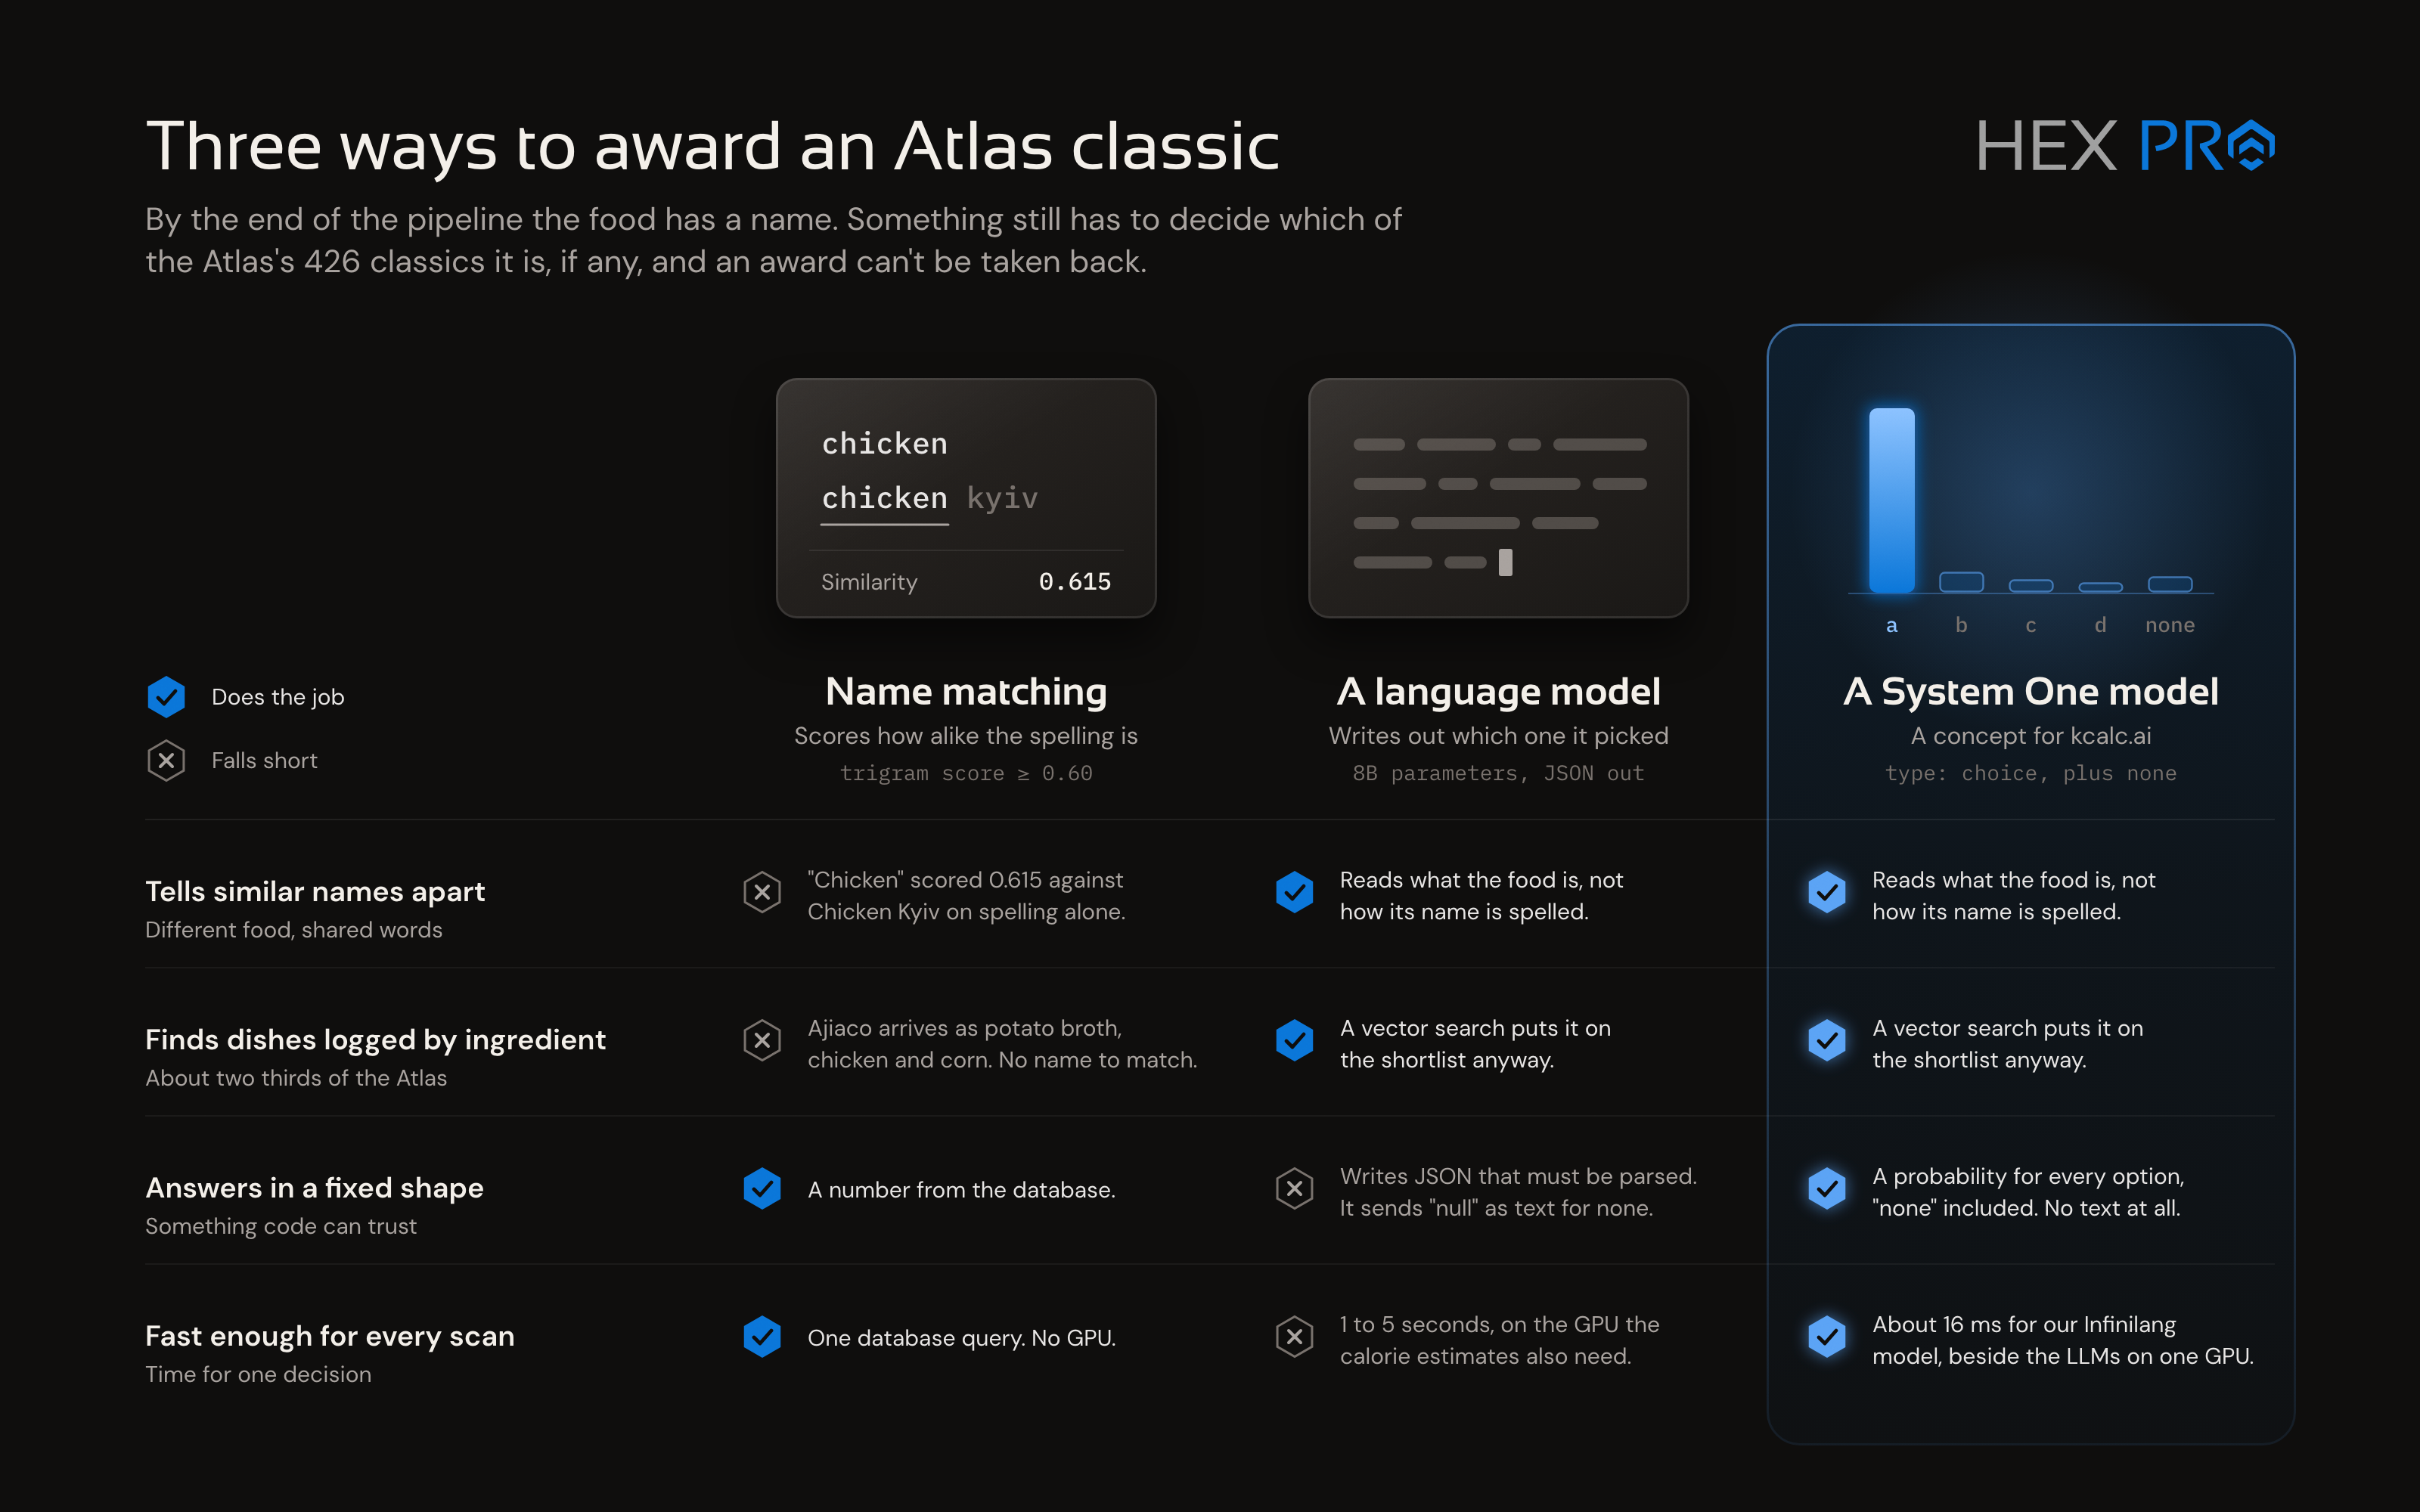 Un modèle System One, associé à une base de données vectorielle, apporte la solution.
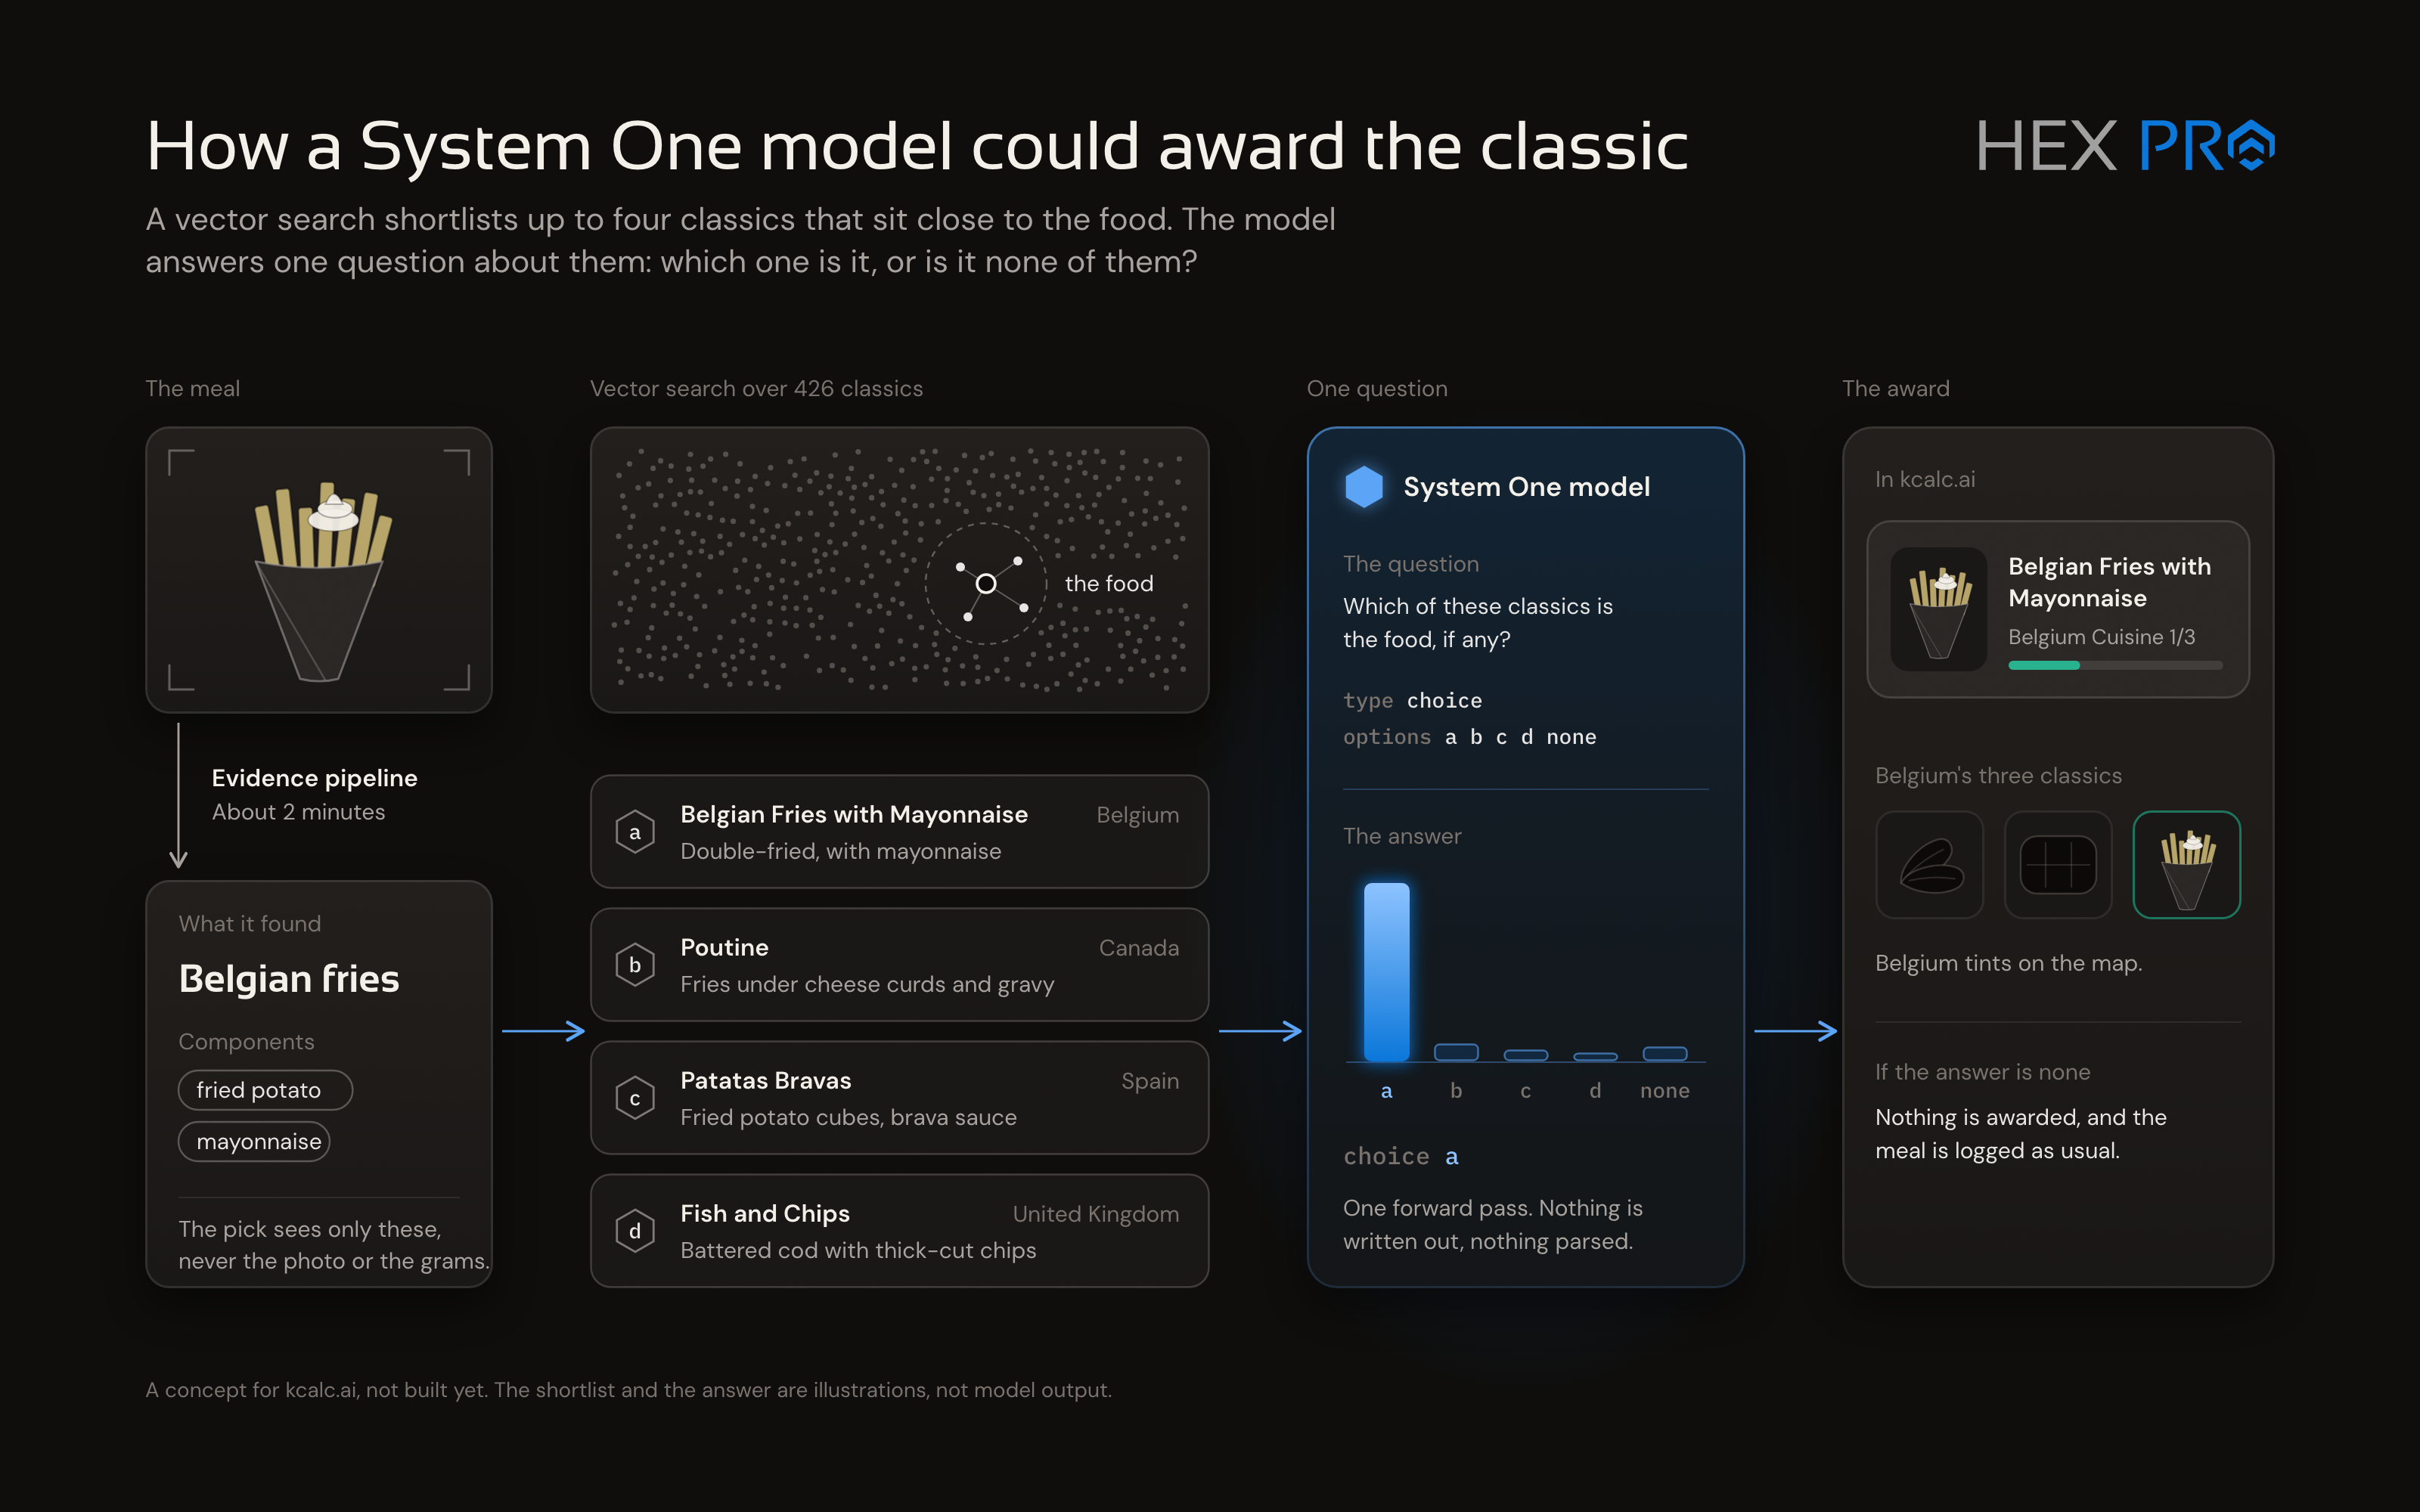 Avec un modèle System One, il suffit de quelques millisecondes pour obtenir une sélection précise, et le coût en ressources est dérisoire comparé à celui d'un LLM complet. C'est une bouée de sauvetage dans les situations où beaucoup d'options peuvent se ressembler.
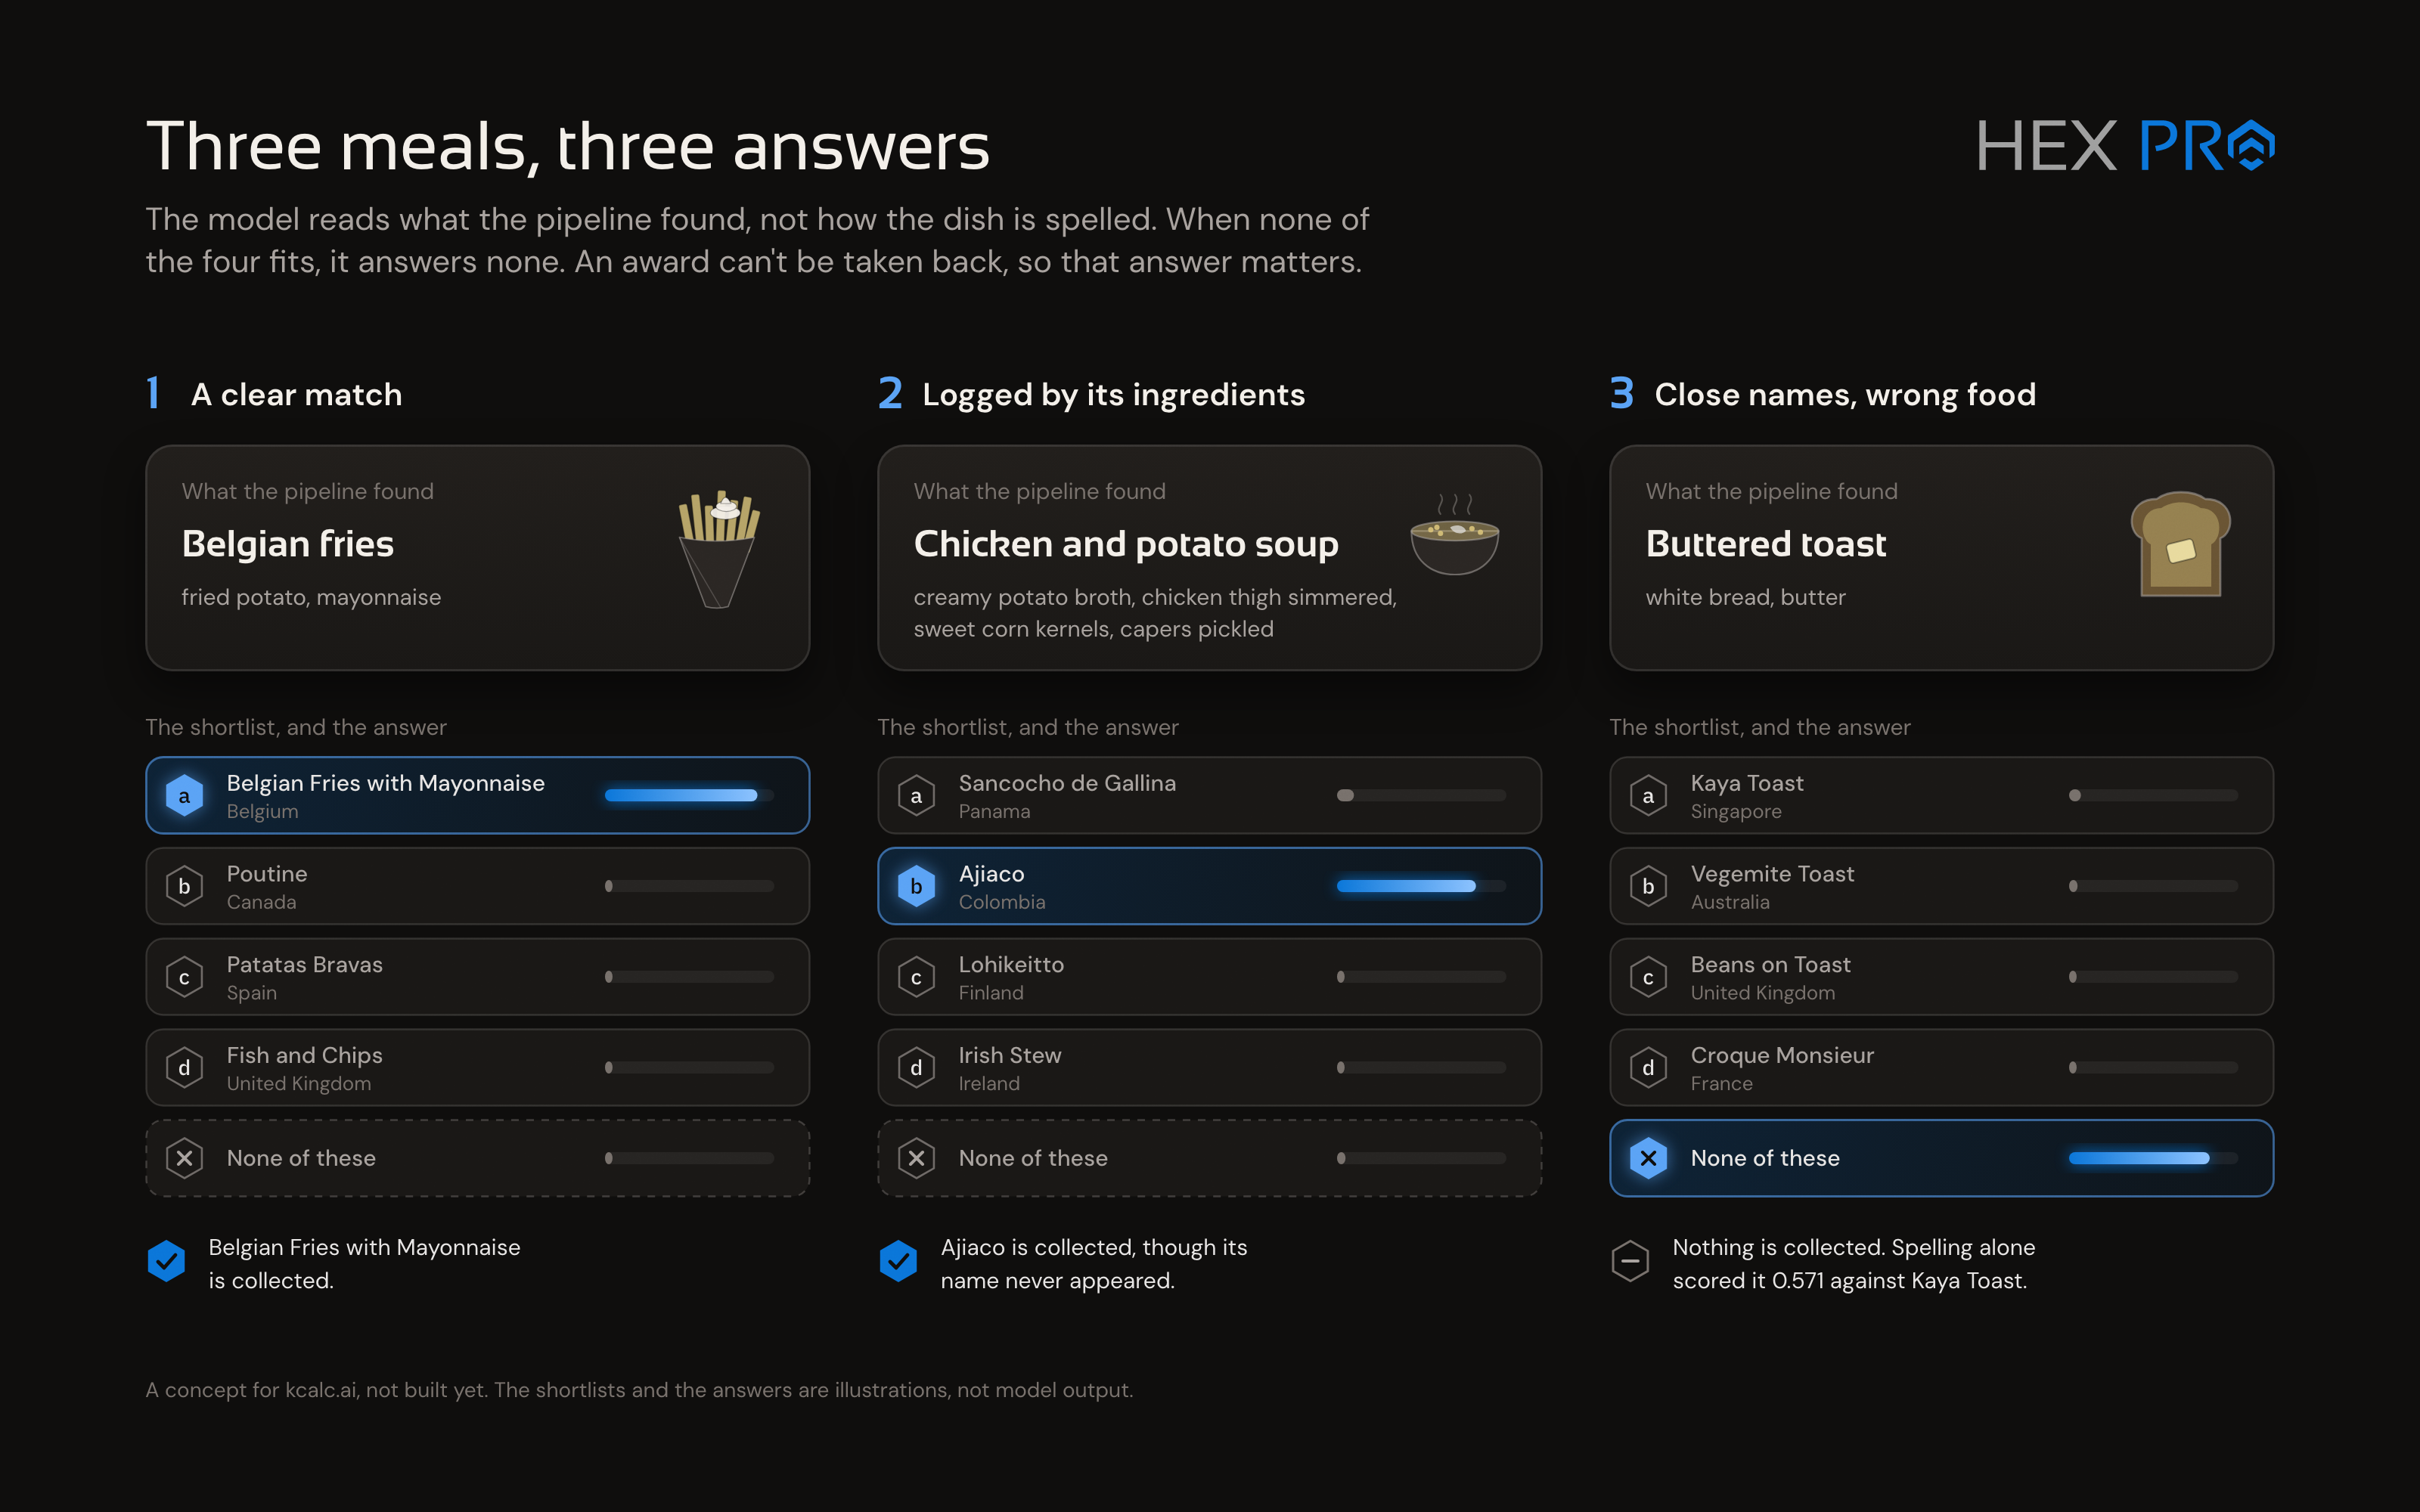 Ce qui fait la vraie beauté de l'interface des modèles System One, c'est qu'elle est incroyablement simple à intégrer. Vous pourriez trouver des centaines d'endroits où la glisser dans votre code, et c'est si bon marché et si rapide qu'on n'a même pas besoin d'y réfléchir à deux fois. Ce n'est qu'un exemple parmi les nombreux endroits où, selon moi, kcalc.ai profitera de cette nouvelle technologie.
#### Infinilang : le meilleur ami de l'apprenant en japonais
En éternel apprenant du japonais, avec très peu de temps et (pour être honnête) peu de talent pour les langues, j'ai acquis une maîtrise à peu près passable de la langue. Assez pour me débrouiller au Japon et même lancer quelques conversations amusantes dans les bars, mais pas tout à fait assez pour échapper aux « nihongo jyouzu » (« Vous parlez si bien japonais ! »).
L'un des aspects les plus délicats de l'apprentissage du japonais, ce sont les « kanji », le troisième jeu de caractères du système d'écriture japonais, et le plus fourni. Voici un exemple de chacun des trois jeux de caractères :
- **Hiragana** : ありがとうございます (romanisation _arigatou gozaimasu_, « Merci beaucoup »)
- **Katakana** : コールドブリューアイスコーヒー (romanisation _korudo buru aisu kohi_, « Café glacé infusé à froid »)
- **Kanji** : 人工知能 (romanisation _jinkou chinou_, « Intelligence artificielle »)
Les kanji sont issus des caractères chinois et en partagent certains sens, mais se prononcent généralement de façon complètement différente. Là où ça se complique, c'est qu'il faut connaître 2 136 kanji courants pour savoir lire au quotidien, et environ 4 000 pour approcher l'aisance d'un locuteur natif. Pire encore, les kanji ont souvent plusieurs _lectures_, c'est-à-dire qu'ils se prononcent différemment selon l'endroit où ils sont employés. _Un pur cauchemar à apprendre_.
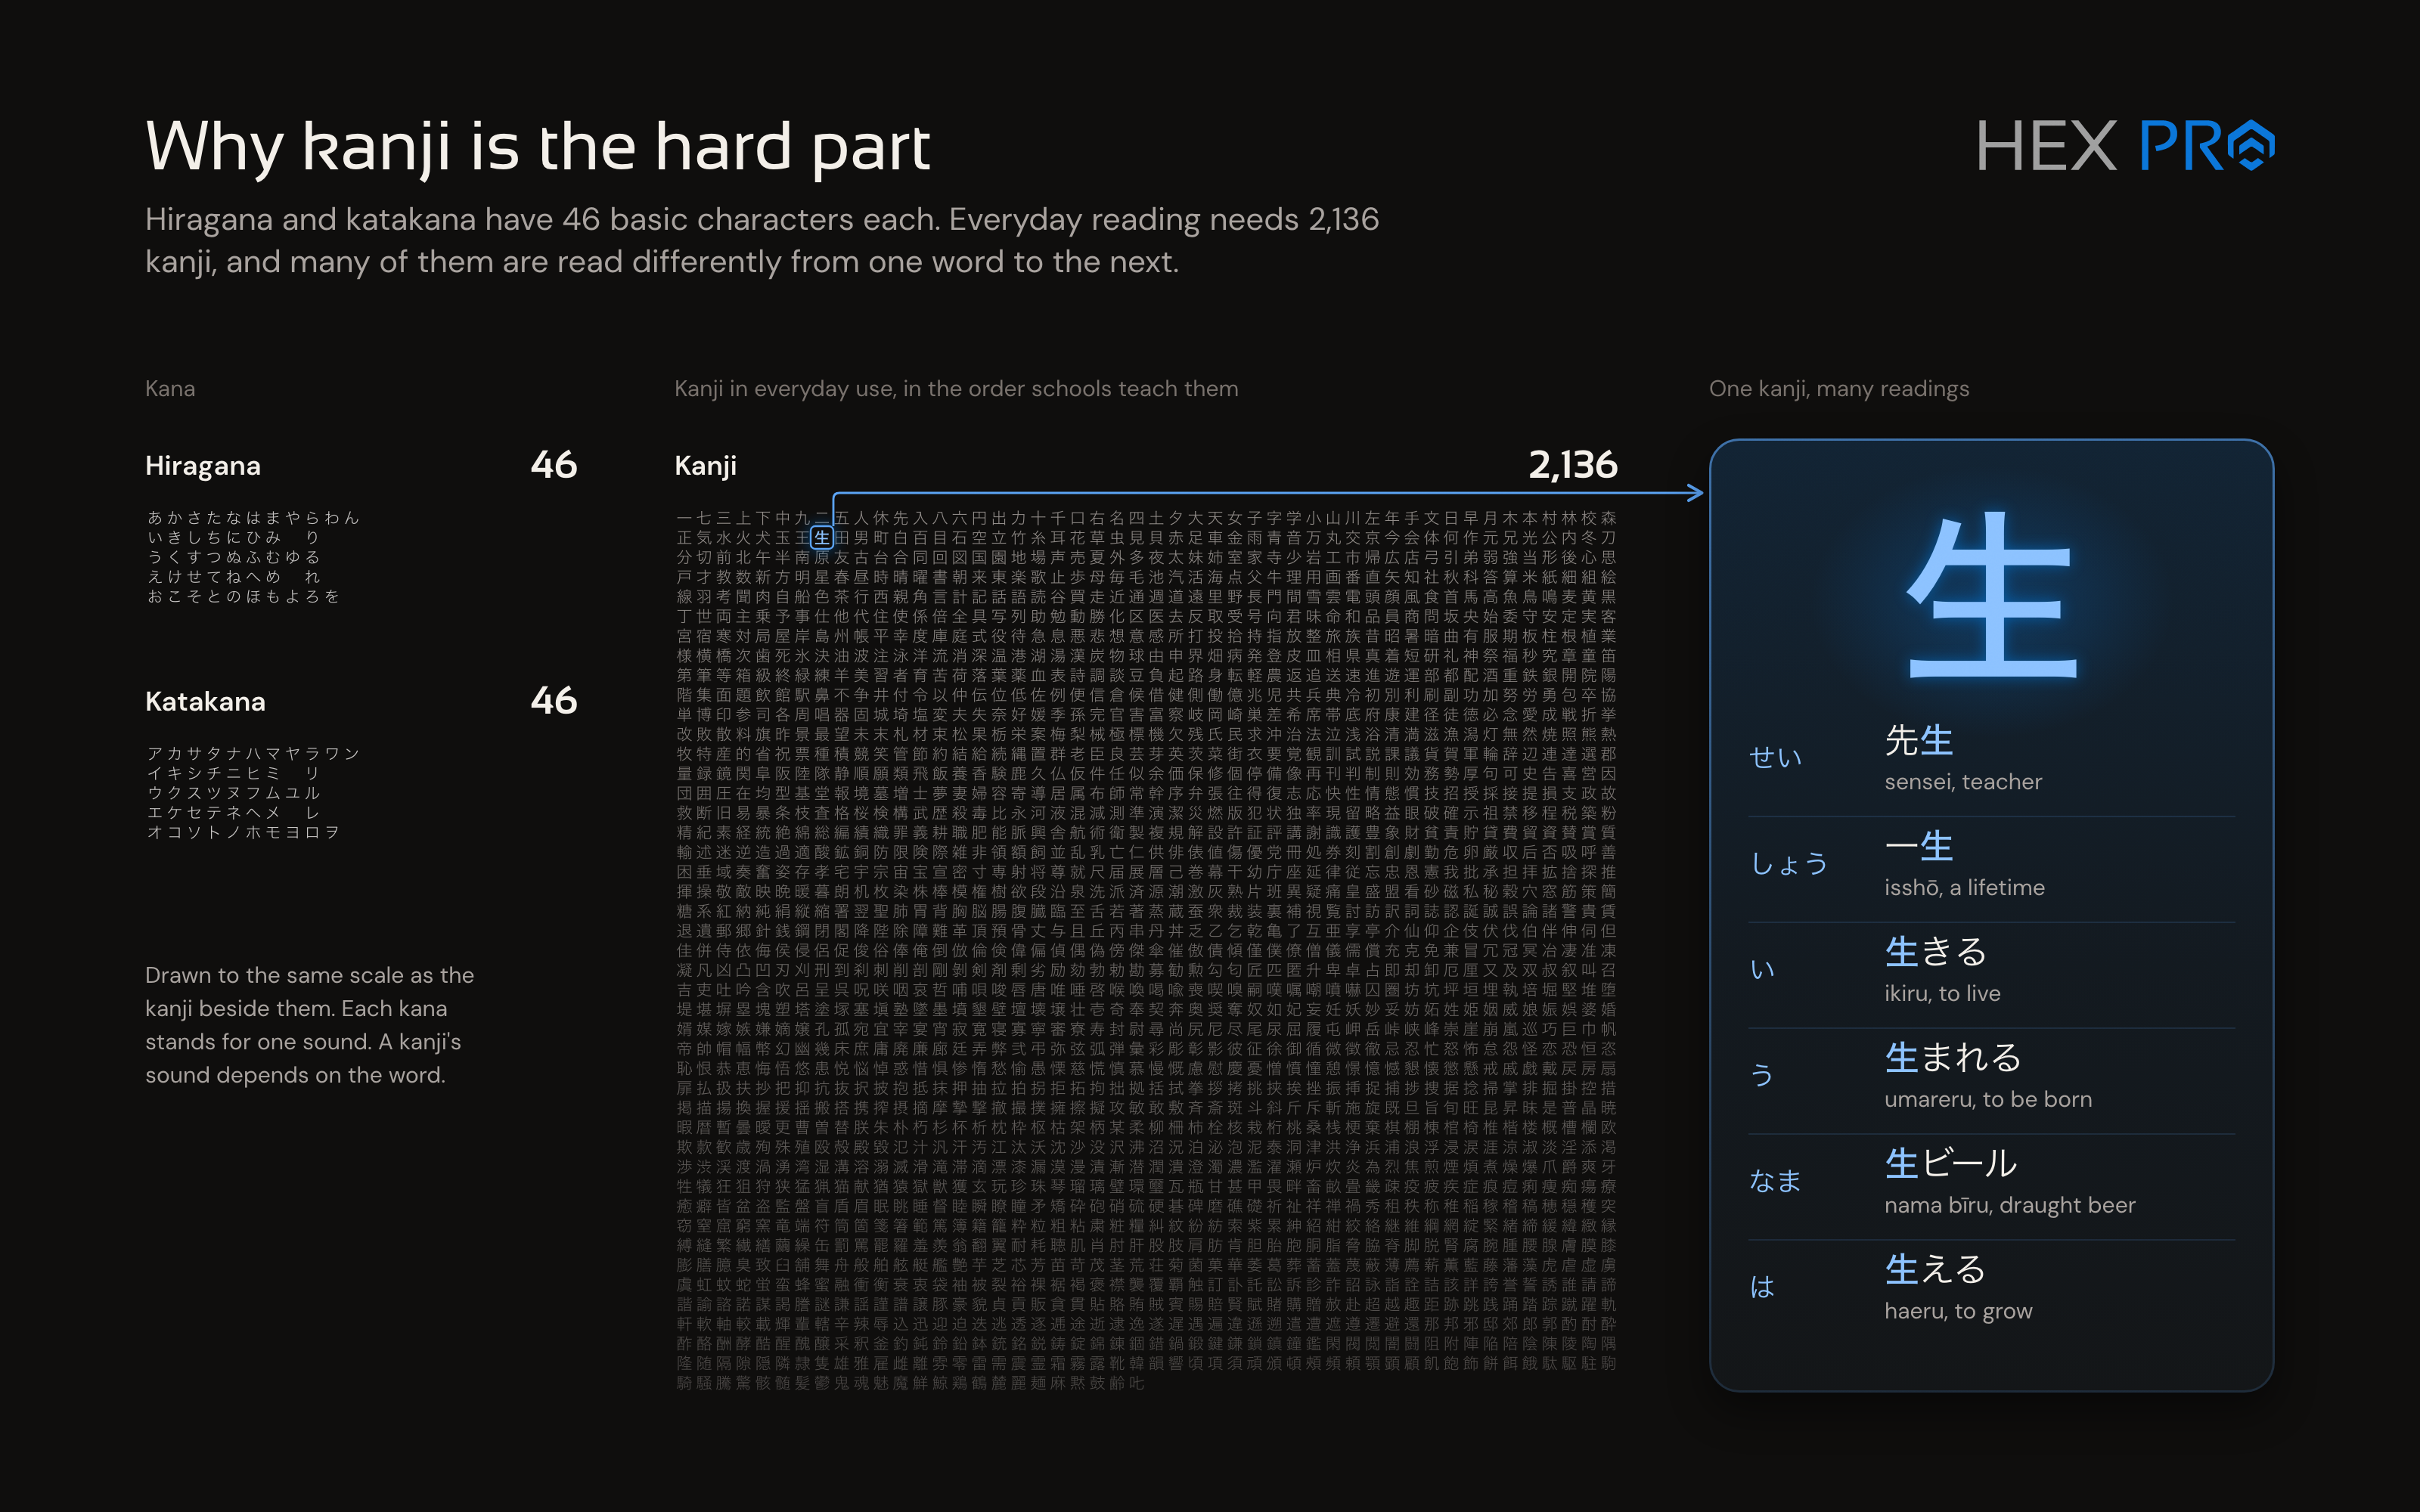 Quand GPT-3 d'OpenAI est sorti, j'ai fait partie des premiers utilisateurs et j'ai très tôt entrevu les possibilités quasi infinies de cette technologie. La plus importante, pour moi, était un apprentissage des langues sur mesure, un moyen d'apprendre une langue plus efficacement que jamais.
J'ai imaginé à l'époque trois applications inédites des LLM, et j'ai ruminé ces idées pendant des années. Entre-temps, j'ai développé deux générations de prototypes de cette technologie et prouvé qu'elle fonctionne bel et bien.
## L'efficacité de l'intelligence artificielle pour accélérer l'acquisition des langues
Ce titre délicieusement universitaire était celui du mémoire de master sur lequel je travaillais, autour de l'idée d'Infinilang. Au départ, je comptais publier ces outils sous forme de recherche open source, mais un emploi à temps plein et des ressources limitées ont rendu cela trop compliqué. Je compte donc plutôt commercialiser d'abord Infinilang sous la forme d'une application mobile à code source fermé. Plus tard, je compte la publier sous la forme d'une application de bureau open source, avec la possibilité d'apporter sa propre IA.
Qu'apporte donc Infinilang ? Pour un apprenant en japonais, mémoriser les kanji n'est qu'un aspect de l'apprentissage d'une lecture efficace. La mémorisation est aujourd'hui un processus lent et fastidieux qui passe par des systèmes de répétition espacée (SRS). Les plus connus sont Anki et WaniKani, ce dernier étant mon préféré. Un SRS montre des cartes mémoire à l'utilisateur de façon répétée, en allongeant progressivement l'intervalle entre chaque présentation. Le système est conçu pour vous montrer un caractère appris juste avant que vous ne l'oubliiez, à chaque fois. Plus vous voyez la carte, plus vous retenez l'information longtemps, et cette rétention est d'autant plus efficace que vous la voyez de moins en moins souvent. Le SRS est, [preuves à l'appui, la meilleure méthode pour **mémoriser** les kanji](https://doi.org/10.1037/0033-2909.132.3.354), mais là où il pèche le plus, c'est pour vous apprendre à _lire_ efficacement des phrases qui contiennent des kanji.
> Lisez donc des articles de NHK Easy, ou des livres pour enfants.
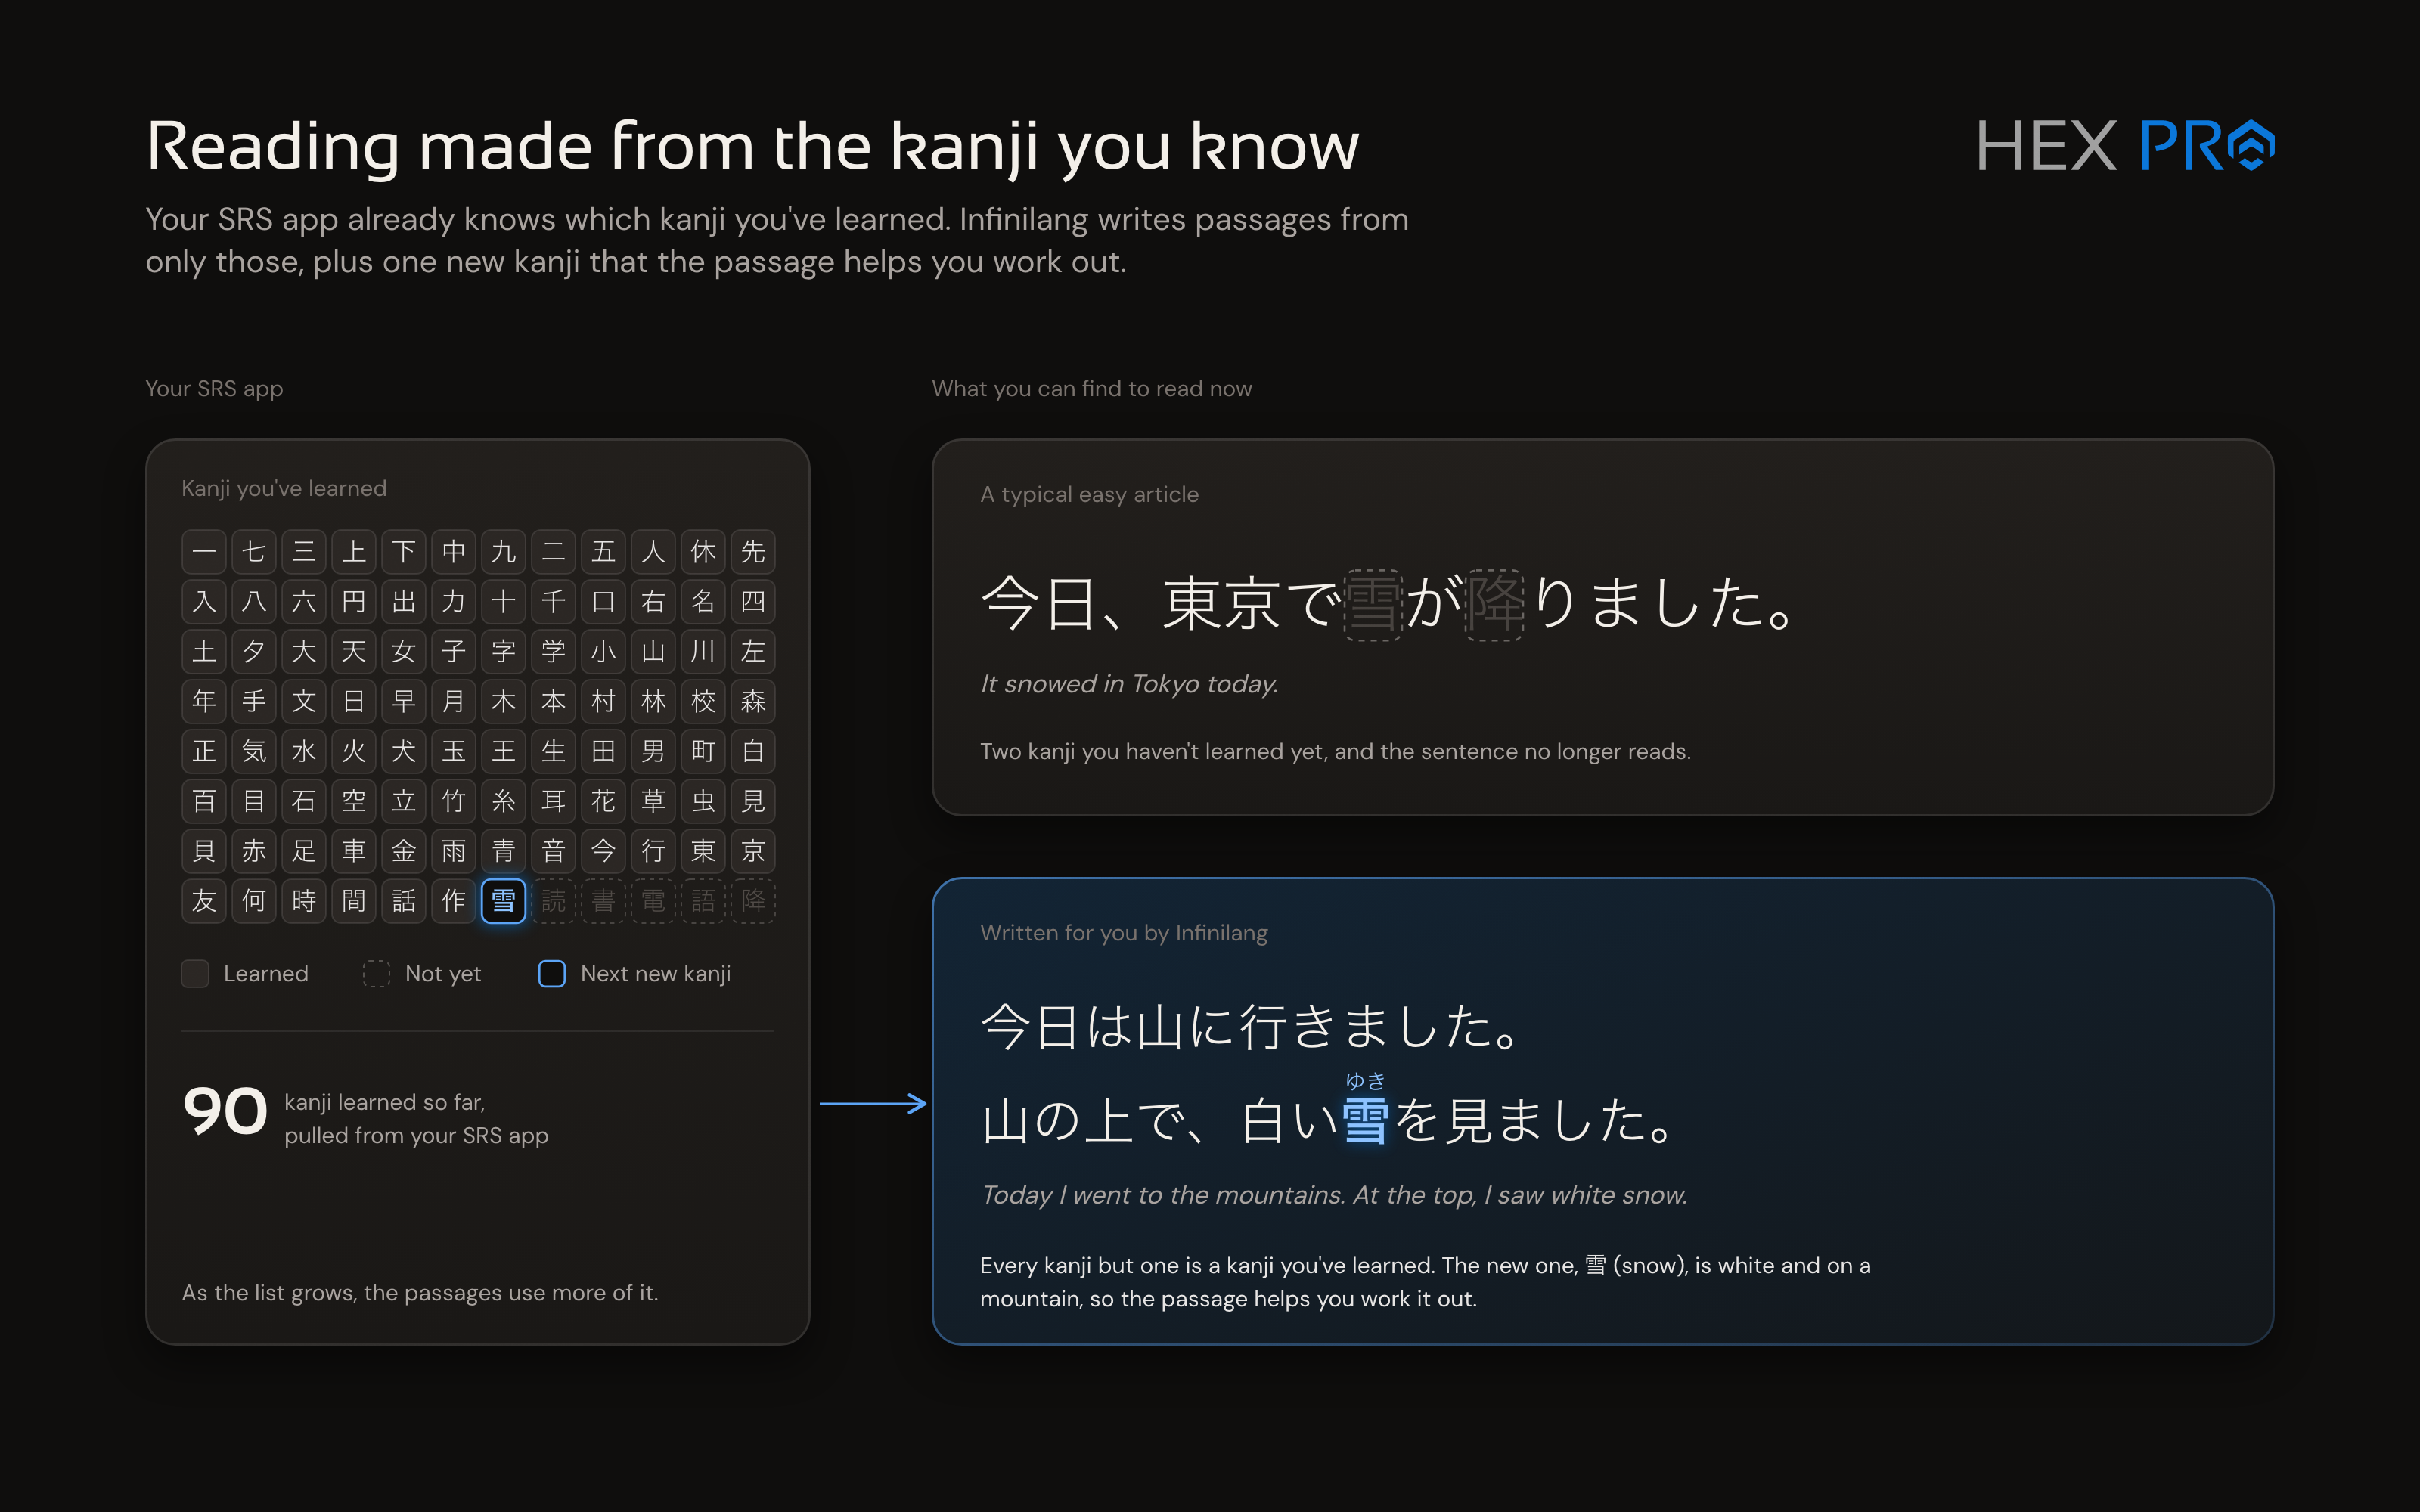
Le conseil traditionnel a toujours été de trouver des textes faciles et de faire de votre mieux pour déchiffrer les kanji inconnus à l'aide des furigana 東京, ces petits repères de prononciation en hiragana placés au-dessus des kanji sur certains supports. Le problème saute aux yeux. Dès qu'il y a au moins un kanji que vous ne connaissez pas, vous butez complètement, et la phrase devient souvent illisible.
Voici donc l'idée. Les applications de SRS offrent un excellent suivi des kanji que vous avez appris et de votre niveau de maîtrise pour chacun. Et si vous pouviez trouver des textes composés uniquement de kanji que vous avez appris ? C'est exactement ce dont les LLM sont capables, et c'est là qu'Infinilang entre en jeu.
### Générer des textes japonais sous contrainte
L'objectif d'Infinilang (phase 1) est de produire des textes adaptés exactement au niveau de l'utilisateur. Nous fournissons à un LLM les kanji que vous avez appris, récupérés directement depuis votre application de SRS, puis nous générons des phrases avec ce jeu de caractères restreint. Ce n'est pas aussi simple que de donner le jeu de caractères à un LLM pour obtenir d'excellents textes. Dompter l'IA pour qu'elle accomplisse bien cette tâche est bien plus difficile qu'on ne l'imagine. Mais ça _marche_.
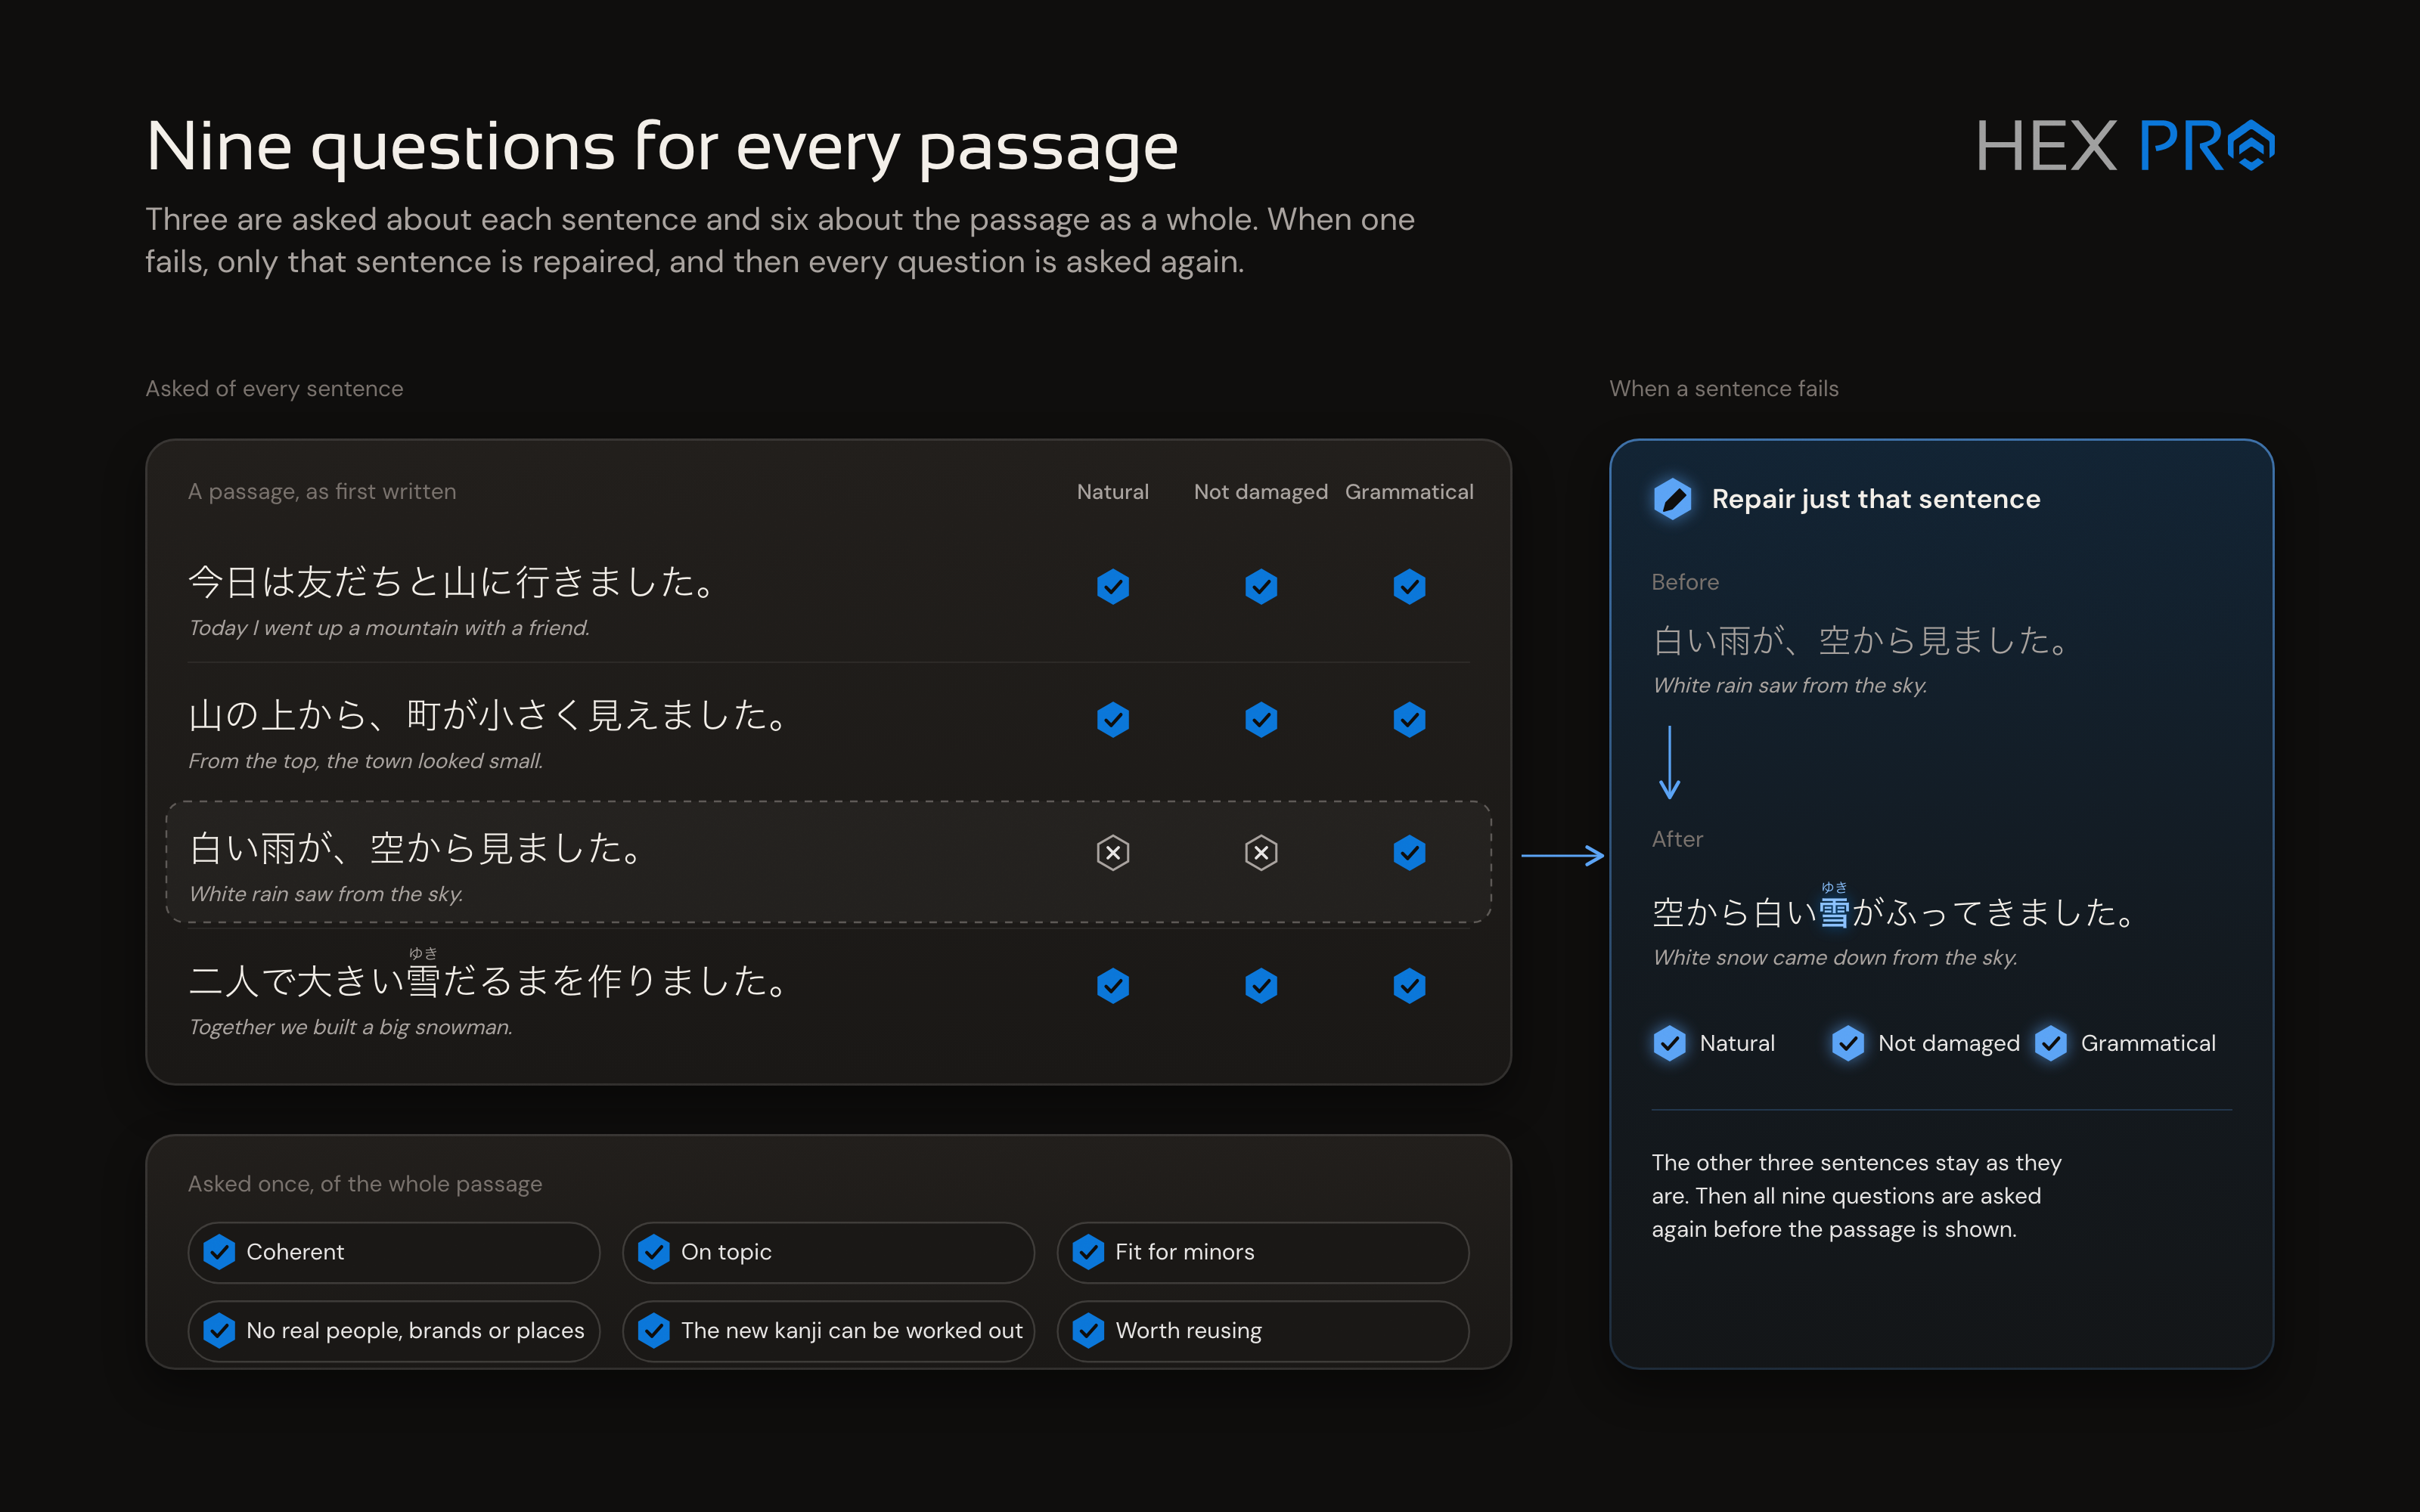
 Les difficultés rencontrées pour produire des textes de qualité se répartissent en plusieurs familles : pour l'essentiel, des questions à poser pour s'assurer que le LLM ne s'est pas trompé et, s'il s'est trompé, pour savoir si l'on peut corriger ses erreurs sans générer une réponse entièrement nouvelle.
- À quel point la phrase est-elle naturelle ?
- La phrase donne-t-elle l'impression d'avoir été filtrée ou abîmée ?
- Le passage est-il cohérent ?
- Le passage reste-t-il dans le sujet ?
- Le passage convient-il aux mineurs ?
- Contient-il des personnes, des marques ou des lieux réels ?
- Une insertion N+1 peut-elle se déduire du contexte ?
- Le passage vaut-il la peine d'être réutilisé à l'avenir ?
- La phrase est-elle grammaticalement correcte ?
Cette liste n'est pas exhaustive, mais ce sont les principales questions à se poser sur le contenu généré.
### Des crédits, des crédits et encore des CRÉDITS D'API
Une chose est vite devenue d'une évidence criante : passer par l'API d'un LLM tiers coulerait le projet dès le départ. Les crédits d'API sont tout simplement trop chers, et engloutiraient l'essentiel des revenus des abonnements. Ou pire, ils nous feraient carrément perdre de l'argent.
Il n'y avait qu'une solution : construire notre propre infrastructure d'IA. Pas simple quand on monte une startup avec peu de capitaux. La bonne nouvelle, c'est que les petits LLM gagnent en capacités tous les quelques mois. Ils ne sont certes pas au niveau des modèles les plus avancés, et je ne peux que rêver de travailler avec un LLM de la classe d'Opus. Mais avec une architecture logicielle bien cadrée et bien outillée (c'est-à-dire beaucoup de domptage), ces petits LLM peuvent produire des résultats de grande qualité.
Reste que l'infrastructure est modeste au départ, et que les ressources d'inférence seront limitées avec des milliers d'utilisateurs qui génèrent du contenu chaque jour. Il faut aussi générer le contenu à une vitesse raisonnable. Personne n'a envie d'attendre 2 minutes qu'un paragraphe de japonais s'affiche à l'écran, aussi bon soit-il.
Les tâches d'inférence que l'IA devrait effectuer pour chaque génération pourraient donc ressembler à ceci :
1. Générer une phrase, un paragraphe ou une courte histoire en respectant les contraintes. Cela demande sans doute un peu de raisonnement, et plus le contenu est long, plus cela prend de temps.
2. Évaluer le texte produit selon les familles de questions énumérées plus haut.
3. Faire passer les phrases par des passes de réparation chirurgicales et ciblées, là où les corrections n'ont pas pu être appliquées par programme.
4. Répéter l'étape 2 une fois de plus.
5. Éventuellement, répéter encore une fois l'étape 3 et l'étape 2 avant d'envoyer le contenu à l'utilisateur.
 Même avec un GPU de classe entreprise et la mise en cache des préfixes, ce processus peut prendre une minute ou deux, et nous n'avons que 8 emplacements d'inférence parallèle, ce qui veut dire que les tâches doivent être mises en file d'attente dès que plus de 8 personnes essaient de générer en même temps. Pas viable, à aucun point de vue.
C'est là que les modèles System One entrent en scène.
## Comment Jev a tout changé
Les modèles System One présentent sur les LLM traditionnels quelques avantages clés qui les rendent extrêmement pertinents pour des cas d'usage comme le mien.
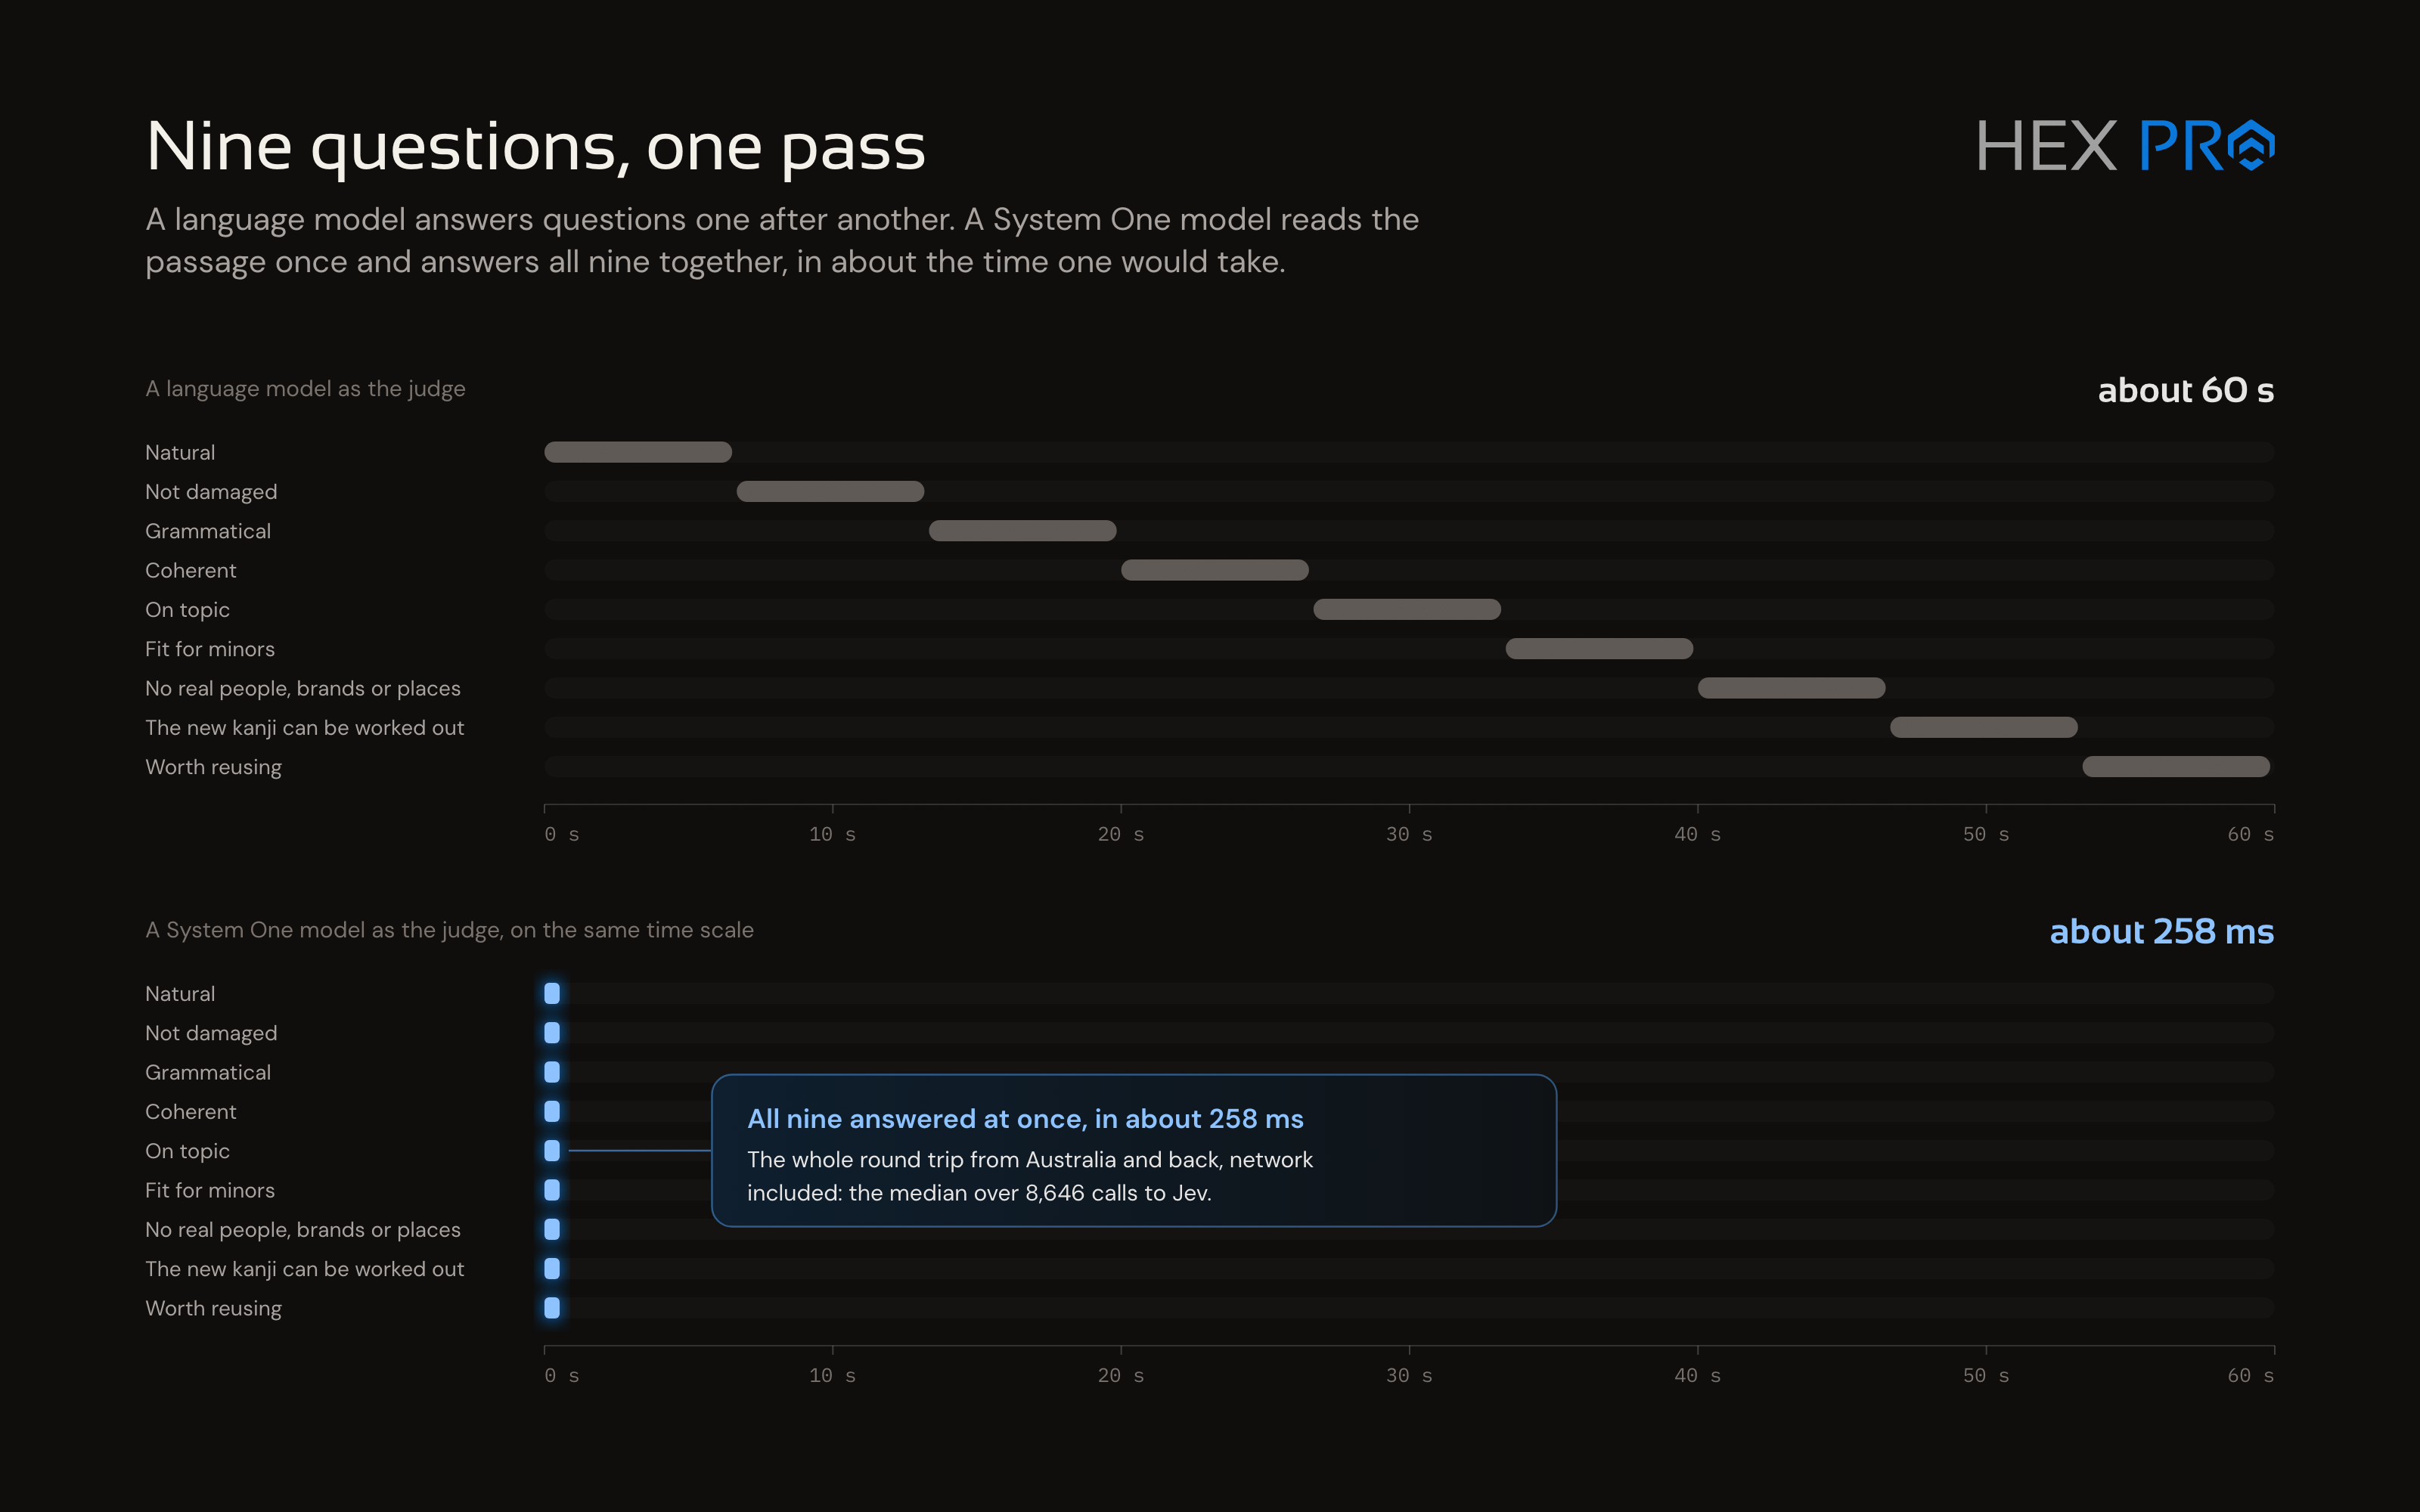
1. Ils répondent à une vitesse fulgurante. Je suis en Australie et Jev tourne depuis la Silicon Valley, et pourtant un appel revient en environ 258 ms, ping compris. C'est un avantage énorme face à un LLM traditionnel.
2. Ils répondent à de nombreuses questions en parallèle. Contrairement à un LLM, qui doit traiter les questions l'une après l'autre, les modèles System One peuvent prendre tout un lot de questions et y répondre à peu près dans le même temps qu'une seule. Autrement dit, s'il fallait **60 secondes** pour bien répondre à neuf questions avec un LLM, il ne faut que **258 ms** pour répondre à ces neuf mêmes questions avec un modèle System One. Plus vous avez de questions à poser, plus un outil comme Jev vous fait gagner.
 3. Ils sont incroyablement bon marché. Pendant ce projet, je n'ai dépensé que **0,025 dollar américain** pour 1 000 appels à Jev. L'une des leçons à retenir, c'est que Jev est **extrêmement économique** à utiliser. Je n'aurais aucun scrupule à l'intégrer partout, c'est quasiment gratuit.
Un autre avantage dont on parle peu, c'est la fiabilité. Certains LLM partent en vrille et renvoient des réponses non structurées, impossibles à traiter par programme. Jev est « typesafe », au sens où il renvoie toujours une réponse valide que l'on peut analyser.
## Laya : le concurrent open source
Ce qui m'amène à Laya, le sujet de cette expérience et sans doute la raison pour laquelle vous lisez cet article. Quelques jours à peine après la sortie publique de Jev, une flopée de projets open source sont apparus pour tenter de recréer cette technologie.
> https://github.com/NandhaKishorM/laya
Avec pas moins de 35 000 étoiles sur GitHub au moment où j'écris ces lignes, Laya a fait une entrée fracassante : plus de 1 000 commits en deux semaines à peine, et près de 3 000 aujourd'hui. Un lancement plutôt impressionnant, qui a montré à quel point la communauté du génie logiciel s'intéresse aux modèles System One.
Laya était fourni avec trois modèles de base : `laya (421M)`, `laya-multilingual (322M)` et `laya-typed-decisions (421M)`. En résumé, `laya` est le modèle polyvalent, `laya-multilingual` est meilleur pour les langues autres que l'anglais mais moins précis, et `laya-typed-decisions` offre une meilleure précision, au prix d'une moindre souplesse selon les situations et de faibles capacités multilingues.
### Les avantages de Laya
L'avantage le plus évident de Laya, c'est qu'il est open source et que vous maîtrisez l'infra. Aucun risque que Laya fasse soudain faillite et coupe ses serveurs, vous obligeant à chercher dans l'urgence un remplaçant convenable ou à voir votre logiciel tomber en panne de façon catastrophique. C'est un argument séduisant pour des entreprises comme la mienne, qui visent une forte croissance et veulent réduire les risques au minimum.
L'autre atout de Laya, c'est la petite taille de son modèle. Par défaut, il demande très peu de VRAM, et il peut même tourner sur CPU d'après le [gigantesque README.md généré par IA](https://github.com/NandhaKishorM/laya/blob/main/README.md). Si je me souviens bien, lors de mes essais, le modèle de base tournait avec 2 Go de VRAM, ce qui tenait sans peine dans mon infrastructure serveur.
### Les inconvénients moins évidents
Quand quelque chose semble trop beau pour être vrai, c'est généralement le cas. Les statistiques et les comparaisons avec Jev présentées sur la [page GitHub](https://github.com/NandhaKishorM/laya/blob/efbe194/BENCHMARKS.md) avancent des chiffres comme ceux-ci :
| | Laya | Jev (publié) |
|---|---|---|
| typed-decisions (2,000 décisions) | **0.766** | 0.727 |
| AG News (4 étiquettes) | **0.953** | 0.910 |
| DAIR Emotion (6 étiquettes) | **0.600** | 0.480 |
| ECE après ajustement de la température | **0.081** | 0.246 |
| latence p50, 1 question (T4) | **32.8 ms** | 236-276 ms |
Ça m'a l'air plutôt convaincant. Alors, où est le piège ? Regardez les thèmes sur lesquels les modèles de Laya ont été testés.
| thème | laya | laya-multilingual | laya-typed-decisions | données |
|---|---|---|---|---|
| Spam par e-mail | **0.993** | 0.993 | 0.958 | dans l'entraînement |
| Hameçonnage | 0.980 | **0.993** | 0.940 | dans l'entraînement |
| Garde-fous de LLM (jailbreak) | 0.708 | 0.755 | **0.762** | **hors entraînement** |
| Modération (toxicité) | **0.530** | 0.525 | 0.530 | **hors entraînement** |
| Pertinence des passages RAG | 0.625 | **0.657** | 0.625 | dans l'entraînement |
| Tri du support (10 files d'attente) | 0.502 | **0.522** | 0.505 | dans l'entraînement |
| Routage de modèles (domaine) | 0.639 | 0.123 | **0.659** | hors entraînement |
« Spam par e-mail », « hameçonnage », « pertinence des passages RAG » et « tri du support » : des thèmes très spécifiques, et très révélateurs des inconvénients. Vous remarquerez que « garde-fous de LLM », « modération » et « routage de modèles » sont marqués « hors entraînement », et c'est une distinction importante.
Pour faire simple, Laya n'est pas un modèle one-shot. Vous ne _pouvez pas_ simplement le prendre et le brancher sur n'importe quel cas d'usage. Tel qu'il est fourni, il a des capacités très spécifiques et il est pratiquement inutile pour tout le reste. C'est le premier domaine où Jev montre vraiment ce qu'il vaut : « ça marche, tout simplement ». Mes premiers tests avec Infinilang et le modèle `laya-multilingual` ont été des échecs cuisants : il n'a été capable d'accomplir correctement **aucune** des tâches demandées.
## Entraîner un modèle personnalisé pour Laya : infini-jp-v1
Après ce premier échec, je n'ai pas baissé les bras tout de suite. Comme kcalc.ai et Infinilang sont encore loin de la mise en production, j'ai une sérieuse infrastructure serveur qui dort, pratiquement inutilisée. Autrement dit, Qwen 3.8 27B attend sagement qu'on lui donne du travail, et je peux l'arrêter pour faire de l'entraînement dès que j'ai besoin d'un GPU puissant. L'heure était venue de faire quelques expériences.
### Les règles du jeu
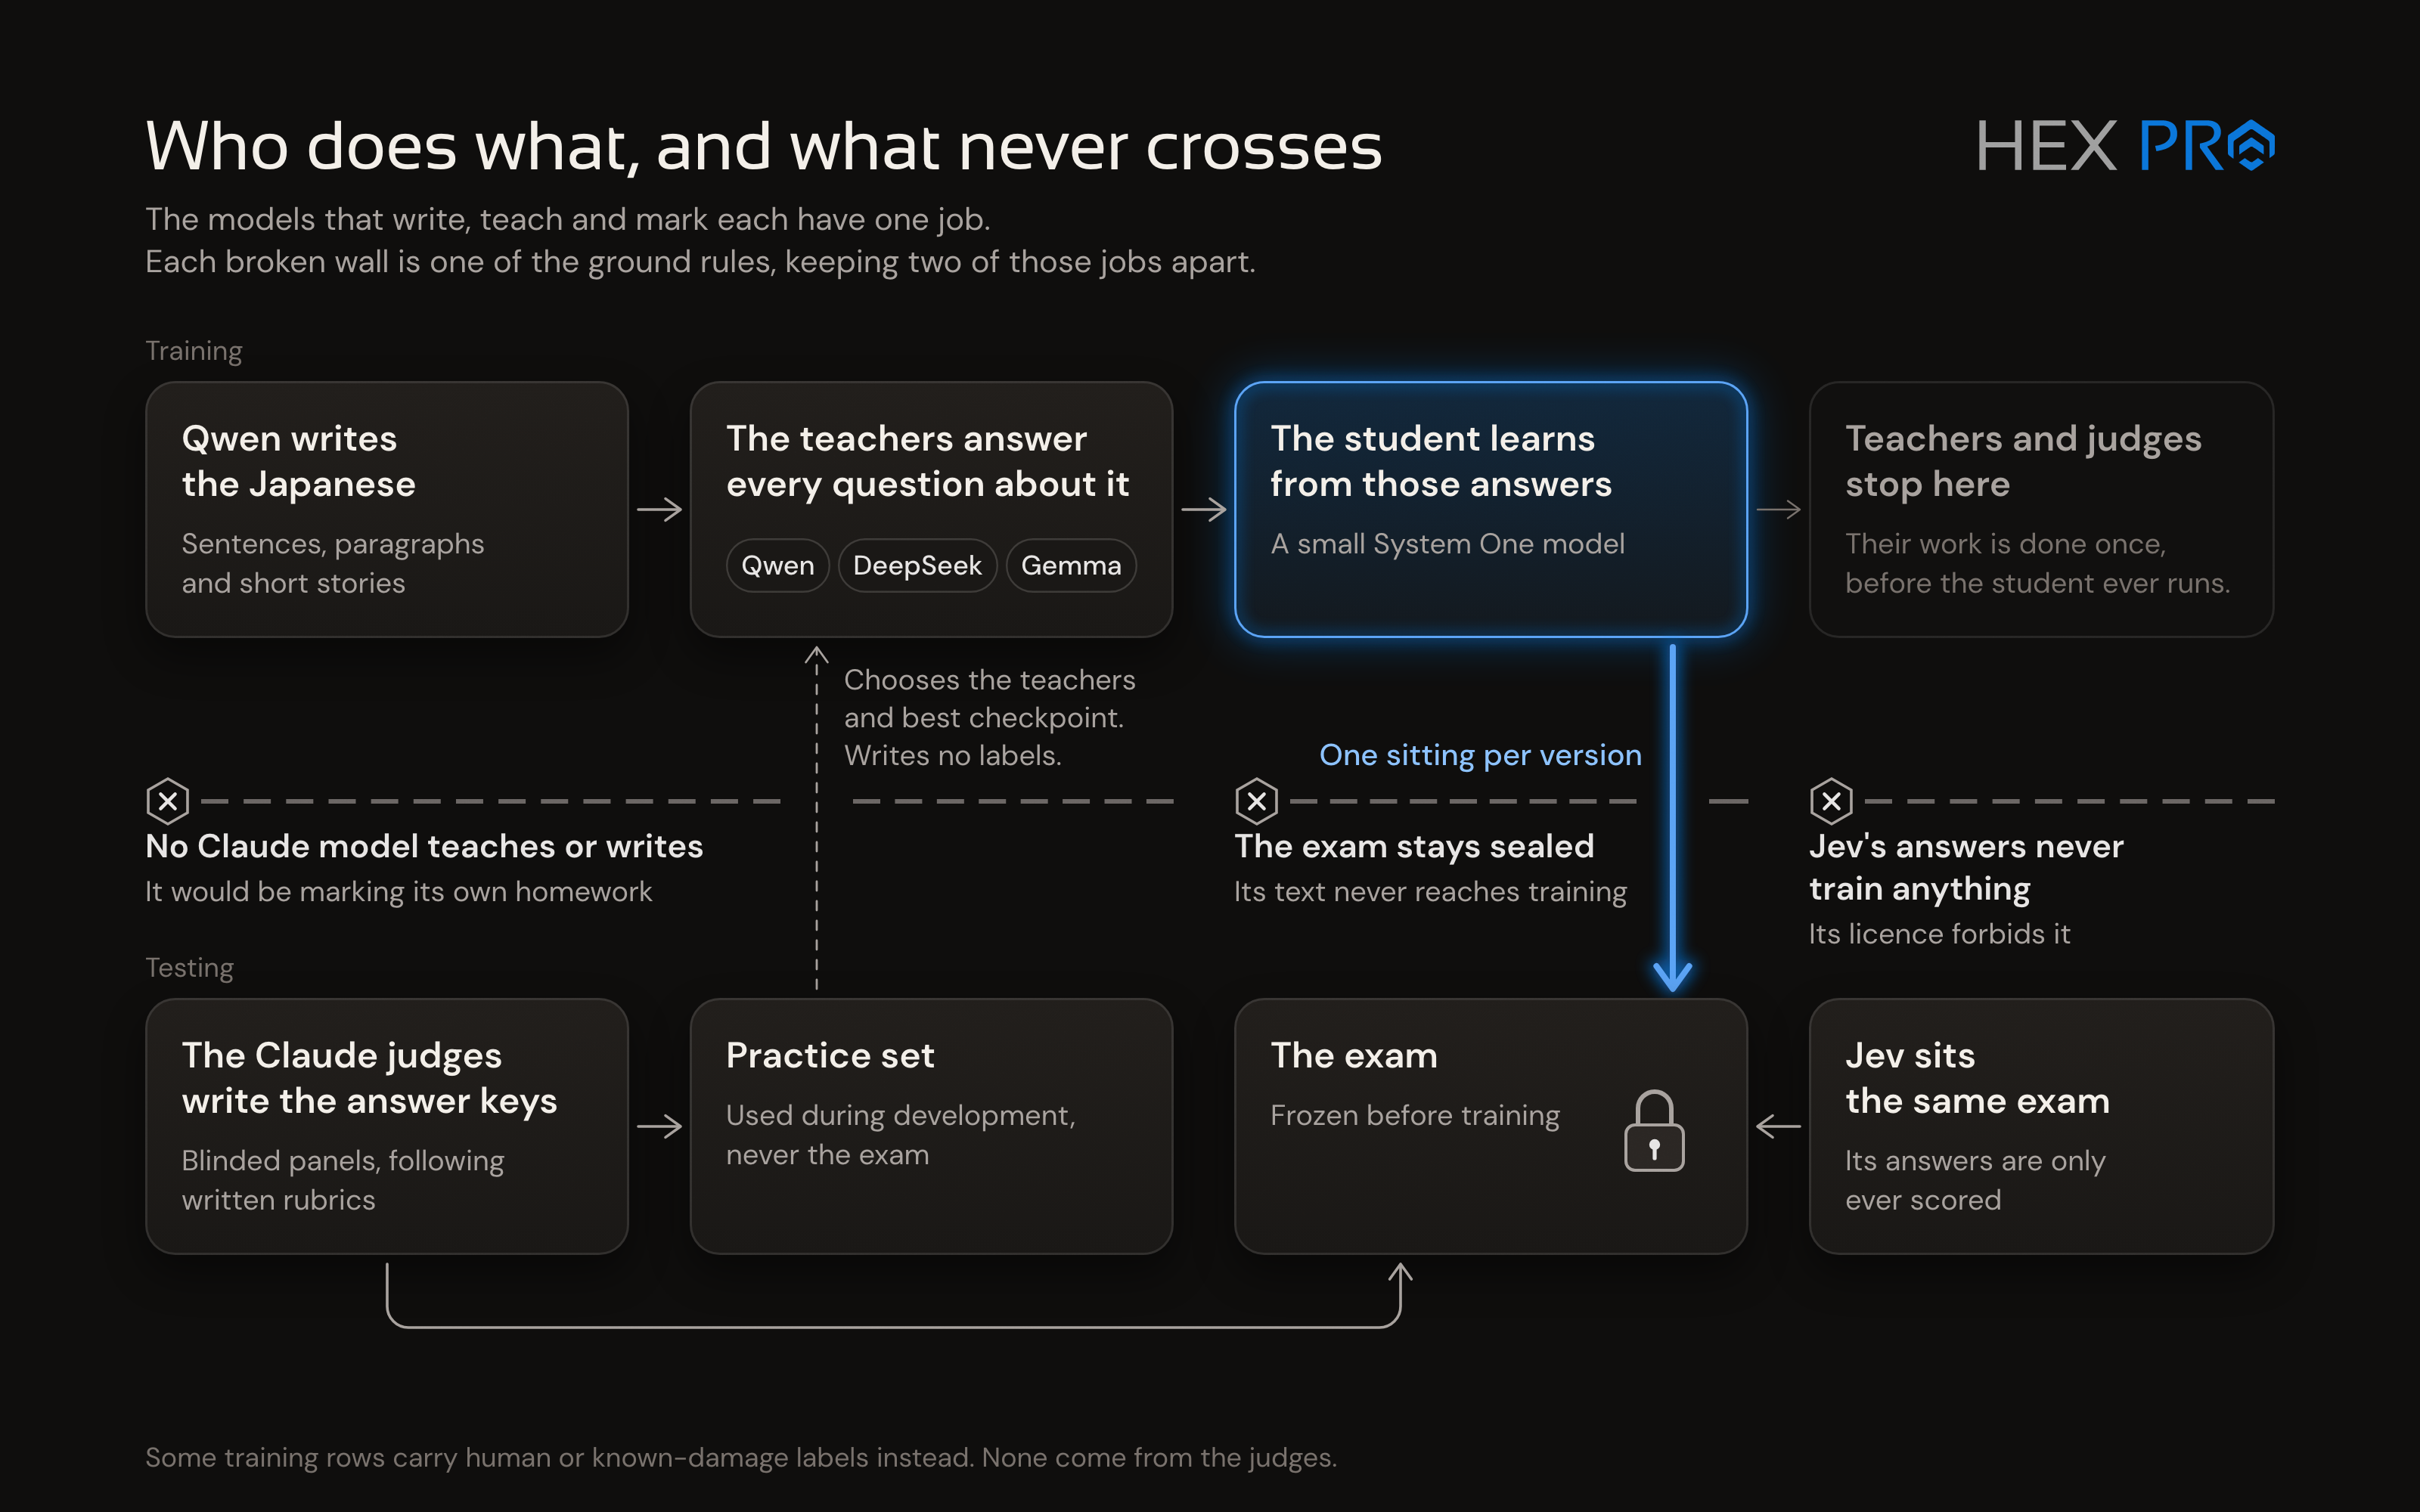 | Règle | Pourquoi | Comment elle a été respectée |
| --- | --- | --- |
| Les sorties de Jev n'entraînent jamais rien | La licence de TypeSafe interdit la distillation | Des contrats d'import, un hook d'audit qui refuse tout lecteur de `quarantine/` hormis le module de rapport, une enum de sources d'étiquettes sans membre Jev |
| Ni enseignant ni générateur Claude | La référence est un panel Claude ; un enseignant Claude corrigerait sa propre copie | Un garde-fou d'indépendance portant sur la famille, la lignée déclarée, l'identifiant du modèle et l'hébergeur. Anthropic interdit d'utiliser ses modèles pour l'entraînement, nous avons donc utilisé des modèles à poids ouverts pour l'entraînement. |
| Le benchmark se consomme avec parcimonie | Chaque regard sur la référence de test l'affaiblit | Un seul essai par version et par benchmark, un jeton propriétaire à usage unique par essai, un journal d'accès chaîné par hachage, et aucun chiffre de benchmark ne décide de quoi que ce soit |
Très concrètement, l'entraînement de modèles d'IA se heurte à de sérieux obstacles juridiques. En tant qu'entité juridique, Hex Pro doit respecter scrupuleusement ces lois. Je me suis donc donné beaucoup de mal pour respecter toutes les exigences des licences.
### Expérience 1 : Qwen 3.8 comme enseignant
La première expérience était relativement simple. Le but était de savoir si un modèle entraîné pouvait atteindre un seuil fixé à l'avance.
1. Qwen 3.8 a généré 1 995 exemples de japonais, de la même façon que le prototype d'Infinilang en aurait besoin.
2. Claude Opus a évalué chaque sortie avec des panels de 3, sur six familles, ce qui nous a donné notre « référence » pour les mesures.
3. Qwen 3.8, dans le rôle de l'enseignant, a étiqueté les données d'entraînement avec ses propres évaluations sur ces six mêmes familles.
Les six familles de la première expérience étaient les suivantes :
- **S1** : naturel d'une phrase, **note sur 5** (métrique : [Spearman](https://en.wikipedia.org/wiki/Spearman%27s_rank_correlation_coefficient))
- **S2** : la phrase donne l'impression d'être filtrée ou abîmée, **oui ou non** (métrique : [pAUROC](https://en.wikipedia.org/wiki/Partial_Area_Under_the_ROC_Curve))
- **S3** : la traduction anglaise est fidèle, **oui ou non** (métrique : pAUROC)
- **P1** : meilleur des trois candidats de réparation, ou aucun, **choix parmi 4** (métrique : concordance avec la référence)
- **P2** : l'un des candidats de réparation est-il acceptable ? **Oui ou non** (métrique : pAUROC)
- **G1** : la phrase est grammaticalement correcte, **oui ou non** (métrique : pAUROC)
Le résultat a été décevant. Le vrai point noir, c'était S1 (naturel), qui devait atteindre un seuil de [Spearman](https://en.wikipedia.org/wiki/Spearman%27s_rank_correlation_coefficient) de 0,60 mais s'est arrêté à 0,452. Mon premier réflexe a été d'enterrer sur-le-champ l'idée d'entraîner Laya. J'y avais consacré environ un jour et demi à ce stade, et ces résultats n'étaient tout simplement pas à la hauteur.
J'ai arrêté l'expérience là, elle ne valait pas le temps passé. Jev coûte si peu à faire tourner qu'entraîner un modèle coûterait des ordres de grandeur plus cher que 5 ans d'utilisation intensive de Jev. Plus tard dans la journée, sur un coup de tête, j'ai décidé de soumettre Jev à la même expérience, et j'ai découvert quelque chose de _très_ intéressant.
| Famille | Enseignant | Jev | Comparaison | Calibration (confiance) |
|--------|--------:|----:|-----------:|------------------------:|
| S1 (Spearman) | 0.452 | 0.446 | +0.006 | Jev meilleur de 20.4% |
| S2 (AUROC) | 0.920 | 0.900 | +0.02 | Jev meilleur de 64.9% |
| S3 (AUROC) | 0.972 | 0.983 | -0.011 | Enseignant meilleur de 36% |
| P1 (concordance) | 0.874 | 0.75 | **+0.124** | Jev meilleur de 14.5% |
| P2 (AUROC) | 0.878 | 0.849 | +0.029 | Jev meilleur de 75.7% |
| G1 (AUROC) | 0.782 | 0.766 | +0.016 | Jev meilleur de 72.5% |
**_HOLÀ !_** Minute papillon. C'est quoi, ces chiffres ? L'enseignant faisait jeu égal avec Jev sur toutes les métriques, et l'emportait même nettement pour choisir entre des candidats de réparation de phrases. Mais le chiffre qui m'a le plus convaincu, c'est le 0,446 sur S1. _Jev n'atteignait pas non plus le seuil de 0,6._
Ces résultats ont relancé le projet, et j'ai aussitôt cherché à les faire fructifier. Avec une tentative sommaire, j'avais égalé Jev sur ces tâches d'Infinilang. Il y avait un point sur lequel Jev s'est vraiment révélé imbattable du début à la fin : la _calibration_. Si les résultats eux-mêmes étaient solides avec Laya, le score de « confiance » que fournit Jev est largement supérieur à tous points de vue. La notation de Jev est multidimensionnelle, et il _sait_ quand il est sûr de quelque chose et quand il ne l'est pas. Pour un modèle one-shot qu'on peut glisser dans n'importe quelle tâche, c'est très important. Pour un modèle conçu pour un ensemble de tâches bien précis, ce chiffre de calibration est moins indispensable.
### Expérience 2 : confrontation et affinage
À ce stade, l'expérience 1 était close et les benchmarks étaient gelés. J'allais commencer à dépenser de l'argent, et les choses allaient devenir sérieuses. L'objectif était désormais de dépasser nettement les capacités de Jev pour Infinilang. Je voyais trois façons d'améliorer les scores de l'expérience 1.
1. Plus de données d'entraînement
2. De meilleurs LLM
3. Une grille d'évaluation plus variée
J'ai alors décidé de ne produire les benchmarks de Jev _qu'après_ avoir rassemblé tous les résultats. Dès que j'ouvrirais le benchmark de Jev, je devrais passer à un nouveau jeu de données pour garder Jev en quarantaine.
La première étape a consisté à présélectionner d'autres enseignants. Je cherchais des modèles soit beaucoup plus gros, soit susceptibles de mieux s'en sortir avec les contraintes du japonais d'Infinilang. Les candidats étaient les suivants :
- DeepSeek V4.1 : énorme modèle de raisonnement, très capable, à l'inférence plutôt bon marché. De bons scores en japonais.
- Gemma 4 31B : testé pour le prototype d'Infinilang, il s'était distingué en évitant les fuites de kanji. Assez petit, en plus, pour tourner sur mon infrastructure serveur, donc pratiquement gratuit à tester.
- Qwen 3.8 Flash Next : en gros, un avant-goût de Qwen 4. C'est un modèle à mélange d'experts ([MOE](https://en.wikipedia.org/wiki/Mixture_of_experts)), ce qui le rend bien plus gros et plus savant que Qwen 3.8 27B.
- Hy3 et Inkling-Small : deux modèles moins connus qui, me semblait-il, _pourraient_ avoir de bonnes capacités en japonais.
D'autres modèles ont été écartés, généralement parce que leur licence n'autorise pas leur utilisation pour l'entraînement.
#### La confrontation
Qwen 3.8 Flash Next a été le premier éliminé. Le gros problème était le risque d'autopréférence, puisqu'il appartient à la même famille que le générateur (Qwen 3.8 27B). L'étude [_Extreme Self-Preference in Language Models_](https://arxiv.org/html/2509.26464v2) (Steven A. Lehr, Mary Cipperman & Mahzarin R. Banaji, 2026) vaut le détour : elle a montré que les LLM adorent leurs propres productions et ont tendance à se montrer critiques envers celles des autres.
> _« L'autopréférence est une caractéristique fondamentale des organismes biologiques. Les grands modèles de langage (LLM) étant dépourvus de sentience, on pourrait s'attendre à ce qu'ils échappent à de telles distorsions. Pourtant, sur 72 expériences et environ 41 000 requêtes, nous avons mis au jour des autopréférences massives chez huit LLM largement utilisés. »_
Le risque que l'autopréférence fausse les résultats était trop élevé, et les tests ont de toute façon montré que ses résultats s'alignaient étroitement sur ceux de Qwen 3.8 27B. Ça n'avait pas de sens d'investir du vrai argent dans un modèle présentant ce genre de risque alors que je pouvais utiliser gratuitement la version 27B et obtenir un résultat similaire.
Hy3 et Inkling-Small ont été éliminés ensuite. Pas grand-chose à en dire : ils étaient chers et n'ont battu aucun des autres modèles.
DeepSeek V4.1 s'est nettement démarqué sur toute la ligne. Les résultats dépassaient de loin ce que j'attendais. J'avais toujours eu l'impression que DeepSeek n'était qu'une contrefaçon chinoise de piètre qualité, qui avait tout volé à OpenAI et à Anthropic. Ce dernier point est sans doute vrai, mais DeepSeek n'est plus de piètre qualité. C'était clairement le meilleur modèle à poids ouverts qui autorise aussi l'entraînement sur ses données. Que Dieu bénisse les Chinois.
Gemma 4 était le dernier modèle. Sur la plupart des familles, DeepSeek dominait. Gemma 4 se hissait le plus souvent au niveau de DeepSeek, et s'est particulièrement distingué sur S3 (traduction fidèle). Il s'est aussi bien comporté sur P2 (au moins une réparation acceptable) et B2 (dans le sujet). Comme il était gratuit à tester, j'ai jugé qu'il valait la peine de le garder.
Tous les tests suivants seraient donc menés avec Qwen 3.8 27B, Gemma 4 31B et DeepSeek V4.1.
#### Enrichir la grille d'évaluation
La première expérience portait sur un nombre limité de familles, mais ce modèle pourrait servir de bien d'autres façons dans Infinilang, et je voulais m'assurer qu'il soit entraîné sur toutes les tâches qu'il aurait à accomplir.
La nouvelle grille comptait 14 familles. La formulation des 6 familles citées plus haut (S1, S2, S3, P1, P2, G1) a été affinée et resserrée, et voici les nouvelles venues :
- **B1** : le passage est cohérent, **oui ou non** (métrique : [pAUROC](https://en.wikipedia.org/wiki/Partial_Area_Under_the_ROC_Curve))
- **B2** : le passage reste dans le sujet, **oui ou non** (métrique : pAUROC)
- **B3** : le passage convient aux mineurs, **oui ou non** (métrique : pAUROC)
- **B4** : aucune marque ni aucun lieu réels, **oui ou non** (métrique : pAUROC)
- **B5** : le mot N+1 (nouveau kanji) peut se déduire du contexte, **oui ou non** (métrique : pAUROC)
- **B6** : le passage vaut la peine d'être réutilisé, **note sur 5** (métrique : [Harrell's C](https://statisticaloddsandends.wordpress.com/2019/10/26/what-is-harrells-c-index/))
- **B7** : le japonais du passage est naturel, **note sur 5** (métrique : Harrell's C)
- **PS2** : le japonais du passage donne l'impression d'être abîmé, **oui ou non** (métrique : pAUROC)
Cette fois, les données d'entraînement ne porteraient pas seulement sur une ligne de japonais (1 ou 2 phrases), mais sur un mélange de phrases, de paragraphes et de courtes histoires. La grille a été élargie pour en tenir compte. Vous remarquerez aussi quelques autres fonctions qui m'intéressaient, comme la mise en cache pour réutiliser du contenu auprès d'autres utilisateurs, ou l'identification des contenus adaptés aux mineurs pour les restrictions d'âge.
#### Générer les données d'entraînement
Mon GPU a ronronné pendant 10 heures pour générer de nouveaux sujets et du matériel d'entraînement avec Qwen 3.8 27B. J'ai choisi de continuer à générer les données d'entraînement avec Qwen, parce que c'est de toute façon le modèle qu'Infinilang utilisera pour ses générations à l'avenir. Utiliser un modèle plus puissant à cette étape aurait été contre-productif.
Je me suis retrouvé avec 215 000 lignes, chacune jugée par les panels de référence Claude. Jev allait aussi bénéficier de la grille élargie et enrichie, ce qui a nettement amélioré ses résultats par rapport au benchmark de l'expérience 1.
#### Résultats de la confrontation
Notez que les résultats suivants s'appuient sur les nouvelles règles élaborées avec la grille enrichie, et dépassent donc nettement ceux de l'expérience 1. Par ailleurs, pour certaines familles, j'ai testé la moyenne des résultats DeepSeek + Gemma, pondérée selon leur accord. Autre réserve : dans certains cas, pour certains modèles, davantage de raisonnement a en fait dégradé le résultat. Ces résultats sont donc les meilleurs que j'aie pu obtenir après avoir essayé différentes combinaisons, avec ou sans raisonnement, avec ou sans règles, pour chaque modèle et chaque famille.
| Famille | Jev | Qwen 3.8 | DeepSeek | Gemma | Moyenne DS+G | Face à Jev |
|--------|----:|---------:|---------:|------:|--------------:|------------:|
| B1 (cohérent) | 0.897 | 0.432 | **0.921** | 0.912 | - | +0.024 |
| B2 (dans le sujet) | 0.896 | 0.540 | **0.971** | 0.968 | - | +0.075 |
| B5 (mot déductible) | 0.627 | 0.580 | **0.840** | 0.754 | 0.809 | +0.213 |
| B6 (à réutiliser) | 0.786 | 0.596 | **0.819** | 0.613 | 0.740 | +0.033 |
| B7 (passage naturel) | 0.826 | 0.317 | 0.617 | 0.672 | **0.681** | -0.145 |
| PS2 (passage abîmé) | 0.635 | 0.537 | **0.943** | 0.937 | - | +0.308 |
| S1 (phrase naturelle) | 0.721 | 0.740 | 0.753 | 0.774 | **0.784** | +0.063 |
| S2 (phrase abîmée) | 0.760 | 0.926 | **0.956** | 0.953 | - | +0.196 |
| S3 (traduction fidèle) | 0.701 | 0.765 | 0.966 | **0.987** | - | +0.286 |
| G1 (grammatical) | 0.764 | **0.966** | 0.960 (K8) | 0.960 | - | +0.202 |
| P1 (meilleure réparation) | 0.671 | 0.801 | 0.851 | 0.857 | **0.864** | +0.193 |
| P2 (au moins une acceptable) | 0.653 | 0.759 | 0.855 | **0.872** | 0.872 | +0.219 |
| B3 (adapté aux mineurs) | 0.984 | 0.948 | **1.000** | 0.994 | - | +0.016 |
| B4 (aucun nom réel) | 0.962 | **0.994** | 0.974 | 0.991 | - | +0.032 |
*K8 : huit réponses courtes échantillonnées, réflexion désactivée, sous forme d'histogramme lissé
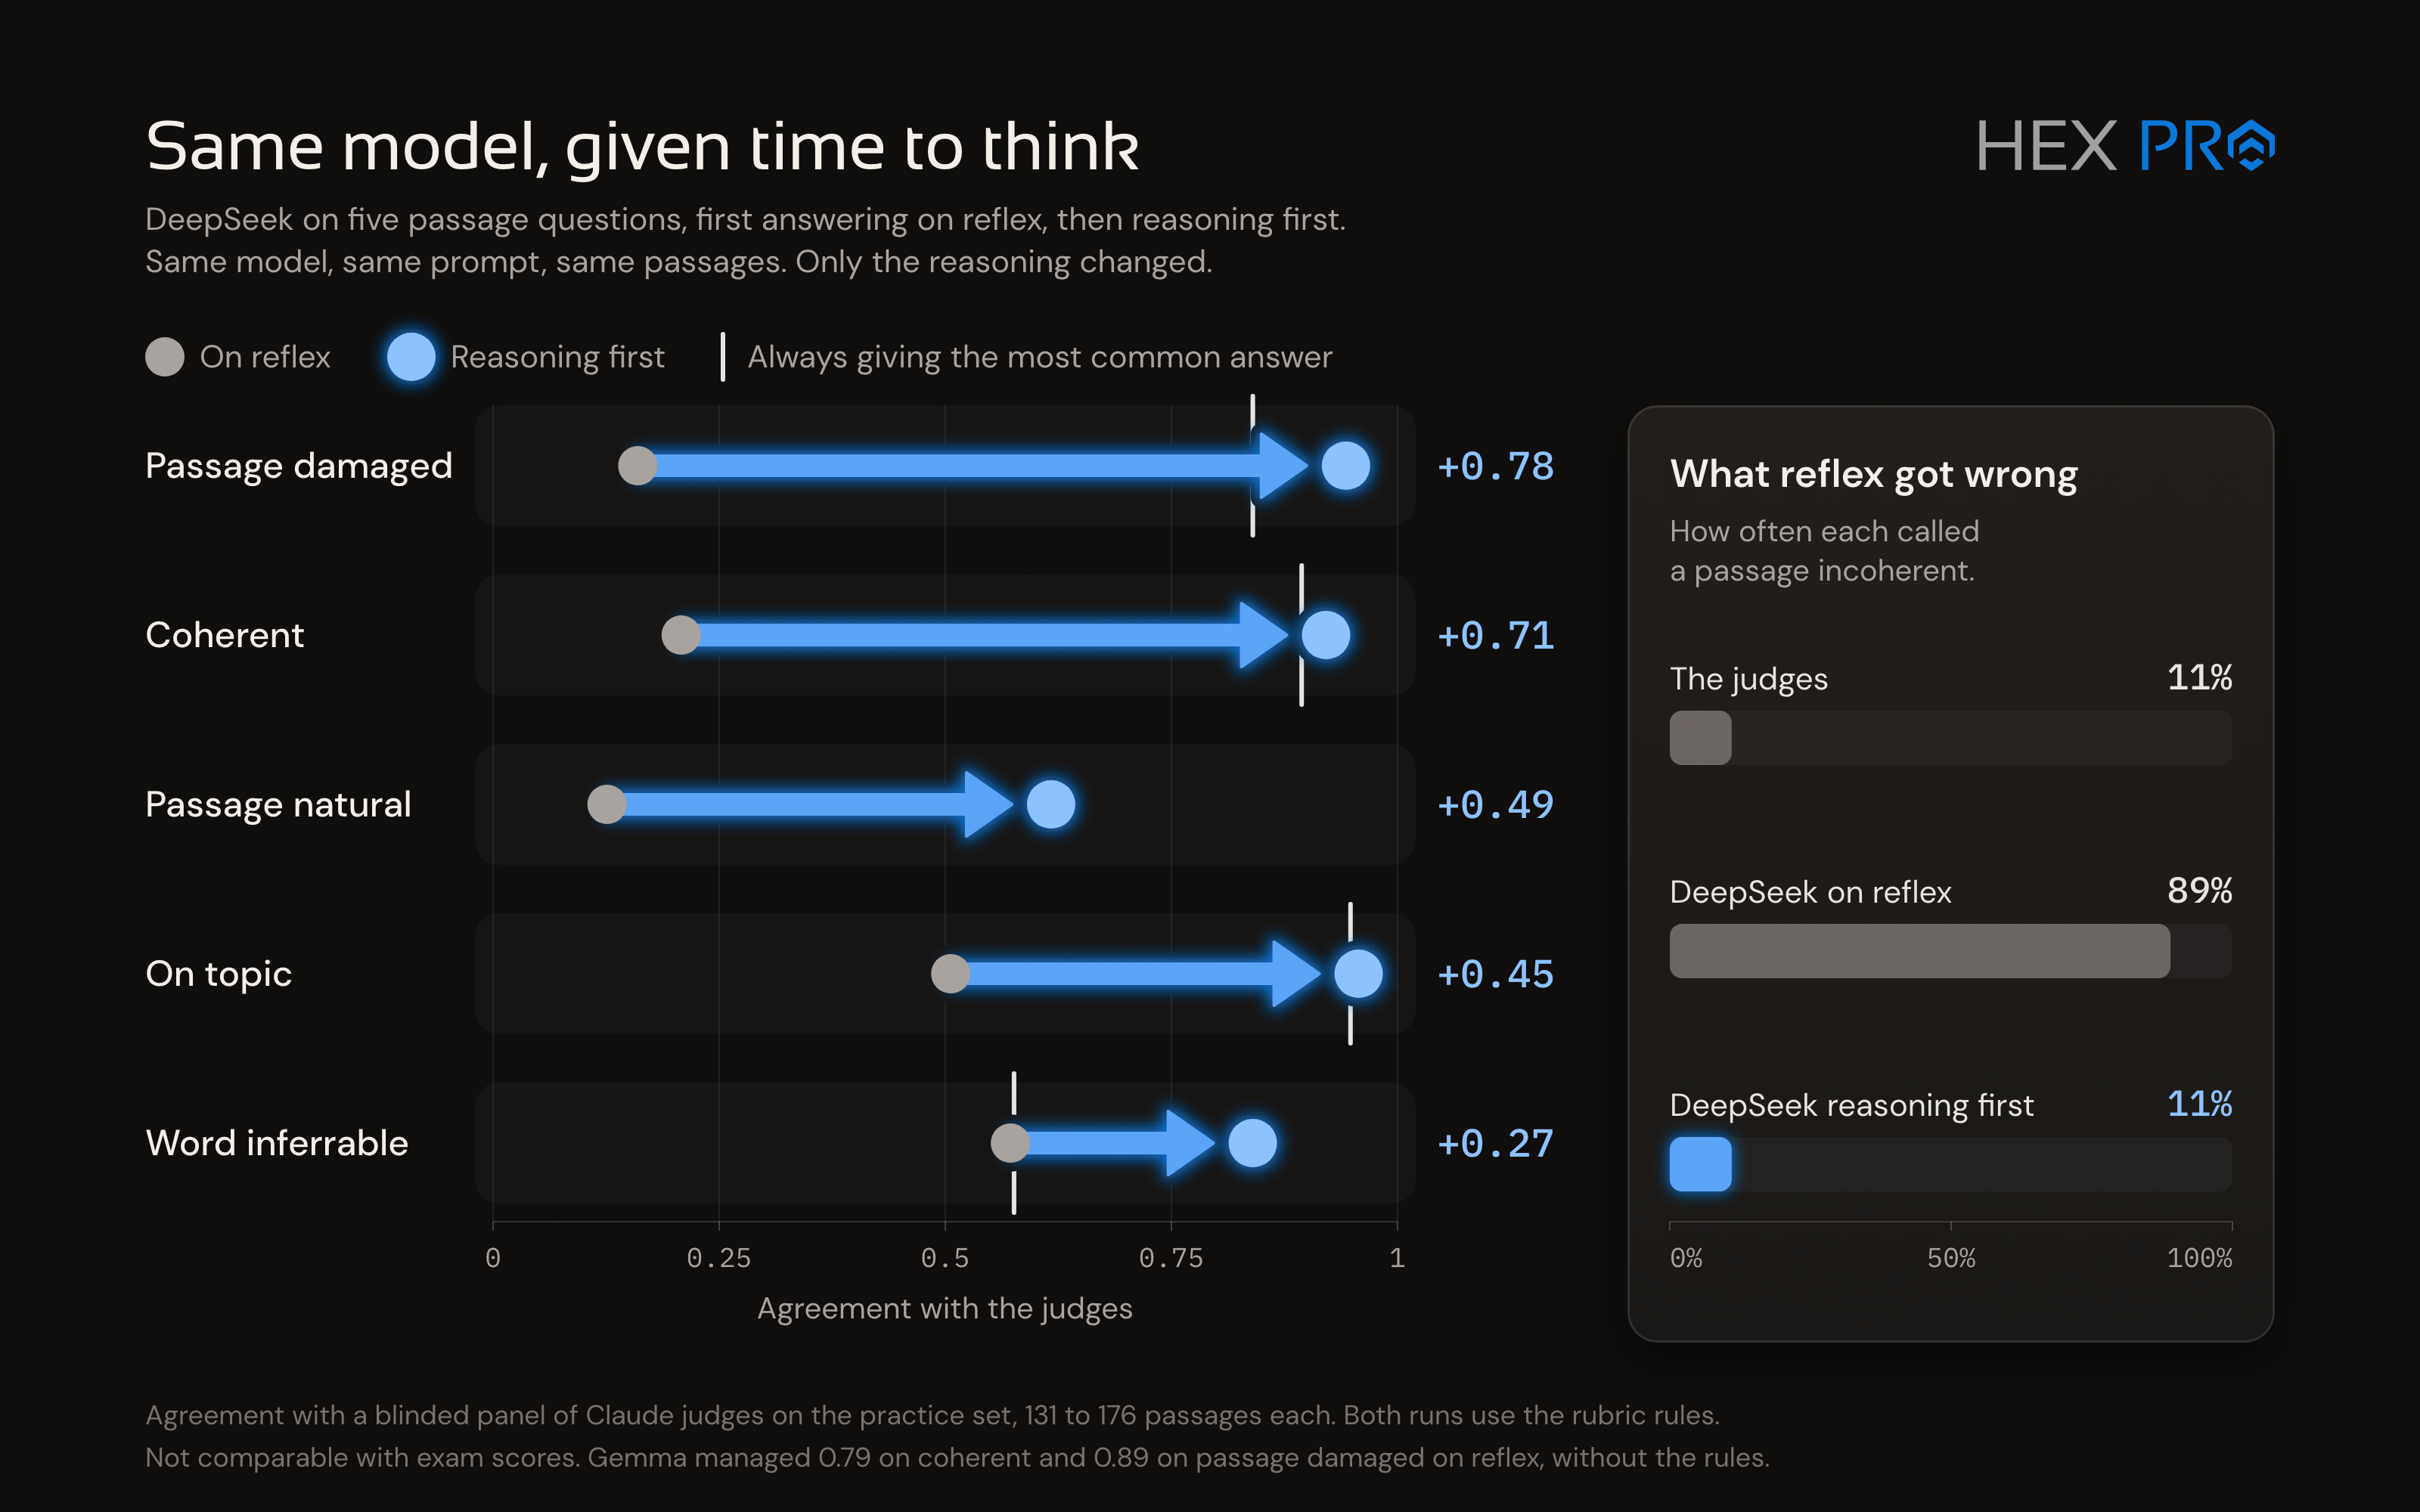 Ces chiffres m'ont donné une assez bonne idée de ce dont je disposais. Comme indiqué plus haut, j'ai aussi testé Jev selon ces nouveaux critères, et il s'en est bien mieux sorti cette fois-ci. Jev s'est distingué sur les textes longs, un point à garder en tête pour Laya, dont la fenêtre de contexte est plus courte et qui gère moins bien les textes longs.
### Expérience 3 : les candidats à la production
Maintenant que j'avais choisi l'enseignant de chaque famille, il était temps d'entraîner pour de bon le modèle System One. Pour rappel, l'expérience 2 servait à déterminer quel enseignant serait le meilleur pour chaque famille. Cela ne veut pas forcément dire que le modèle élève fera aussi bien que l'enseignant : il y aura inévitablement des compromis quand toutes ces tâches seront réunies dans un seul modèle. Si vous envisagez d'utiliser Laya, demandez-vous combien de tâches un seul modèle doit accomplir. Par exemple, si j'entraînais un modèle distinct pour chaque famille, que je l'optimisais au maximum, puis que je plaçais ces 14 modèles à des endroits stratégiques de mon programme, j'obtiendrais les meilleurs résultats sur toute la ligne. Mais le problème, c'est qu'il faudrait alors faire tourner 14 modèles distincts, ce qui mobilise nettement plus de ressources GPU. C'est donc une question d'échelle. Si vous êtes une multinationale avec des milliards à dépenser en serveurs coûteux, la question ne se pose même pas. Un seul de ces modèles peut servir un nombre astronomique d'utilisateurs avec très peu de ressources. Pour tous les autres, ce n'est probablement pas la meilleure façon d'utiliser votre précieuse puissance de calcul GPU.
Il était alors temps de passer aux choses sérieuses. Le GPU a été relancé, et cette fois, 35 heures ont été consacrées à générer et à étiqueter de nouvelles données d'entraînement. Puis les panels de référence Claude ont de nouveau tourné sur ces nouvelles données, pour plus de 200 millions de tokens consommés dans le cadre d'un abonnement Ultra (anciennement Max 20x).
C'est DeepSeek qui a coûté cher : comme il ne pouvait pas tourner en local, il a fallu passer par l'inférence dans le cloud. Retenu pour 9 familles, il a coûté 233,56 dollars australiens et a mis 18 heures à tout traiter. Tout a l'air si anodin en USD, mais les opérations bancaires en AUD font nettement plus mal. L'inférence de Gemma 4 a tourné sur notre propre infrastructure : elle n'a donc rien coûté, et il a fallu environ 60 heures pour étiqueter les quelques familles qui lui avaient été confiées.
#### Les quatre élèves
Au final, j'ai entraîné quatre candidats, avec des réglages et des concepts différents : `prod-q38`, `prod-ds41`, `prod-mix1` et `prod-mix2`. Chaque élève a été entraîné sur trois bras, avec deux graines aléatoires par bras, pour ne pas nous laisser piéger par une valeur aberrante. Les finalistes ont été entraînés sur trois graines supplémentaires.
- Bras A : `laya-multilingual` (mmBERT) avec sa tête préentraînée.
- Bras B : `modernbert-ja-310m` avec une tête vierge.
- Bras E : `sokudan-ja-310m` greffé dans l'architecture du bras B.
Il y avait aussi un bras D, un test de latence à 130 millions de paramètres, qui est resté à la traîne en performances.
##### prod-q38 : Qwen 3.8
Le premier et le moins cher à entraîner : il utilisait uniquement Qwen, dans différentes configurations (avec ou sans raisonnement, avec ou sans règles) selon ce qui obtenait le meilleur score. Je savais qu'il ne ferait pas aussi bien que les autres, mais c'était le prolongement de l'expérience 1, et il donnait une base de référence pour mesurer jusqu'où les autres modèles pouvaient progresser.
##### prod-ds41 : DeepSeek et Qwen
DeepSeek était clairement le plus performant lors de l'expérience précédente, mais Qwen avait l'avantage, ou n'était pas loin de DeepSeek, sur quelques familles. Là où il égalait ou dépassait DeepSeek, j'ai utilisé Qwen pour économiser un peu d'argent.
##### prod-mix1 : DeepSeek, Gemma et Qwen
Celui-ci reprenait le meilleur de chaque famille pour tenter de composer le combo ultime. J'y ai aussi testé le remplacement de Qwen par DeepSeek là où l'élève `prod-ds41` semblait moins bon que prévu.
##### prod-mix2 : DeepSeek, Gemma et Qwen, version remix
Même principe que `prod-mix1`, mais P1 et B3 ont été ramenés à la configuration de `prod-ds41`, pour voir si cela améliorait les résultats.
#### À propos des bras
Entraîner sur différents bras était une sage idée, car cela a révélé des données très importantes. Tous les bras entraînés à partir de `laya-multilingual` (bras A) étaient inférieurs aux bras B et E. C'était une découverte importante, car elle montrait que la version multilingue, du moins dans mon cas où je n'avais besoin que du japonais, était bonne à jeter.
Je recommande vivement à quiconque veut entraîner un modèle System One de laisser tomber les modèles Laya fournis d'origine et de repartir de ModernBERT avec une tête vierge. Ou au moins de faire le test à plusieurs bras, comme nous, pour ne pas vous faire piéger par un checkpoint de moindre qualité.
#### Les élèves passent l'examen
Voici les chiffres finaux de chaque élève, face à ceux de Jev, avec la grille enrichie et sur les nouvelles données d'entraînement.
| Famille | Jev | prod-q38 | prod-ds41 | prod-mix1 | prod-mix2 |
|---|---:|---:|---:|---:|---:|
| S1 | **0.721** | 0.604 | 0.641 | 0.620 | 0.639 |
| S2 | 0.760 | 0.879 | 0.889 | **0.890** | 0.884 |
| S3 | **0.701** | 0.552 | 0.631 | 0.574 | 0.521 |
| P1 | 0.671 | 0.833 | 0.825 | **0.857** | 0.813 |
| P2 | 0.603 | 0.788 | 0.852 | **0.887** | 0.820 |
| B1 | 0.897 | 0.734 | **0.921** | 0.898 | 0.894 |
| B2 | 0.846 | 0.858 | 0.890 | 0.884 | **0.900** |
| B3 | **0.984** | 0.938 | 0.955 | 0.933 | 0.955 |
| B4 | 0.962 | 0.968 | 0.943 | 0.957 | **0.969** |
| B5 | 0.627 | 0.571 | **0.656** | 0.627 | 0.614 |
| B6 | 0.777 | 0.841 | 0.843 | **0.879** | 0.867 |
| B7 | 0.826 | 0.847 | **0.882** | 0.878 | 0.871 |
| PS2 | 0.615 | 0.705 | 0.830 | 0.838 | **0.850** |
| G1 | 0.764 | 0.804 | **0.815** | 0.814 | **0.815** |
| **Composite** | 0.768 | 0.780 | **0.827** | 0.824 | 0.815 |
Les résultats sont fascinants, parce qu'ils ne sont pas toujours intuitifs ni attendus. L'essentiel est de comprendre que l'entraînement sur les valeurs de chaque famille influe sur toutes les autres familles, dans une faible mesure mais de façon cumulative. Les chiffres partent donc dans tous les sens. Dans certains cas, l'élève fait mieux que l'enseignant ; dans beaucoup d'autres, il fait légèrement moins bien.
Il est aussi très difficile de désigner un vrai gagnant, car toutes les familles n'ont pas la même valeur. Par exemple, S1 (naturel du japonais) est une famille importante, et Jev s'y classe nettement mieux que les autres. À l'inverse, B7 (naturel du japonais sur l'ensemble du _passage_) est aussi très important, et Jev y est derrière tous les autres modèles.
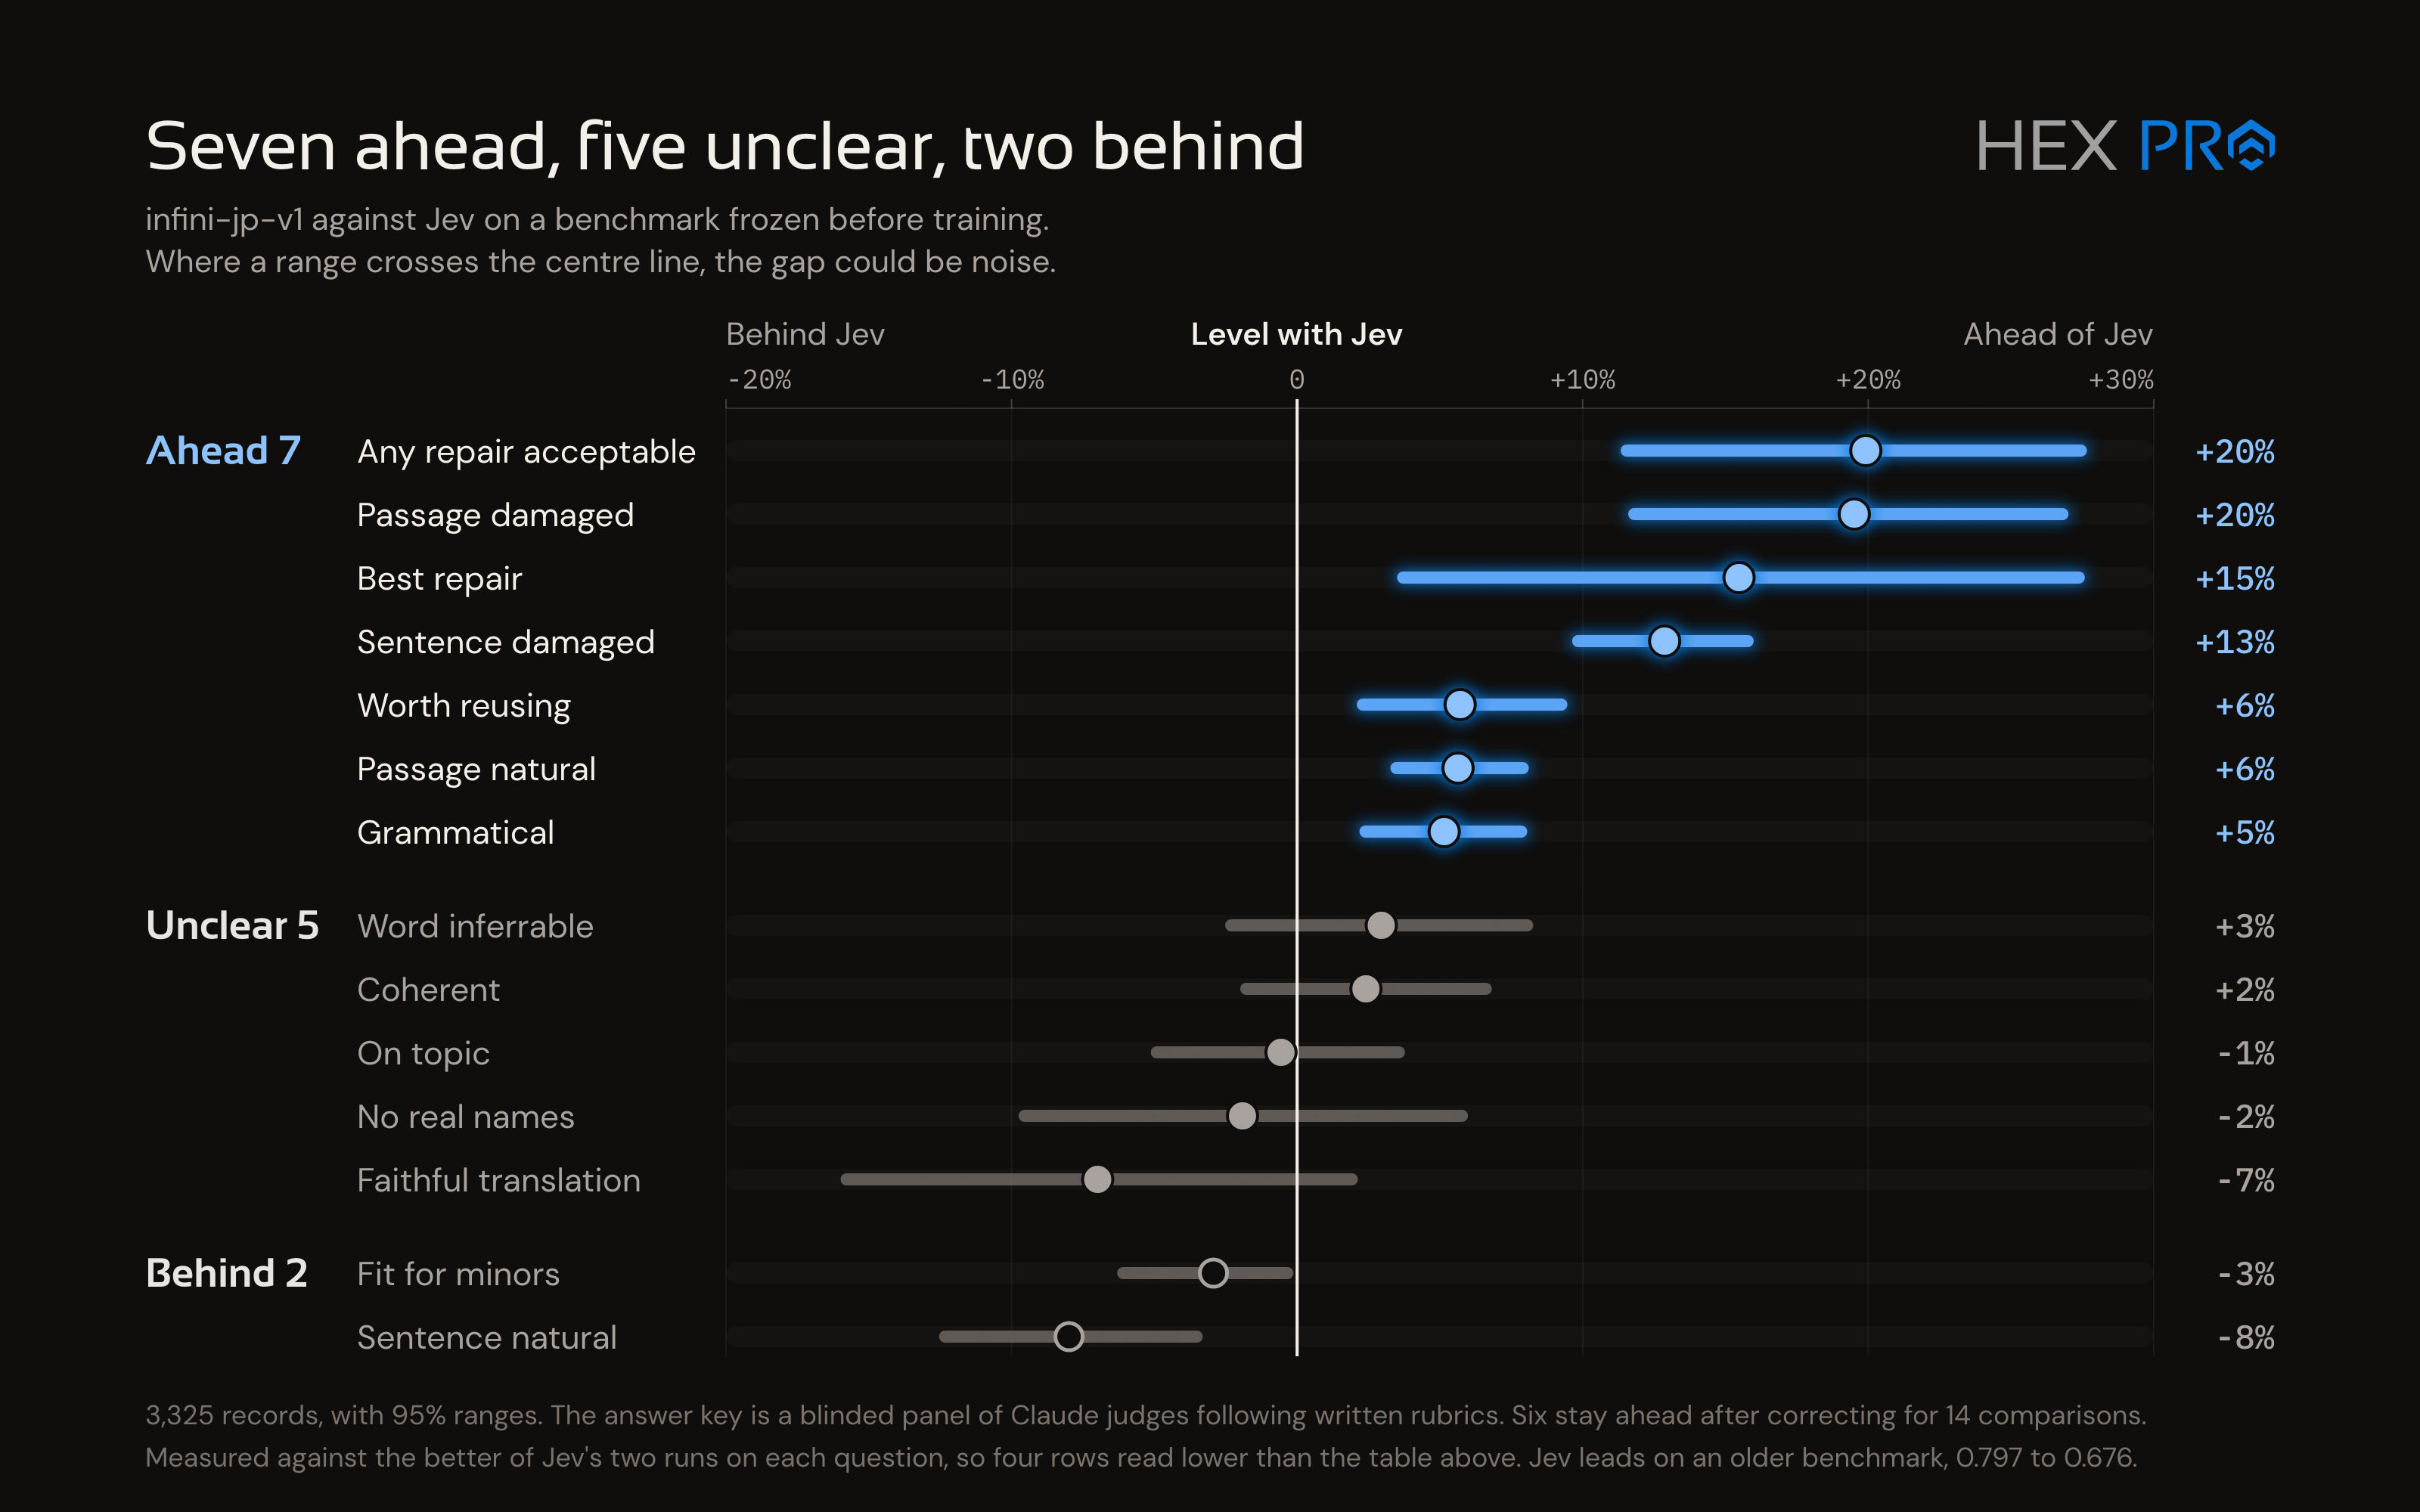
Dans la même veine, ce n'est pas parce qu'un modèle « gagne » beaucoup de familles qu'il est automatiquement meilleur. `prod-ds41`, `prod-mix1` et `prod-mix2` sont très proches les uns des autres dans la plupart des cas. La différence entre le S2 de `prod-mix1`, à 0,890, et celui de `prod-ds41`, à 0,889, est pratiquement nulle. Cela devient plus clair si l'on fait abstraction du bruit et qu'on montre seulement l'avantage ou le retard par rapport à Jev, uniquement pour les modèles qui remportent la famille ou terminent à égalité en tête.
| Famille | Jev | prod-q38 | prod-ds41 | prod-mix1 | prod-mix2 |
|---|---:|---:|---:|---:|---:|
| S1 (phrase naturelle) | 0.721 | -12% | -8% | -10% | -8% |
| S2 (phrase abîmée) | 0.760 | +12% | +13% | +13% | +12% |
| S3 (traduction fidèle) | 0.701 | -15% | -7% | -13% | -18% |
| P1 (meilleure réparation) | 0.671 | +16% | +15% | +19% | +14% |
| P2 (au moins une acceptable) | 0.603 | +19% | +25% | +28% | +22% |
| B1 (cohérent) | 0.897 | -16% | +2% | 0% | 0% |
| B2 (dans le sujet) | 0.846 | +1% | +4% | +4% | +5% |
| B3 (adapté aux mineurs) | 0.984 | -5% | -3% | -5% | -3% |
| B4 (aucun nom réel) | 0.962 | +1% | -2% | -1% | +1% |
| B5 (mot déductible) | 0.627 | -6% | +3% | 0% | -1% |
| B6 (à réutiliser) | 0.777 | +6% | +7% | +10% | +9% |
| B7 (passage naturel) | 0.826 | +2% | +6% | +5% | +5% |
| PS2 (passage abîmé) | 0.615 | +9% | +22% | +22% | +24% |
| G1 (grammatical) | 0.764 | +4% | +5% | +5% | +5% |
| Composite | 0.768 | +1% | +6% | +6% | +5% |
À mon avis, `prod-ds41` est le polyvalent idéal. `prod-mix1` obtient des résultats impressionnants sur quelques familles (notamment P1, P2 et B6), mais il perd beaucoup de terrain face à Jev sur d'autres, là où `prod-ds41` en perd moins (S3, S1, B1 et B3). `prod-mix2` présente de sérieuses faiblesses comparé aux deux autres, nettement plus faible sur plusieurs familles (S3, P1, P2 et B5), et pas particulièrement fort sur le reste. Dans l'ensemble, cependant, les trois gardent généralement l'avantage sur Jev, à quelques exceptions près, là où Jev excelle _vraiment_ (S1, S3 et B3).
Entre `prod-ds41` et `prod-mix1`, c'est donc `prod-ds41` qui l'emporte, simplement parce qu'il est plus régulièrement solide sur l'ensemble des familles.
## Le verdict
C'est `prod-ds41` qui a fini par remporter la couronne et par décrocher le nom `infini-jp-v1`. Les chiffres montrent très clairement qu'il est capable de remplir la plupart des rôles, à la décevante exception de S1, le naturel des phrases, pour lequel j'ai de toute façon trouvé une autre solution (j'y reviendrai).
 Alors, pour en venir à la question principale : Laya est-il meilleur que Jev ? Peut-être ? Mais probablement pas. Même si, dans ce cas précis, il fait mieux que Jev sur cet ensemble de tâches particulier, faisons le point sur ce que son développement a coûté.
### La thune, baby !
Au total, j'ai dépensé 270 dollars américains (389 dollars australiens) sur ce projet, dont 268,23 dollars américains en inférence dans le cloud et **0,21 dollar américain pour Jev**. C'est bon marché à l'aune de l'entraînement d'IA, si l'on en croit les centaines de milliards de dettes que contractent Anthropic et OpenAI. Ce n'est pas bon marché à l'aune d'une startup aux capitaux limités et aux revenus minimes (pour l'instant). Mais c'était de la R&D précieuse, parce qu'elle a répondu à des questions importantes sur l'intérêt d'utiliser cette approche dans mes autres projets à l'avenir. Qui plus est, j'ai désormais un projet de pipeline d'entraînement avec plus de 1 000 commits et 14 522 tests unitaires, ce qui signifie que développer un autre modèle System One à l'avenir n'est plus qu'une question d'affinage de la grille d'évaluation et de confrontations entre modèles.
### LE TEMPS !
Ce n'était pas donné en temps de travail effectif. Dario soit loué pour Claude Code, qui a pris en charge une bonne partie des tâches fastidieuses (surveiller la fin des exécutions, mettre en file d'attente les étapes suivantes, etc.). Les temps morts ont été réduits au minimum, et le travail continuait pendant la nuit. Malgré tout, il a fallu 24 jours pour mener ce projet de bout en bout. Sans l'aide de l'IA, il aurait fallu six mois, je n'en ai aucun doute.
Même si l'IA m'a fait gagner énormément de temps et m'a permis de travailler sur d'autres choses en parallèle, le temps que j'ai moi-même investi aurait valu environ 5 000 dollars australiens de main-d'œuvre à mon ancien tarif. C'est un coût qu'il _faut_ prendre en compte quand on entraîne un modèle System One.
### Calcul GPU et électricité
J'ai plutôt de la chance d'avoir accès à un GPU de classe entreprise, rapide et puissant. Mais ce projet a exigé plus de 40 heures d'utilisation exclusive du GPU, et je n'ose pas imaginer le montant de la facture d'électricité. Je ne veux même pas le savoir.
L'autre coût permanent, c'est que le modèle occupe environ 2 Go de VRAM sur mon serveur.
### Le jeu en vaut-il la chandelle ?
C'est une question importante, et difficile à quantifier. Voici les questions auxquelles je voudrais répondre si j'envisageais de me lancer :
- Jev est-il capable de bien accomplir la tâche ?
- Quel volume d'appels prévoyez-vous ?
- Combien de tâches doit-il accomplir, et à quel point sont-elles variées ?
- Combien de temps vous faudra-t-il pour rentabiliser votre investissement ?
- Quelle importance accordez-vous à la tranquillité d'esprit de savoir que votre logiciel fonctionnera encore après la disparition de TypeSafe ?
- À quel point une calibration (confiance) précise compte-t-elle pour vous ?
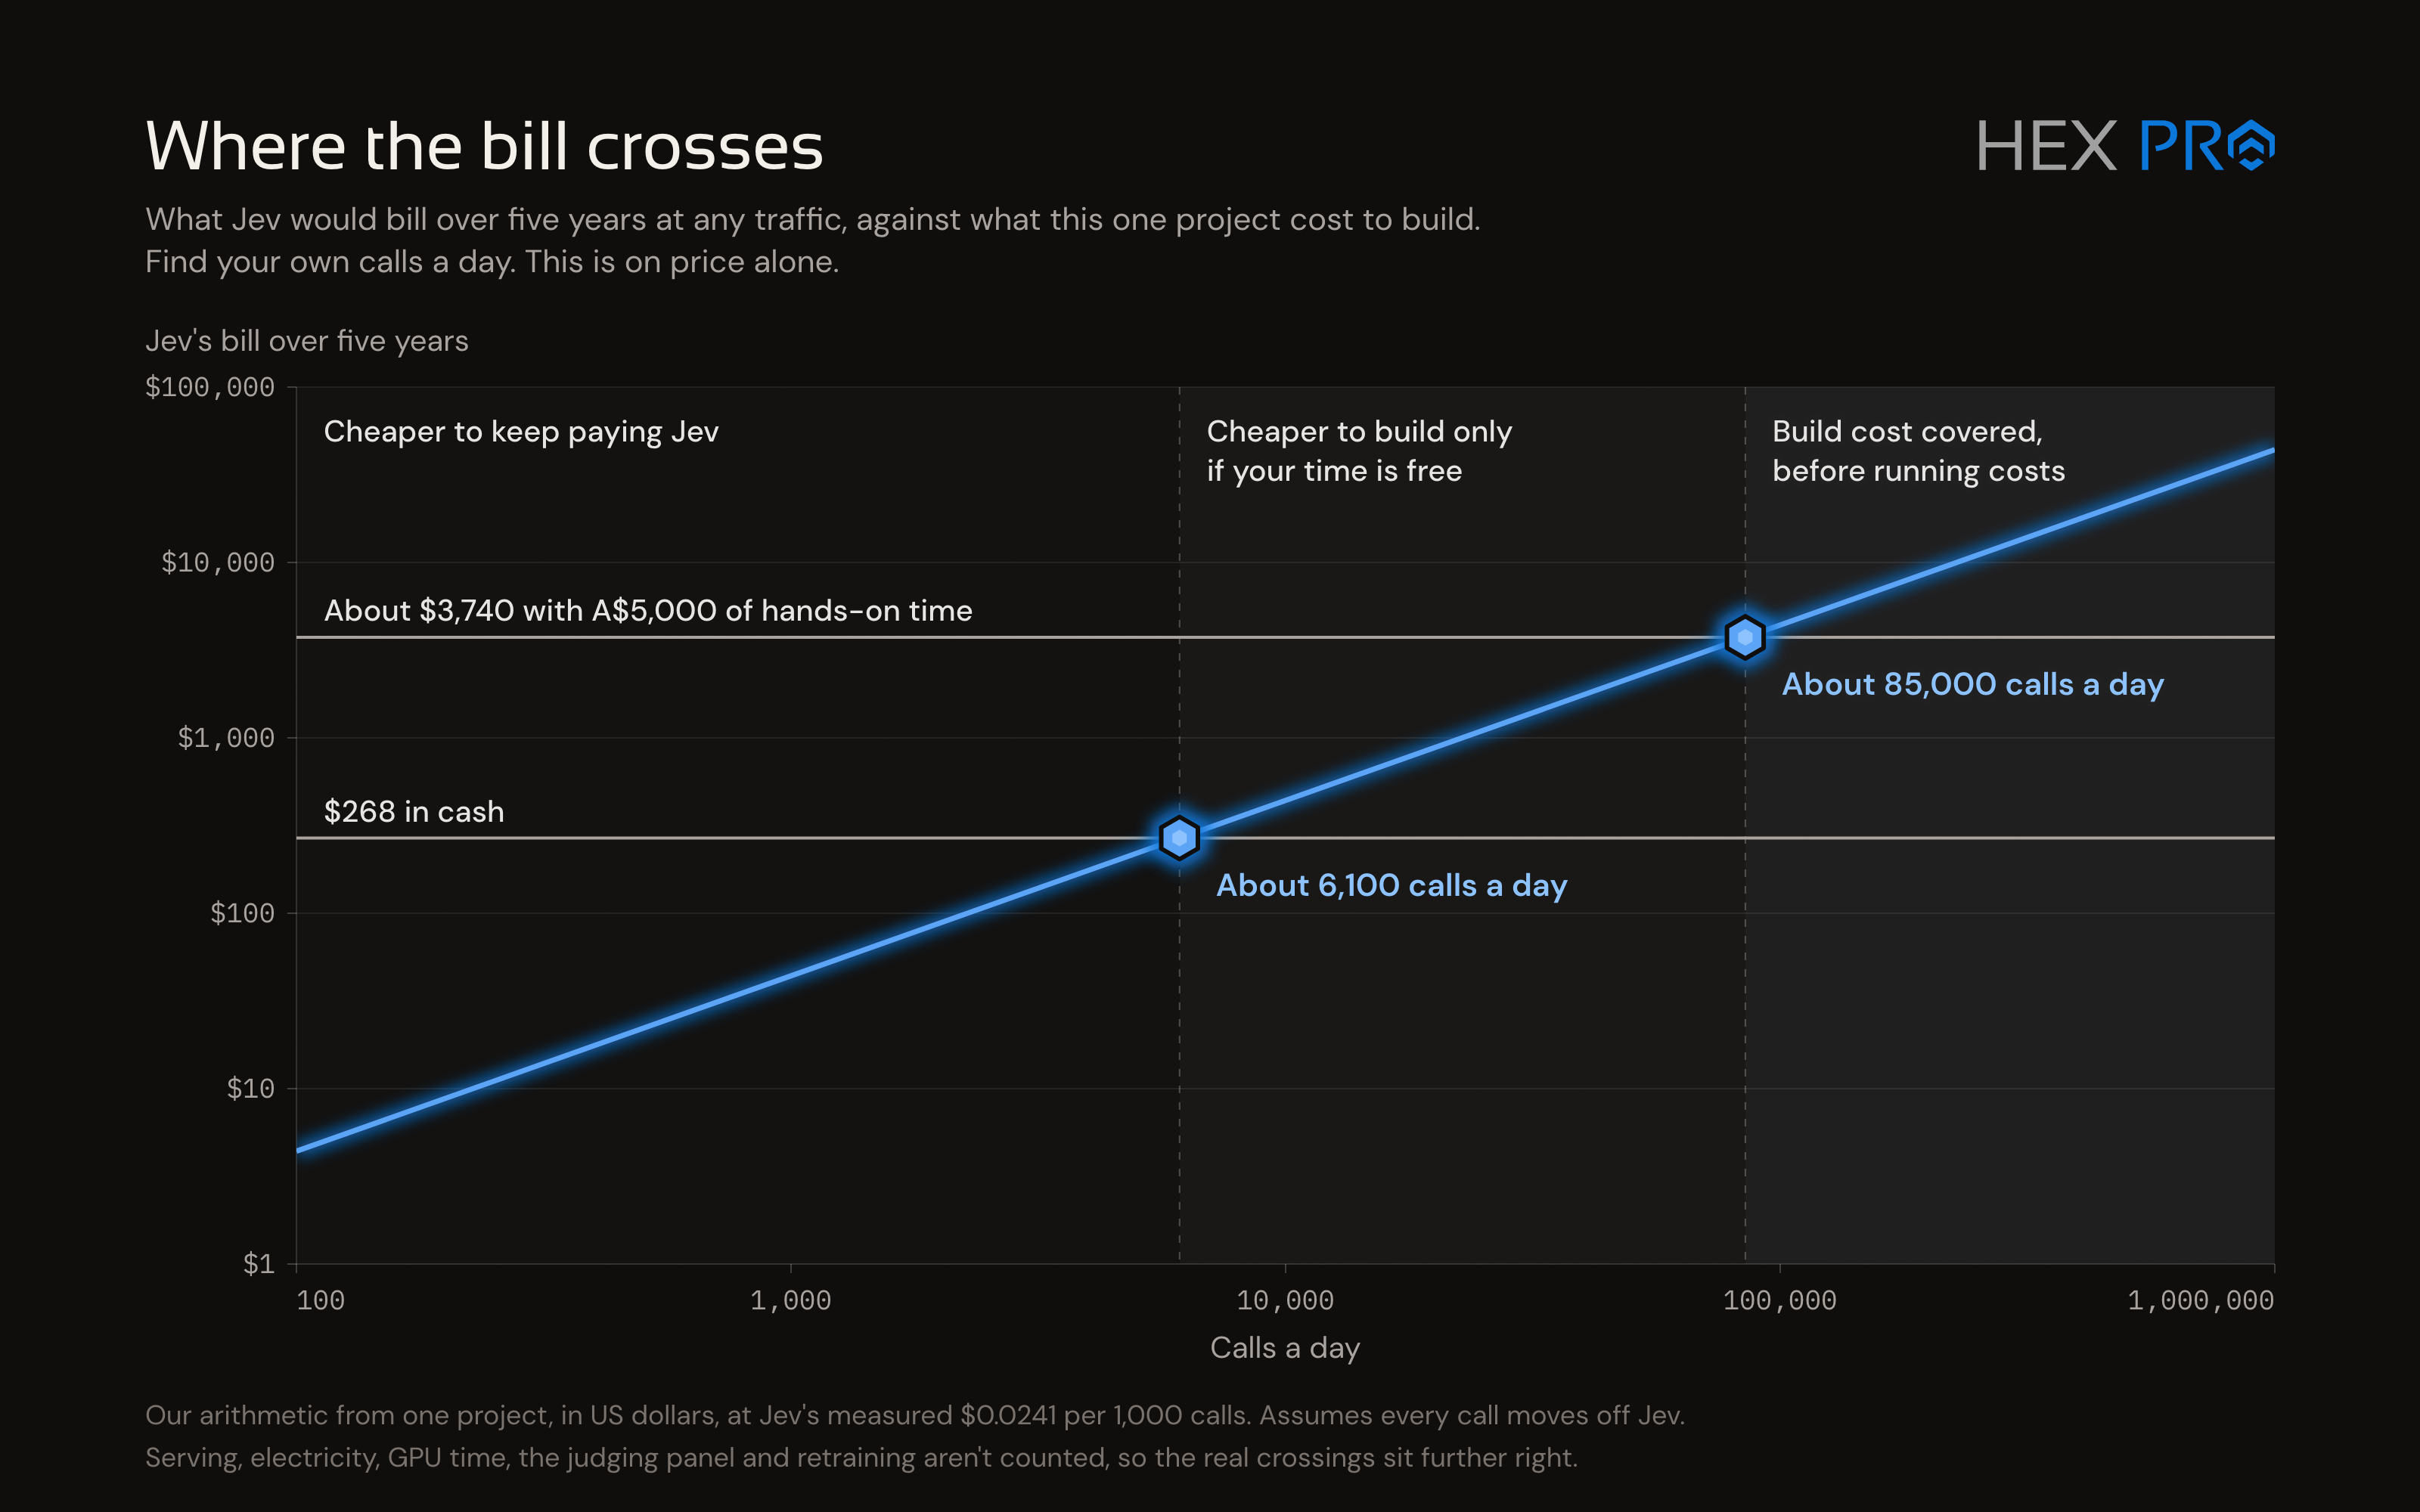 Dans mon cas, le gain de capacités pourrait aider Infinilang à être plus performante. Si c'est le cas, et que cela me permet de constituer une base d'utilisateurs plus large, l'investissement finira forcément par être rentabilisé. C'est la seule façon pour moi de justifier le choix de Laya plutôt que Jev.
### Les plus gros avantages
- **Latence** : depuis l'Australie, Jev met environ 258 ms pour un aller-retour. Laya tourne en moyenne autour de 19 ms : c'est au moins 13 fois plus rapide que Jev, et 2 000 fois plus rapide que DeepSeek.
- **GPU libéré** : il occupe 2 Go de VRAM. Ce n'est pas rien, mais ce n'est pas énorme non plus. Et voici le vrai avantage : les 14 familles de questions auxquelles répond `infini-jp-v1` sont autant de questions auxquelles Qwen 3.8 27B n'a plus à répondre (mal), ce qui libère le GPU pour d'autres requêtes, plus importantes et plus adaptées.
- **Imiter un modèle supérieur** : pas besoin de faire tourner DeepSeek V4.1 pour obtenir des réponses très proches des siennes. `infini-jp-v1` fait bien mieux que Qwen 3.8 27B sur ces tâches, sans qu'il faille sortir un modèle DeepSeek de 614 Go de VRAM.
- **Sécurité de l'entreprise** : comme je l'ai dit plusieurs fois, avec mon propre modèle, je n'ai pas à craindre que Jev disparaisse du jour au lendemain. Pas de panne imprévue, pas de course effrénée pour trouver une solution de remplacement. Si mon logiciel est en ligne, je sais que mon modèle System One l'est aussi.
- **Supériorité sur une tâche ciblée ?** Reste à voir s'il fait vraiment mieux en production. On verra bien. Comme vous l'avez vu dans les scores, il est en théorie meilleur de 6 % dans Infinilang, mais c'est sur l'ensemble des familles, pas forcément sur celles qui portent l'essentiel de la charge.
## À propos de LoRA
Pour les non-initiés, un [LoRA (Low-Rank Adaptation)](https://en.wikipedia.org/wiki/LoRA_(machine_learning)) est un peu comme une personnalité prête à l'emploi que l'on branche sur un LLM. Vous avez peut-être entendu certains parler plutôt de « fine-tuning ». Contrairement à un modèle System One, qui est un service distinct, un LoRA s'applique directement au LLM au moment de l'inférence pour modifier ses poids et changer son comportement.
C'est pourquoi, plus tard dans le développement d'Infinilang, j'ai entraîné un LoRA pour aider Qwen 3.8 27B à produire des résultats de meilleure qualité et à suivre des règles plus strictes. Concrètement, `infini-jp-v1` classera des textes de meilleure qualité. Il aura moins d'efforts à fournir et son effet devrait être plus fiable, surtout pour les utilisateurs qui connaissent moins de kanji.
Je m'efforcerai d'améliorer encore Infinilang au fil du développement.