---
title: "Modelos System One revolucionarán la IA: Laya y Jev"
description: "Hex Pro entrenó un modelo System One con Laya en 3 semanas. ¿Qué hizo falta, cuánto costó y puede igualar al Jev de TypeSafe, de 40 millones de USD?"
author: "Matthew Scott"
published: "2026-11-11T05:24:58.094Z"
updated: "2026-11-11T05:34:26.261Z"
language: "es"
canonical: "https://hex.pro/es/blog/system-one-models-will-revolutionise-ai-software-laya-jev"
markdown: "https://hex.pro/es/blog/system-one-models-will-revolutionise-ai-software-laya-jev.md"
publisher:
name: "Hex Pro"
url: "https://hex.pro"
---
El 15 de septiembre supuso un auténtico terremoto en el mundo de la IA y la tecnología, aunque pasó prácticamente desapercibido para el gran público. Como de costumbre, los ingenieros de software estuvieron en primera línea de un avance que al resto se le escapó por completo: TypeSafe AI lanzó el primer modelo **System One** comercial, _'Jev'_.
Tres semanas después, ya había entrenado mi propio modelo System One para uno de nuestros próximos productos. Este es el balance de esa experiencia.
## Modelos System One: ¿otro intento más de hacer dinero con la IA?
Cualquiera que siga la IA ahora mismo conoce la sensación. Alguien te manda un mensaje con el enlace a un nuevo producto de IA recién salido al mercado y pones los ojos en blanco. "¿Modelos System One?", preguntas. ¿A quién le importa? Tengo Claude Opus y un montón de trabajo por hacer. No tengo tiempo para otro _Manus_ ni para otro _Rabbit r1_.
Eso es exactamente lo que se me pasó por la cabeza la primera vez que oí hablar de Jev. Pero la gente me pedía mi opinión, así que decidí investigarlo. Para empezar, el sitio web de TypeSafe AI explica fatal el concepto. Nadie te culparía por leer su [artículo de lanzamiento en el blog](https://typesafe.ai/blog/introducing-system-one-models-and-jev) y pensar que pretendía competir con los modelos de IA de frontera de OpenAI y Anthropic (sobre todo por los gráficos, que dan a entender justo eso). Sueltan términos como "Reinforcement Learning for Calibrated Decisions" (RLCD, aprendizaje por refuerzo para decisiones calibradas), que para el consumidor no significan prácticamente nada.
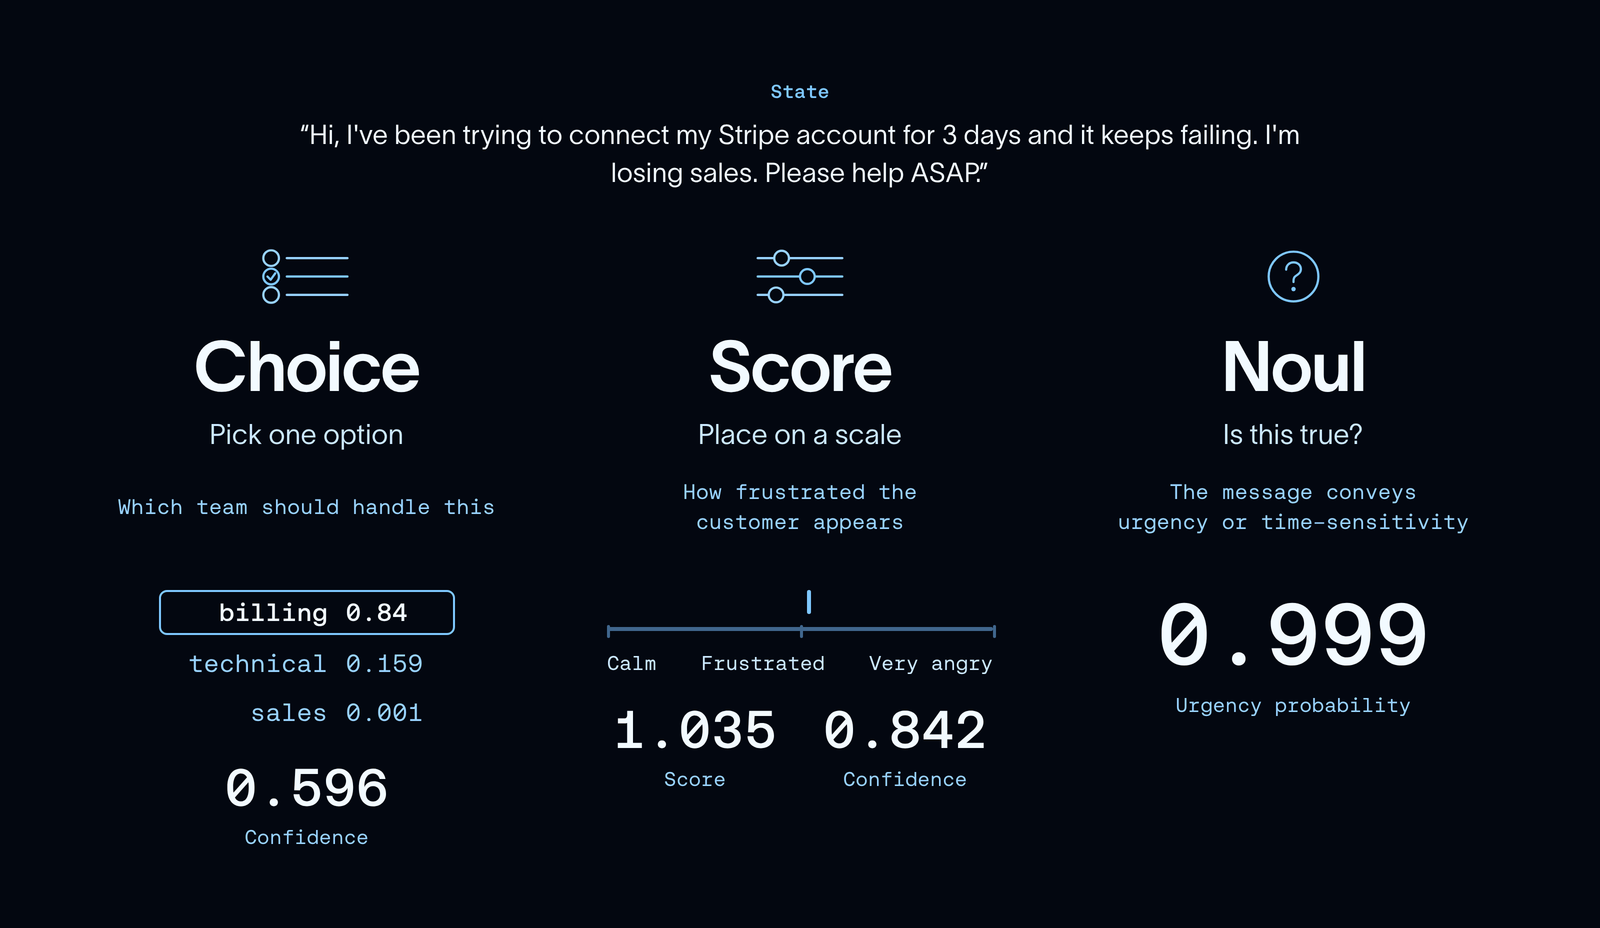
Hizo falta este [artículo de LangChain, muchísimo mejor](https://www.langchain.com/blog/building-a-harness-with-jev), para que se entendiera lo que Jev hace _de verdad_. Si quieres el análisis completo, **lee** ese artículo; vale muchísimo la pena. Debajo tienes una infografía del artículo que me dejó boquiabierto y que explicaba el caso de uso mejor que cualquier cosa que haya publicado TypeSafe.
 ### El hueco alucinante
En cuanto vi ese ejemplo, se me abrió un mundo de posibilidades y la cabeza se me llenó de soluciones a los problemas a los que me enfrentaba. Me di cuenta de que resolvía problemas de dos de nuestros próximos proyectos, [Infinilang](https://apps.hex.pro/es/infinilang) y [kcalc.ai](https://kcalc.ai) (el sitio web de este último todavía no está terminado en el momento de escribir este artículo).
Los dos proyectos dependen de LLM para funcionar. No soy de los que meten IA en cualquier cosa solo para demostrar algo, y no es el tipo de empresa que quiero dirigir. Concebí las ideas de estos dos proyectos por mi cuenta mientras las herramientas de IA se desarrollaban durante los últimos 4 años, y ofrecen soluciones realmente innovadoras a problemas con los que la gente lleva años lidiando.
_Voy a presentar brevemente estos dos proyectos para que tengas contexto, pero en este artículo nos centraremos sobre todo en Infinilang, así que sáltate la parte de kcalc.ai si vas con prisa._
#### kcalc.ai: la calculadora de calorías que usa IA de verdad
¿Alguna vez has intentado perder o ganar peso? Yo sí. Pasé tres años en el gimnasio antes de darme cuenta de que el entrenamiento de fuerza era solo un tercio de la ecuación del culturismo. Los otros dos tercios eran el _sueño_ y la **ingesta de calorías**. Por desgracia para mí, ganar peso no se me da bien, y comer más de lo que necesito para mantener mi peso me resultaba demasiado difícil.
Probé una de esas calculadoras de calorías que encuentras en la tienda de apps. Ya sabes cuáles. Registras lo que comes a lo largo del día e intentas llegar a un objetivo. La idea es buenísima, pero la ejecución casi siempre es pésima. Pasas más tiempo registrando comida y corrigiendo el equilibrio de macronutrientes y las calorías que comiendo. Normalmente también tienen una función de cámara, que funciona más o menos el 20% de las veces y _nunca_ acierta con los macros, el tamaño de la porción o las calorías. Y para la comida casera o poco común no sirve prácticamente para nada.
Lo que kcalc.ai hace distinto es que busca reducir drásticamente la fricción de registrar lo que comes. Cuando sacas una foto o haces un escaneo LiDAR, un complejo pipeline de evidencias de 15 etapas procesa la información. Usa una combinación de LLM, una base de datos vectorial, una enorme base de datos de alimentos y recetas, modelos de visión, reconstrucción 3D a partir del escaneo LiDAR, agentes de razonamiento de varios pasos y mucho más.
En la práctica, la parte de IA de esta app ha supuesto un esfuerzo enorme. No es de extrañar que pocos lo hayan intentado, porque exige una cantidad inmensa de experiencia en ingeniería de software y un pensamiento sistémico avanzado que poca gente tiene. Sencillamente no sería posible sin la ayuda de un agente de programación con IA, o sin 10 millones de dólares estadounidenses y un año de trabajo de 5 ingenieros.
kcalc.ai se enfrenta a varios problemas serios que había que resolver para que fuera comercialmente viable. Los dos grandes eran la **evaluación de la precisión** y la **velocidad**.
Veamos un caso.
> El usuario sube una foto de "patatas fritas belgas con mayonesa".
El pipeline de evidencias procesa la imagen, y la combinación de etapas, sumada a varios pasos de razonamiento del LLM, llega a la conclusión de que, efectivamente, son patatas fritas belgas, probablemente con mayonesa. Lo interesante de kcalc.ai es que no devuelve necesariamente al usuario un registro preconfigurado. Genera un registro de forma dinámica a partir del contexto y de medidas reales del tamaño, con cálculos de volumen. Todo eso está muy bien. Funciona, aunque tarda unos 2 minutos en recorrer todo el pipeline.
La app incluye una función llamada 'Atlas mundial' que permite a los usuarios coleccionar cocinas nacionales o "clásicos" e ir completando su mapa del mundo. Por eso, al final de la identificación del alimento hay que comprobar una lista de cocinas. ¿Cómo lo hacemos? Tradicionalmente, habríamos usado algún tipo de expresión regular (regex) o un algoritmo de similitud para buscar en la lista y encontrar las coincidencias probables. Es lo primero que probé, y provocaba errores constantes: el sistema otorgaba entradas del atlas confundiendo alimentos con nombres parecidos. Así que la siguiente opción obvia era sacar las coincidencias probables y que un LLM eligiera la más adecuada. El problema es que consumía demasiados recursos de cómputo y no podía justificar bloquear la estimación de calorías por una función extra menor.
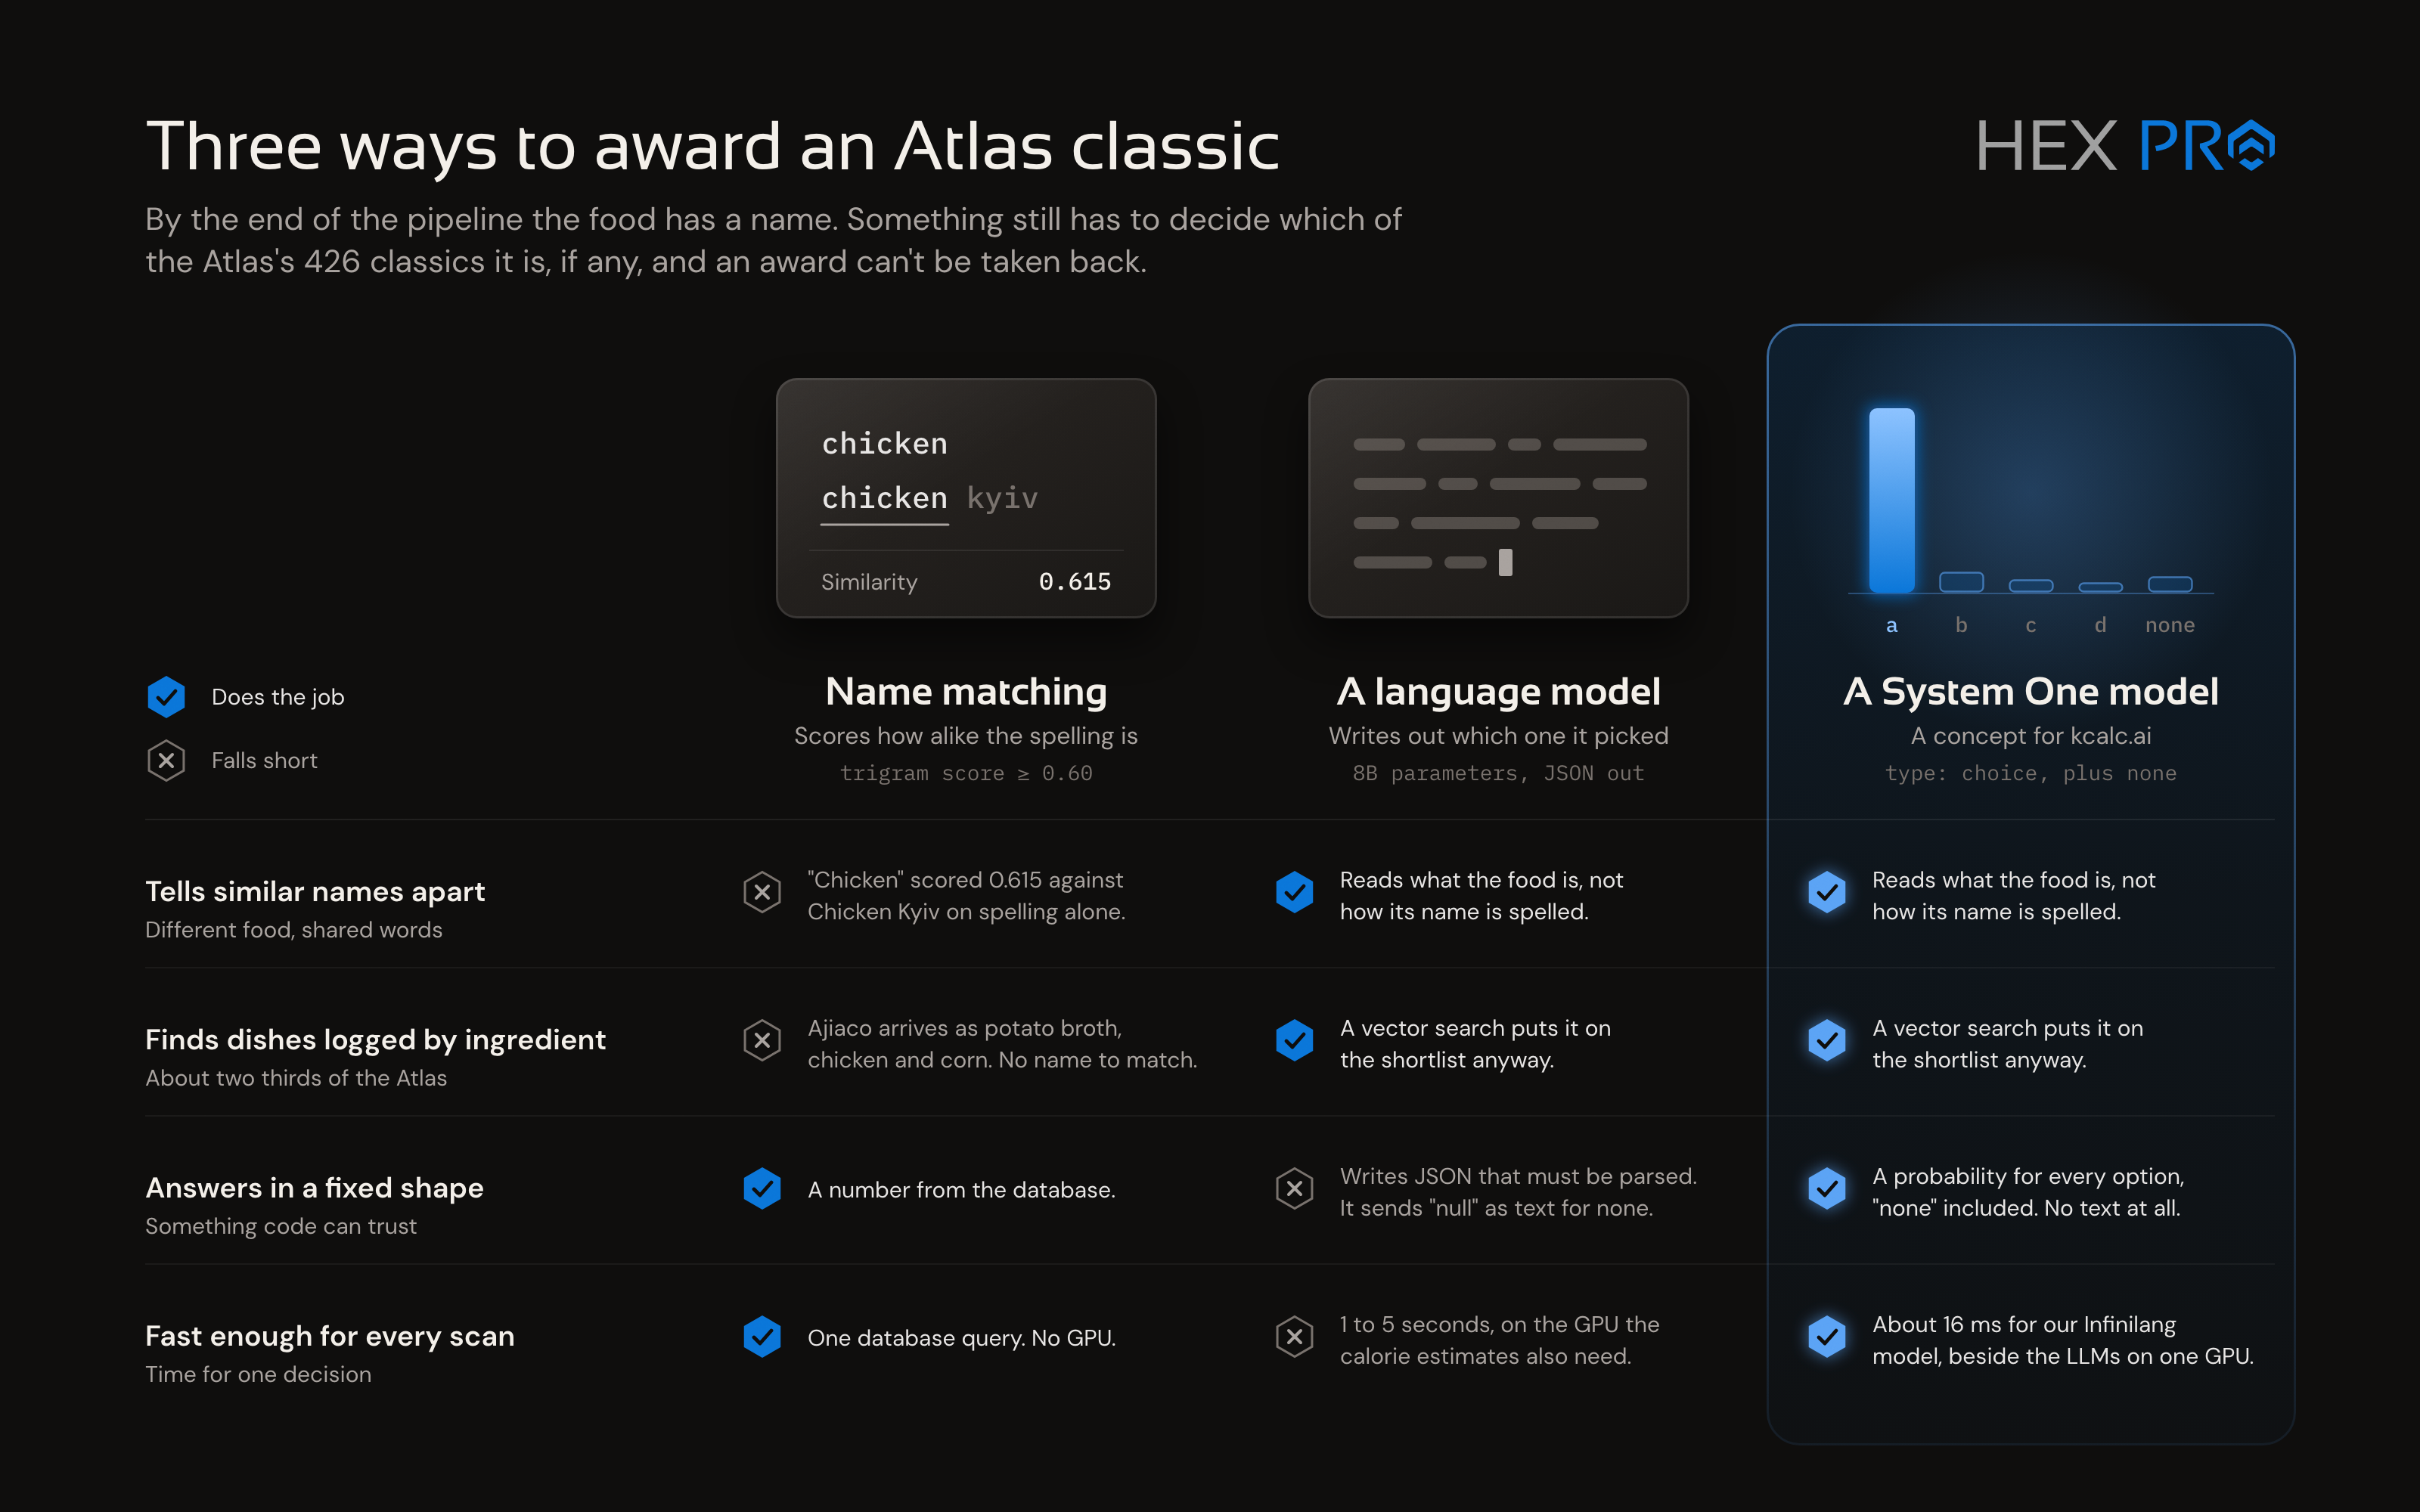 Un modelo System One combinado con una base de datos vectorial ofrece la solución.
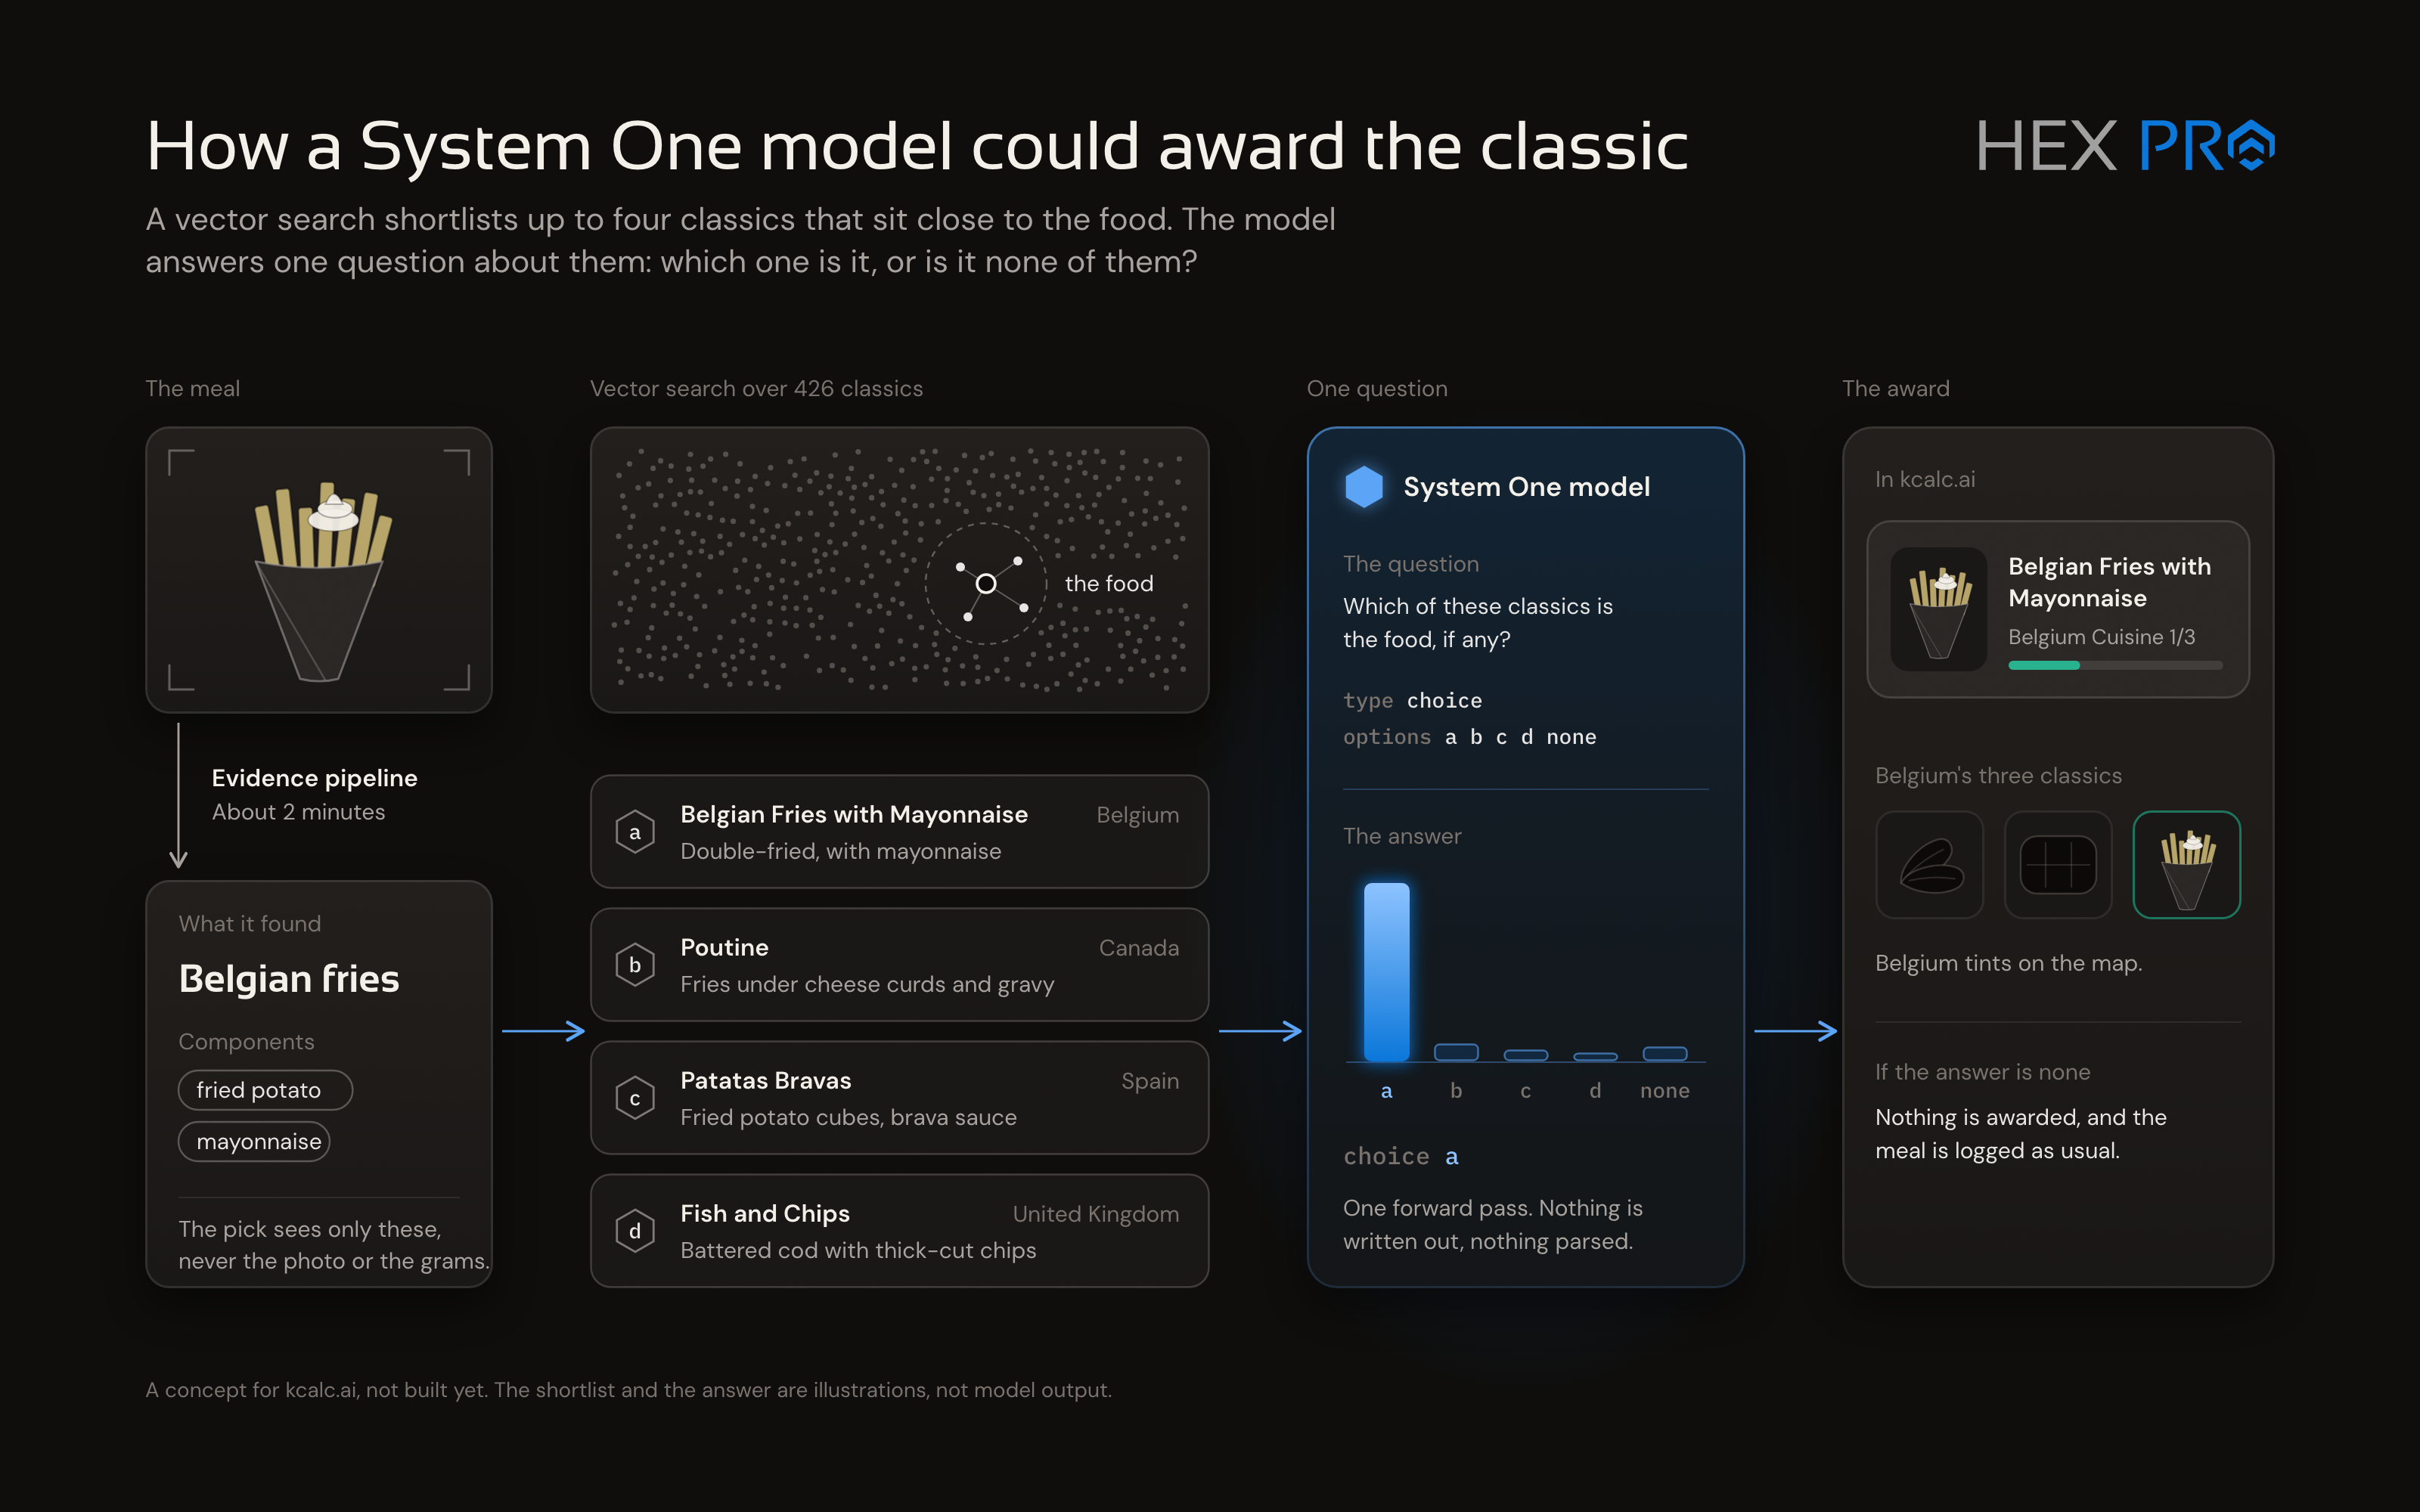 Con un modelo System One, obtener una selección precisa lleva milisegundos, y el coste en recursos es increíblemente bajo en comparación con un LLM completo. Es un salvavidas en situaciones con muchas opciones que pueden parecerse entre sí.
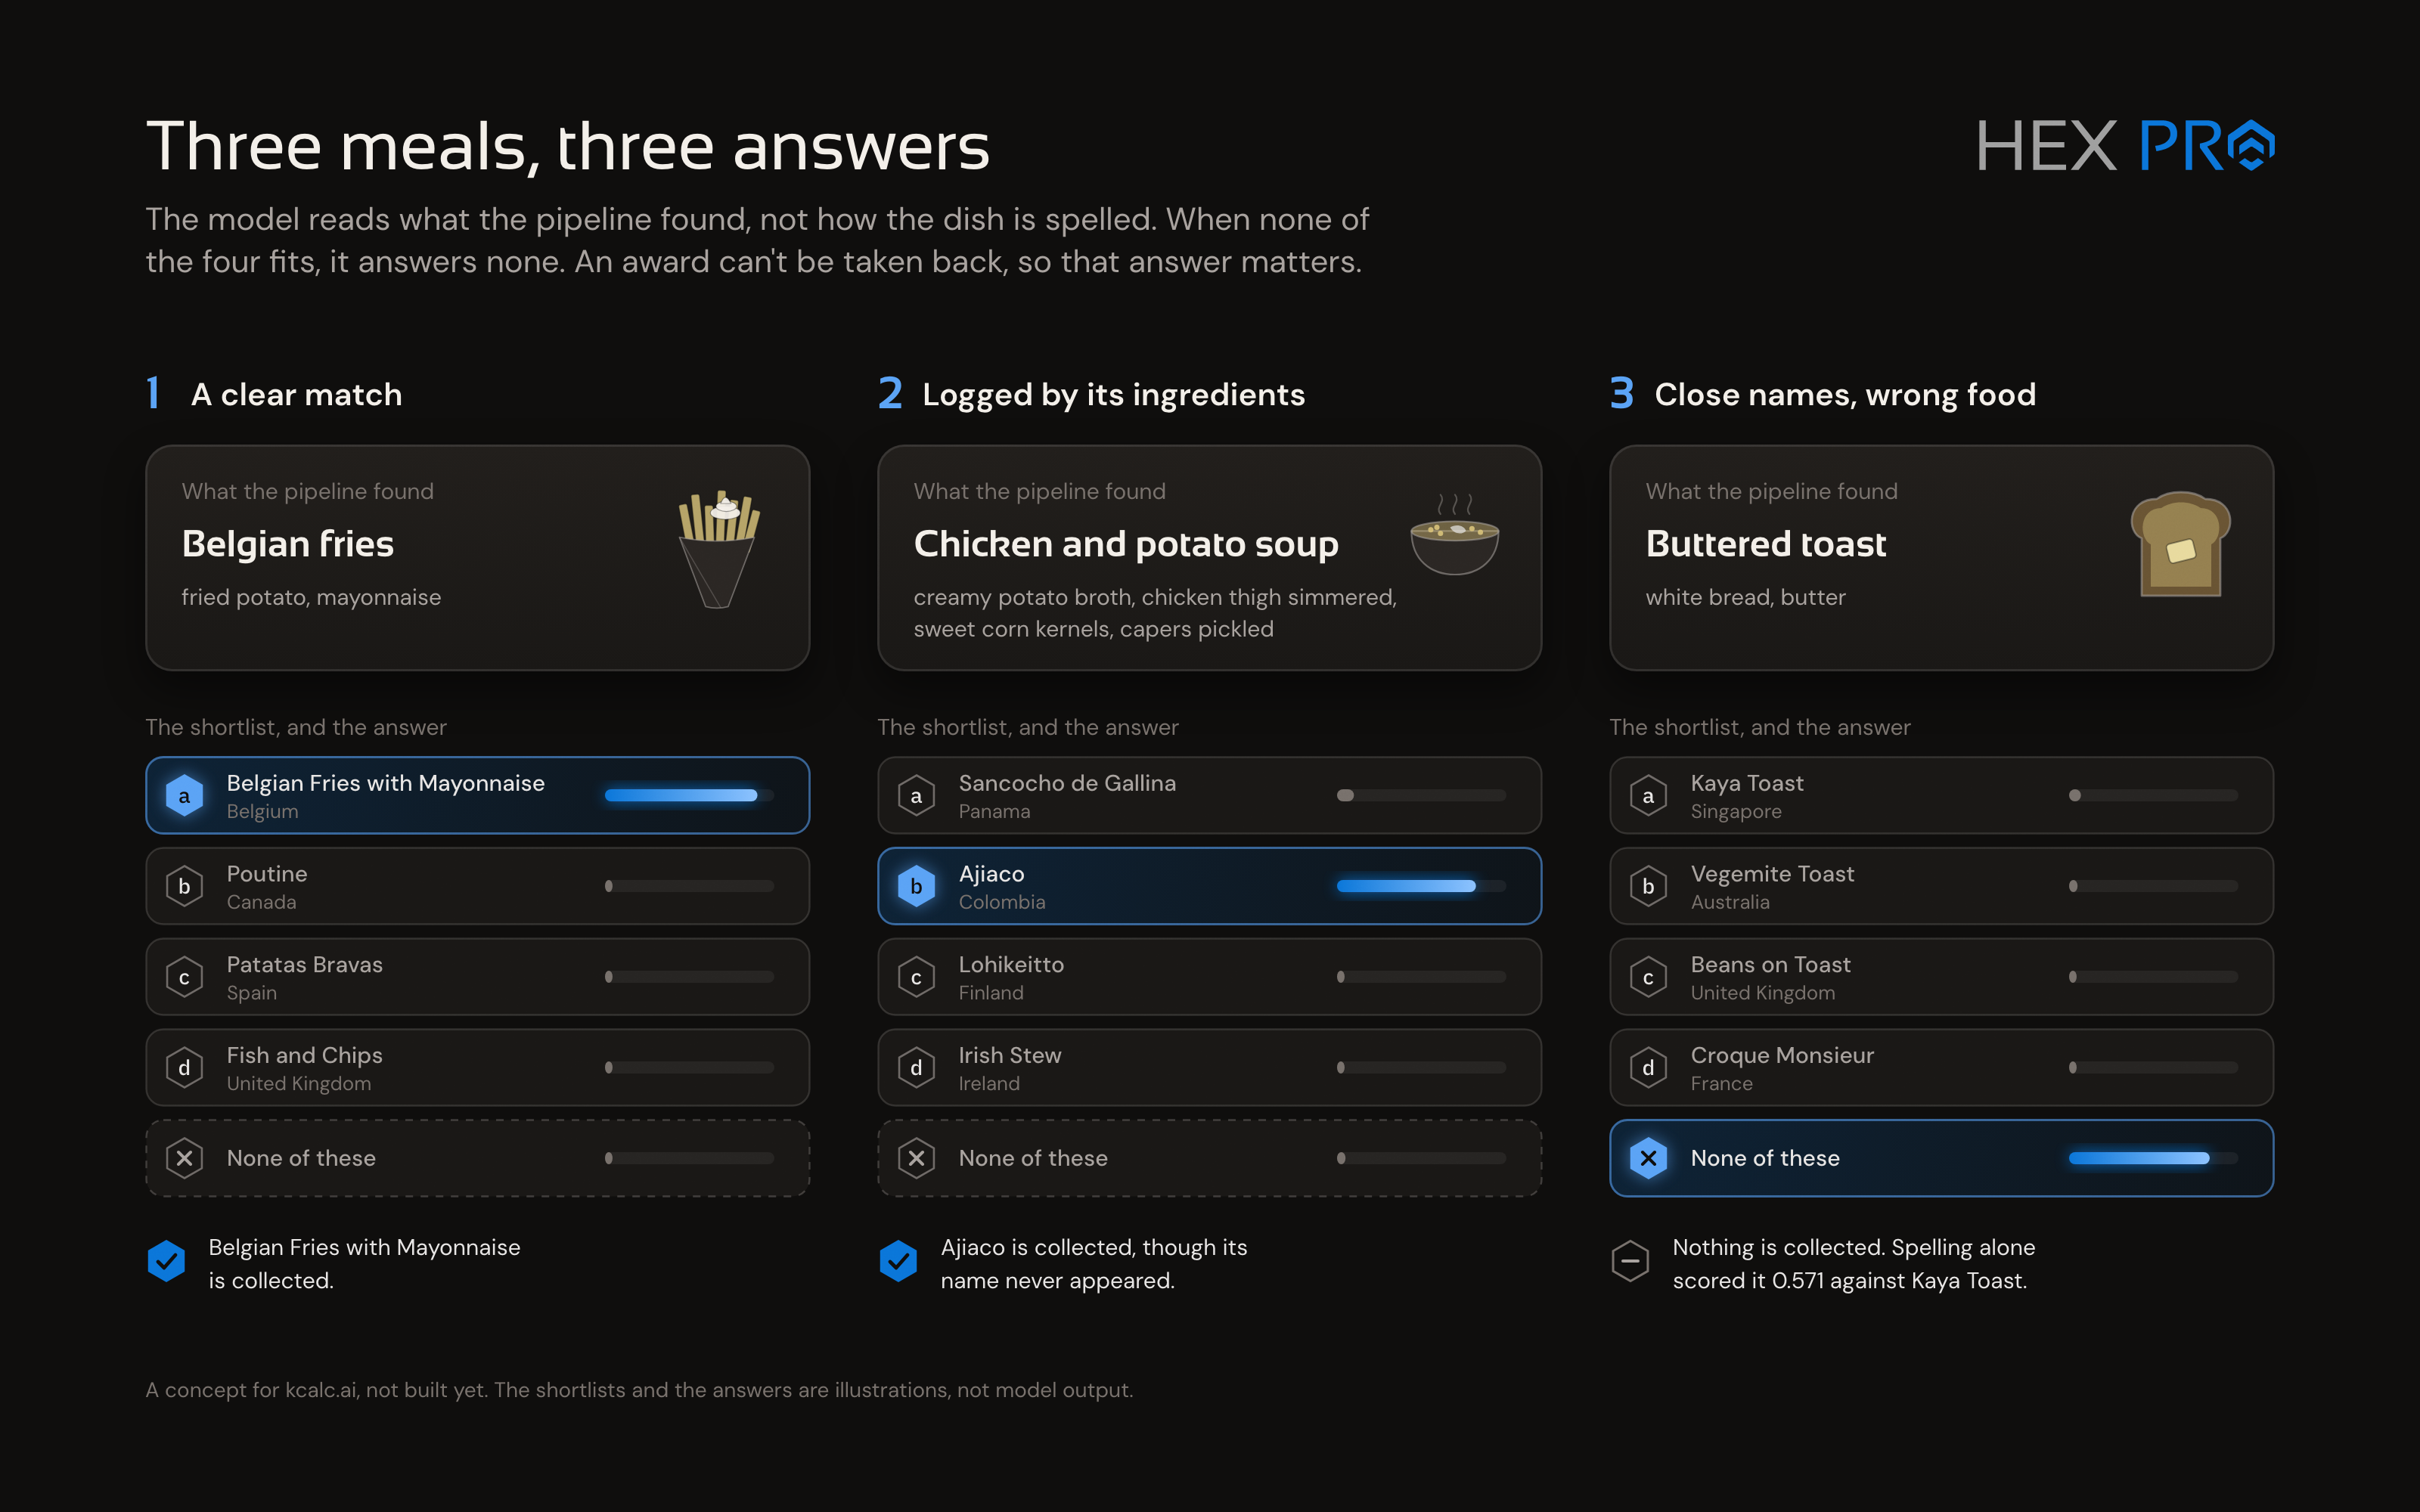 Lo verdaderamente bonito de la interfaz de los modelos System One es lo increíblemente fácil que resulta integrarla. Podrías encontrar cientos de sitios donde encajar un modelo así en tu código, y es tan barato y rápido que apenas hay que pensárselo dos veces. Este es solo un ejemplo de los muchos casos en los que creo que kcalc.ai se beneficiará de esta nueva tecnología.
#### Infinilang: el mejor amigo de quien estudia japonés
Como estudiante de japonés de toda la vida, con muy poco tiempo y (para ser sincero) poco talento para los idiomas, he conseguido un dominio más o menos aceptable del idioma. Suficiente para moverme por Japón e incluso entablar alguna conversación divertida en los bares, pero no lo bastante para librarme de los "nihongo jyouzu" ("¡qué bien hablas japonés!").
Una de las partes más difíciles de aprender japonés son los 'kanji', el tercer conjunto de caracteres que forma el sistema de escritura japonés, y el más numeroso. Aquí tienes un ejemplo de los tres conjuntos de caracteres:
- **Hiragana**: ありがとうございます (romanizado _arigatou gozaimasu_ "Muchas gracias")
- **Katakana**: コールドブリューアイスコーヒー (romanizado _korudo buru aisu kohi_ "Café cold brew con hielo")
- **Kanji**: 人工知能 (romanizado _jinkou chinou_ "Inteligencia artificial")
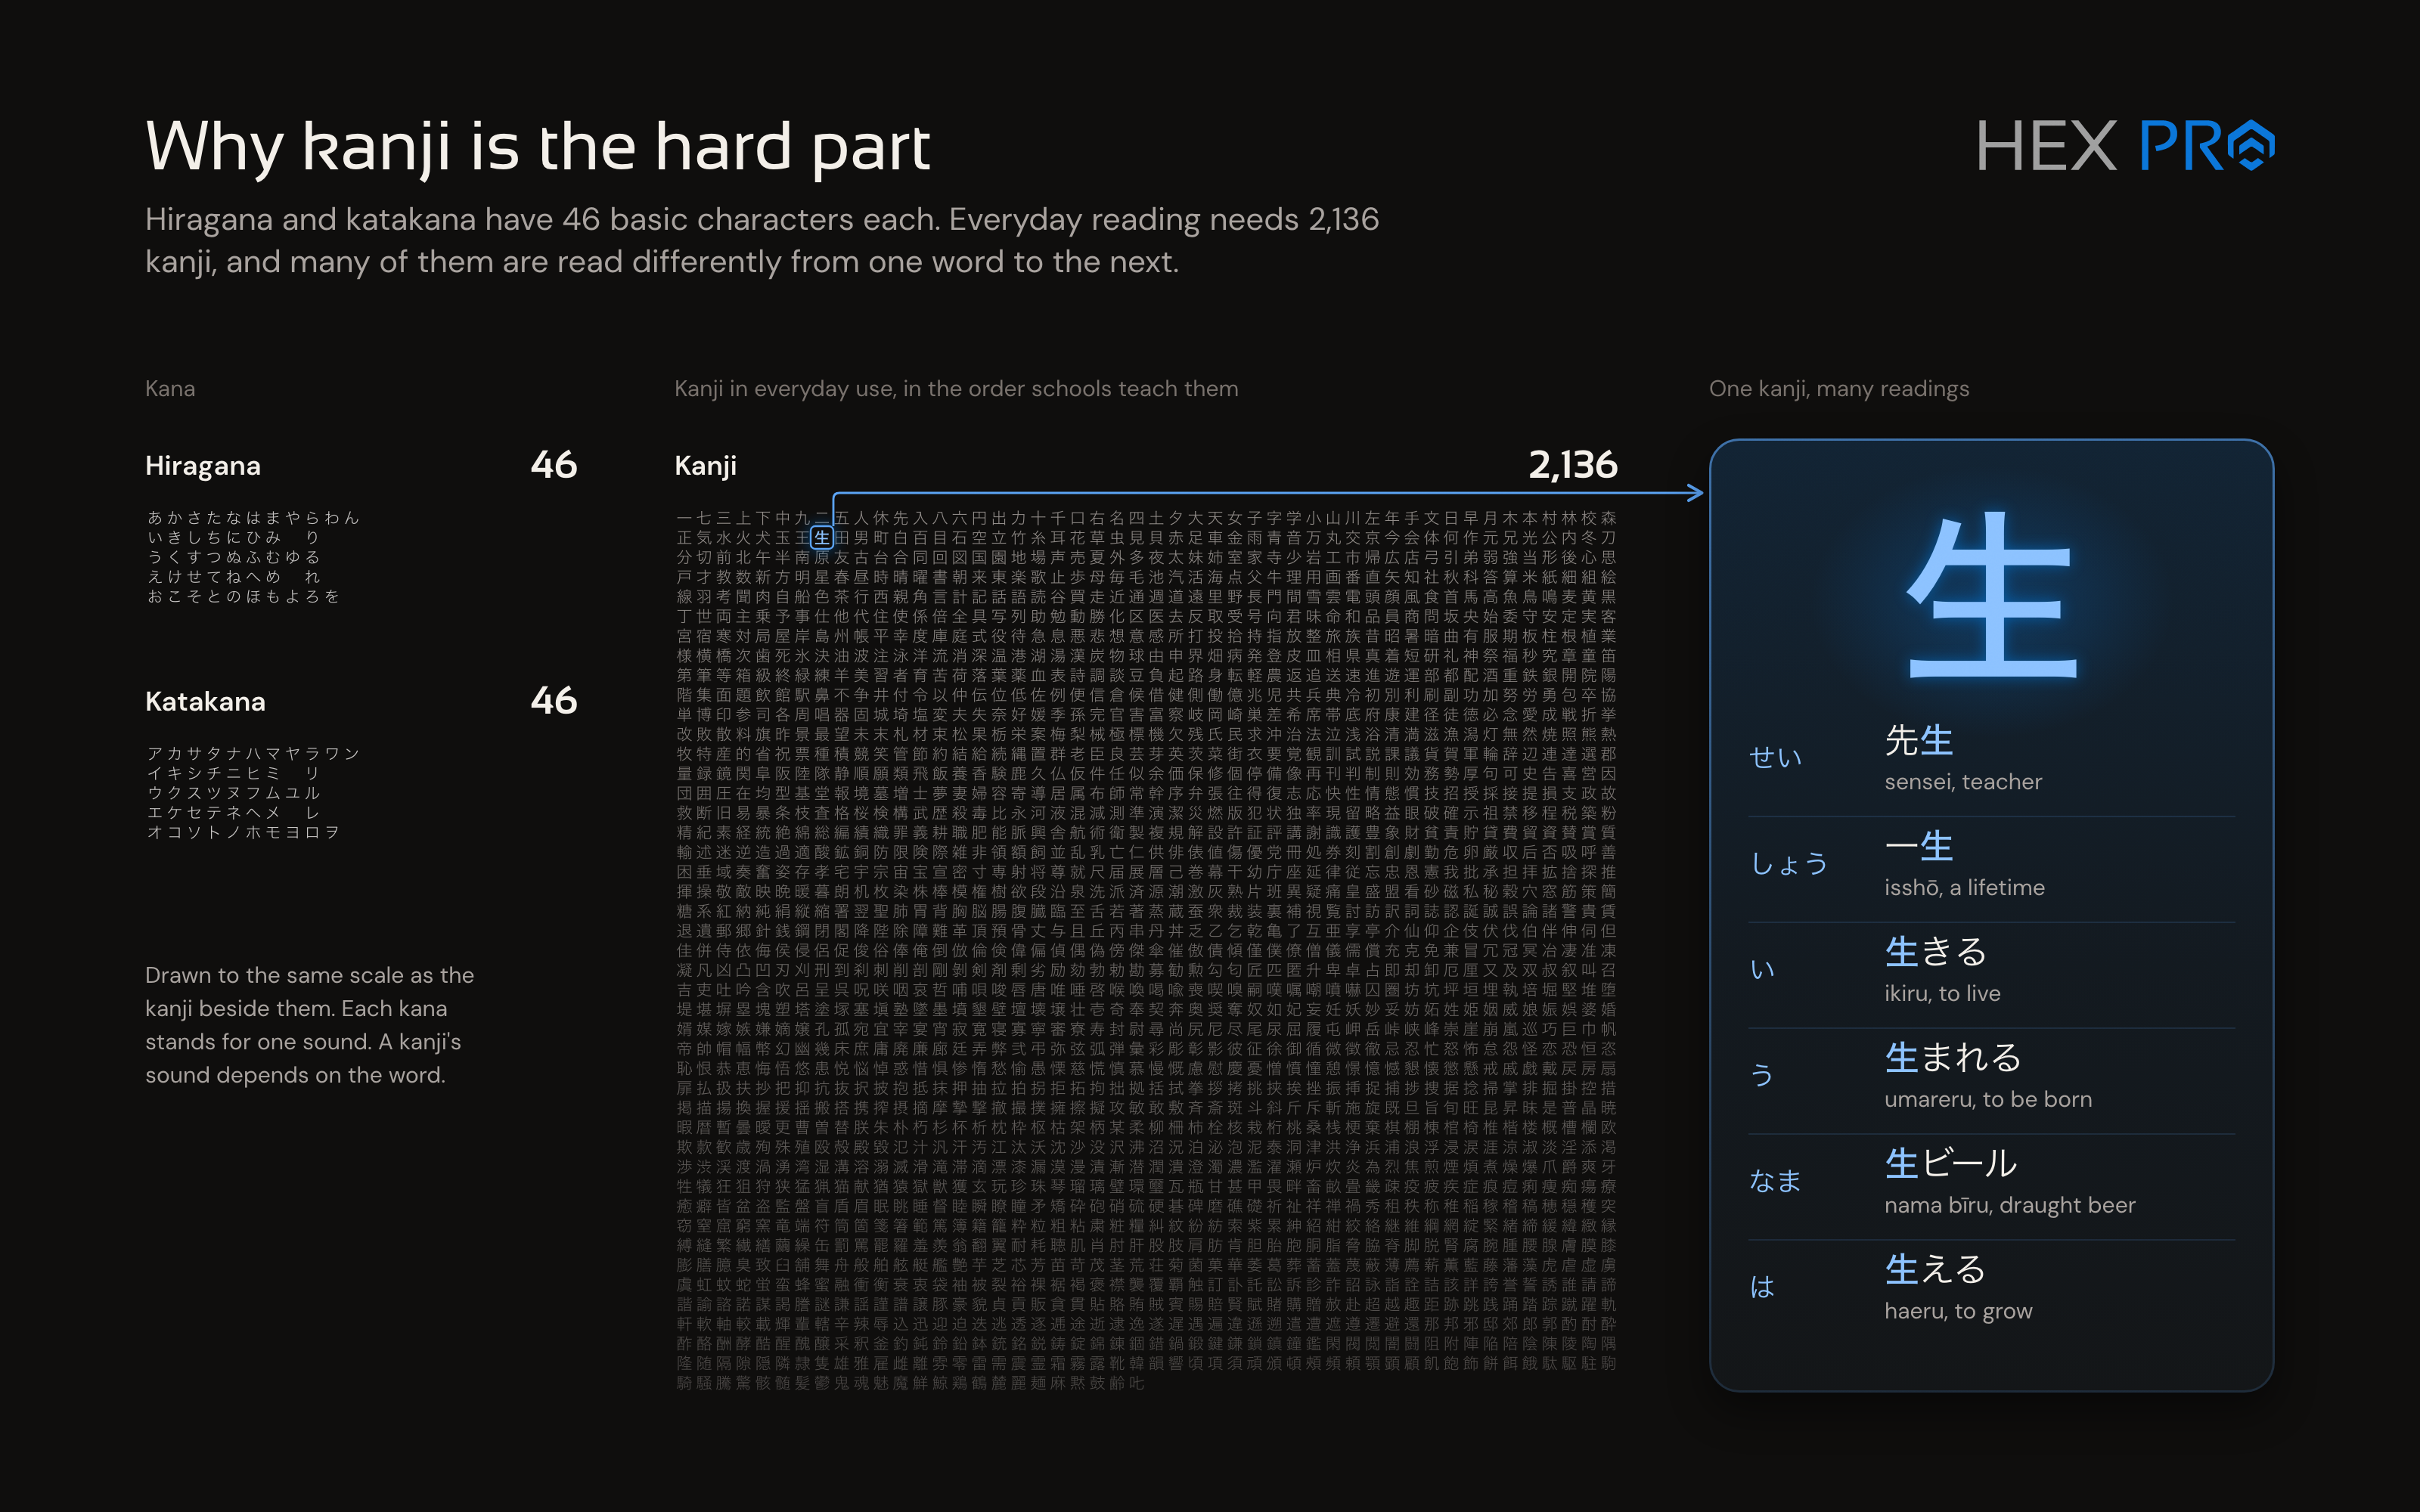
Los kanji derivan de los caracteres chinos y comparten algunos de sus significados, aunque normalmente con pronunciaciones completamente distintas. Lo complicado es que hacen falta 2136 kanji de uso común para una alfabetización funcional, y unos 4000 para acercarse al nivel de un hablante nativo. Para colmo, los kanji suelen tener varias _lecturas_, es decir, se pronuncian de forma distinta según dónde se usen. _Una auténtica pesadilla de aprender_.
 Cuando salió GPT-3 de OpenAI, fui uno de los primeros en adoptarlo y enseguida vi las posibilidades casi infinitas de la tecnología. La gran posibilidad para mí era una experiencia de aprendizaje de idiomas a medida, una forma de aprender un idioma con más eficacia que nunca.
En aquel momento concebí tres aplicaciones novedosas de los LLM, y estuve años dándoles vueltas a esas ideas. En ese tiempo desarrollé dos versiones de prototipos de la tecnología y demostré que funciona.
## La eficacia de la inteligencia artificial para acelerar la adquisición de idiomas
Ese título tan deliciosamente académico era el de una tesis en la que trabajaba para un máster, basada en la idea de Infinilang. Al principio quería aportar estas herramientas como investigación de código abierto, pero trabajar a jornada completa y la falta de recursos lo hicieron demasiado complicado. Así que, en su lugar, pienso lanzar Infinilang primero como app móvil de código cerrado. Más adelante, pienso publicarla como aplicación de escritorio de código abierto que te permita usar tu propia IA.
Entonces, ¿qué aporta Infinilang? Para quien estudia japonés, memorizar los kanji es solo una parte de aprender a leer bien. Hoy por hoy, la memorización es un proceso lento y tedioso basado en sistemas de repetición espaciada (SRS, por sus siglas en inglés). Los más famosos son Anki y WaniKani, este último mi favorito. Un SRS muestra al usuario tarjetas de memoria una y otra vez, alargando progresivamente el tiempo entre cada exposición. El sistema está pensado para enseñarte cada vez un carácter que has aprendido justo antes de que lo olvides. Cuantas más veces ves la tarjeta, más tiempo retienes la información, y esa retención es más eficaz si la ves cada vez con menos frecuencia. Está [demostrado que el SRS es la mejor forma de **memorizar** kanji](https://doi.org/10.1037/0033-2909.132.3.354), pero su mayor punto débil es enseñarte a _leer_ con soltura oraciones que contienen kanji.
> Lee artículos de NHK Easy, o libros infantiles, y listo.
El consejo de siempre ha sido buscar material de lectura sencillo y hacer lo posible por descifrar los kanji desconocidos con ayuda del furigana 東京, las pequeñas marcas de pronunciación en hiragana que aparecen encima de los kanji en algunos medios. El problema es evidente. Basta con que no conozcas un solo kanji para tropezar por completo, y a menudo la oración se vuelve ilegible.
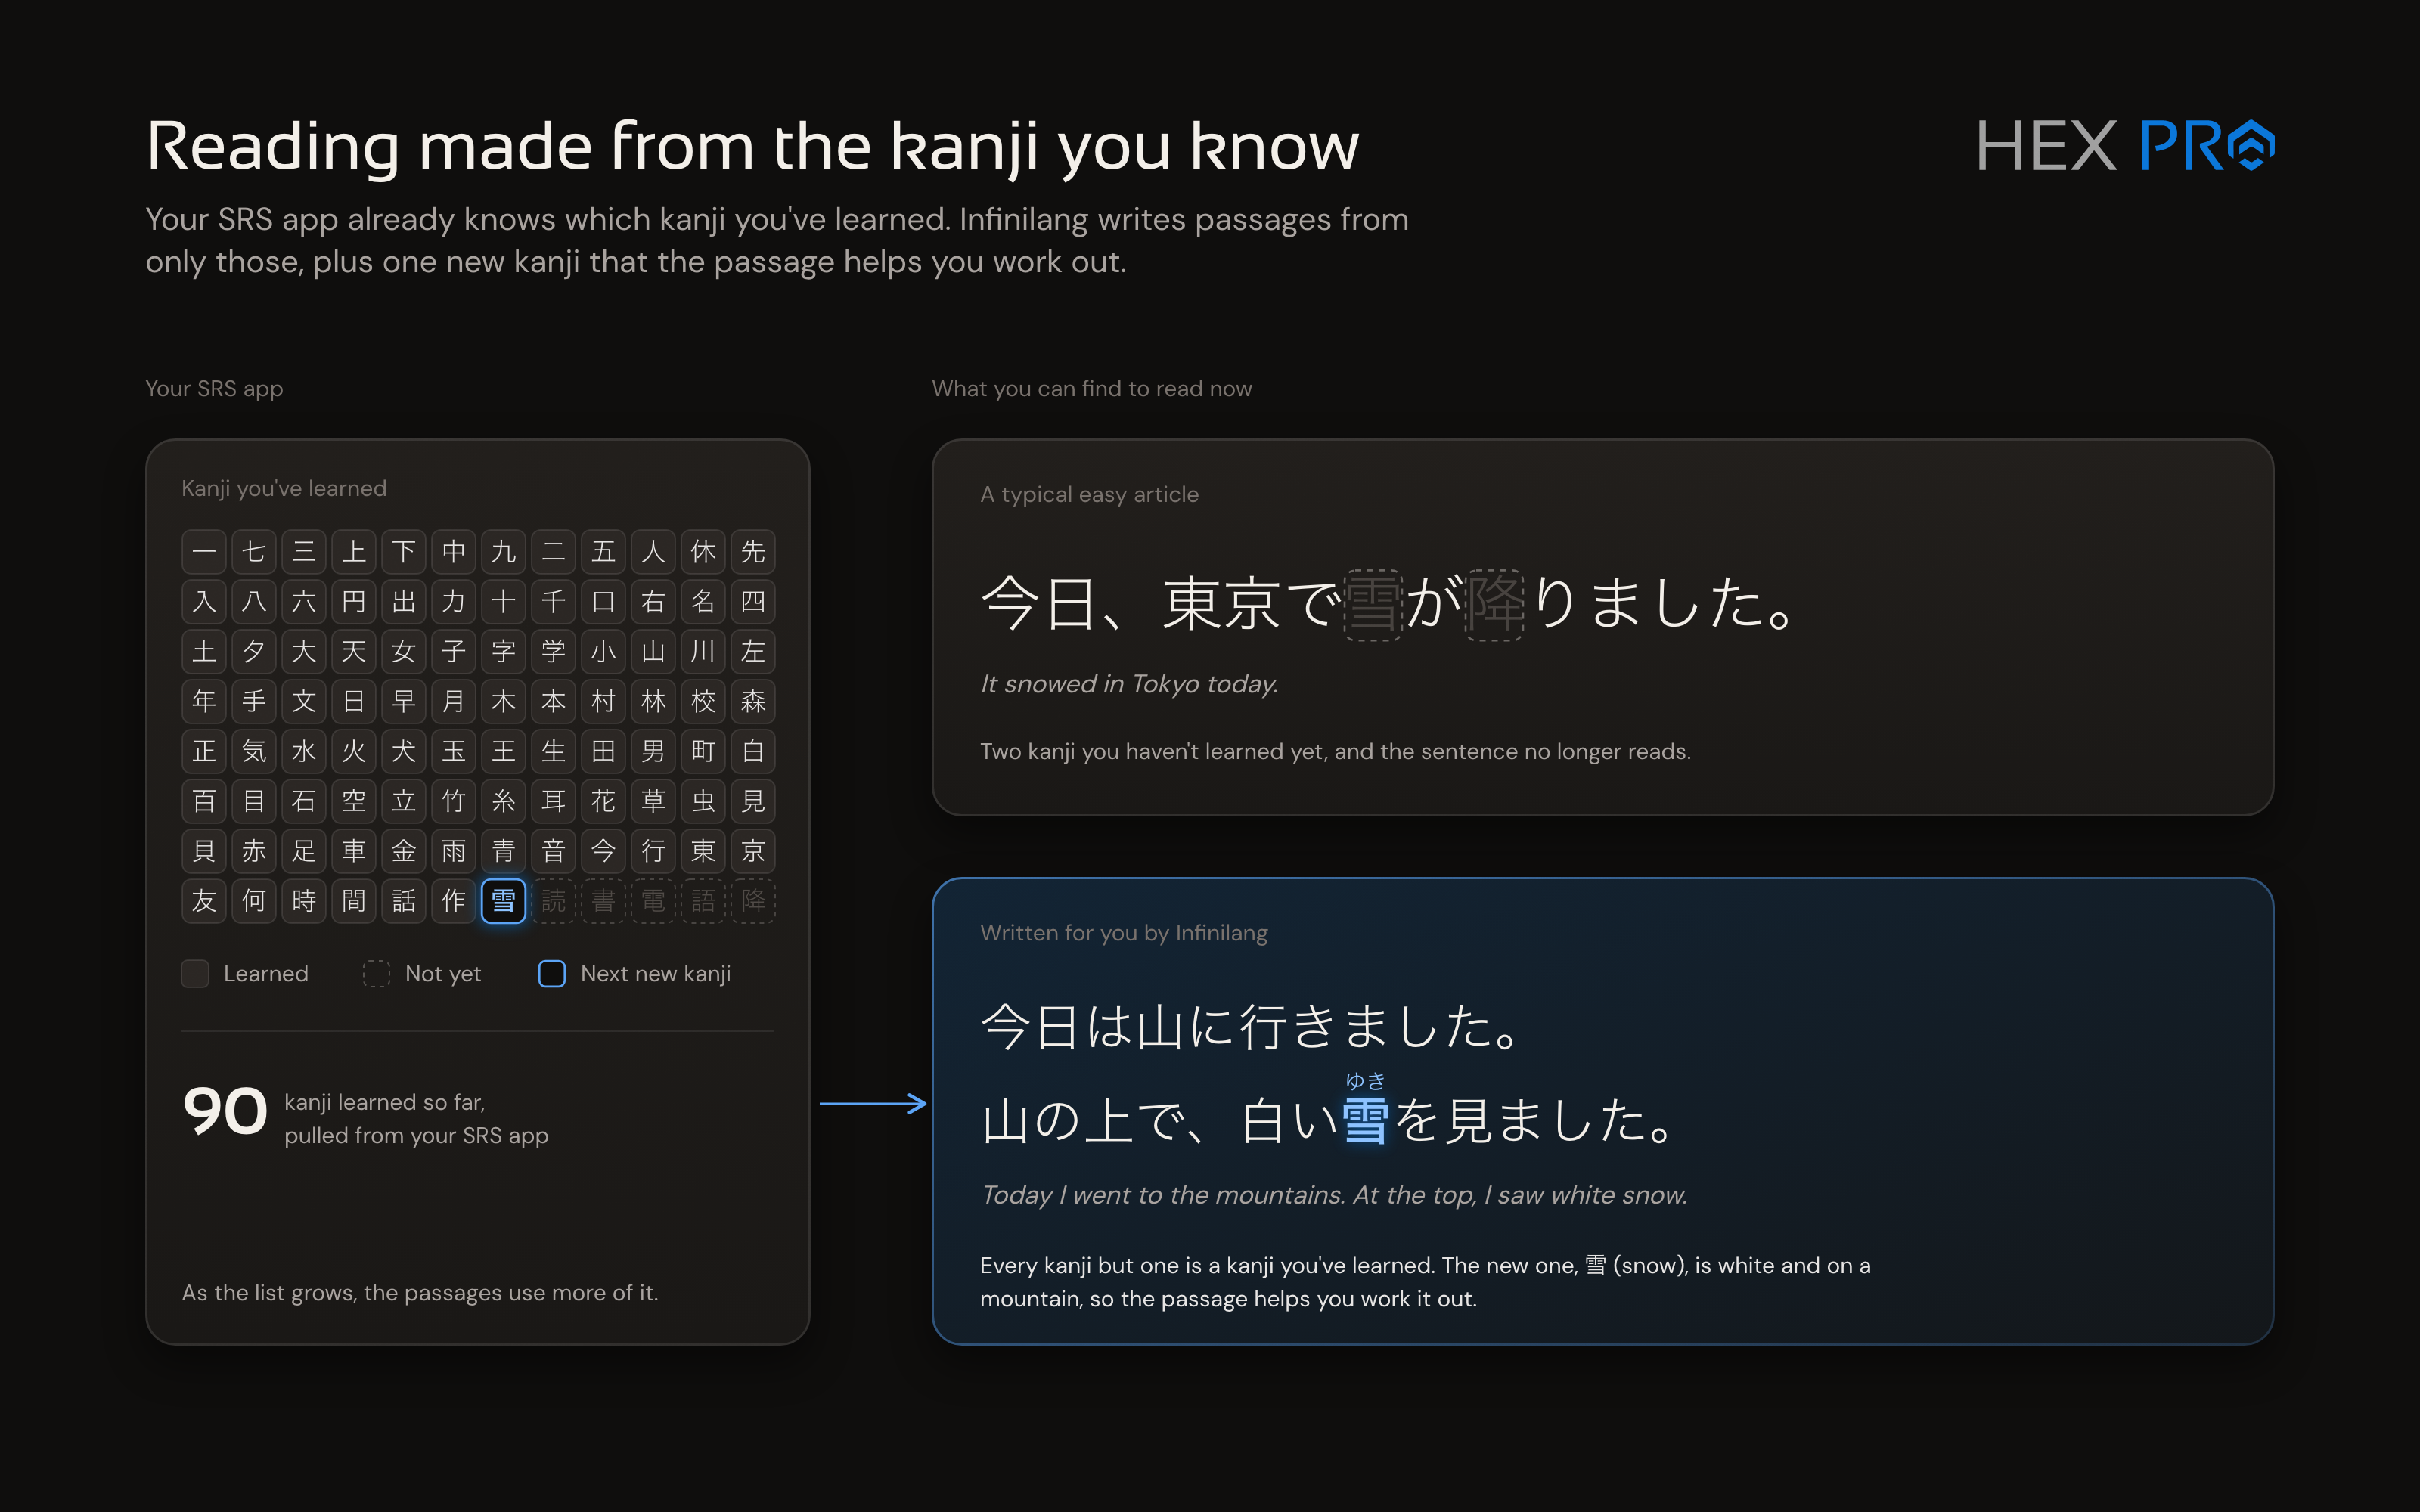
Así que la idea es esta. Las apps de SRS ofrecen un sistema excelente para llevar la cuenta de qué kanji has aprendido y qué dominio tienes de cada uno. ¿Y si pudieras encontrar material de lectura compuesto solo por kanji que ya has aprendido? Eso es lo que los LLM pueden hacer, y ahí es donde entra Infinilang.
### Generar material de lectura en japonés con restricciones
El objetivo de Infinilang (fase 1) es producir material de lectura ajustado exactamente al nivel del usuario. Le damos a un LLM los kanji que has aprendido, que se obtienen directamente de tu app de SRS, y luego generamos oraciones dentro de ese conjunto restringido de caracteres. No es tan sencillo como pasarle el conjunto de caracteres a un LLM y obtener un material de lectura estupendo. Conseguir que la IA haga bien la tarea es mucho más difícil de lo que cabría esperar. Pero _sí_ funciona.
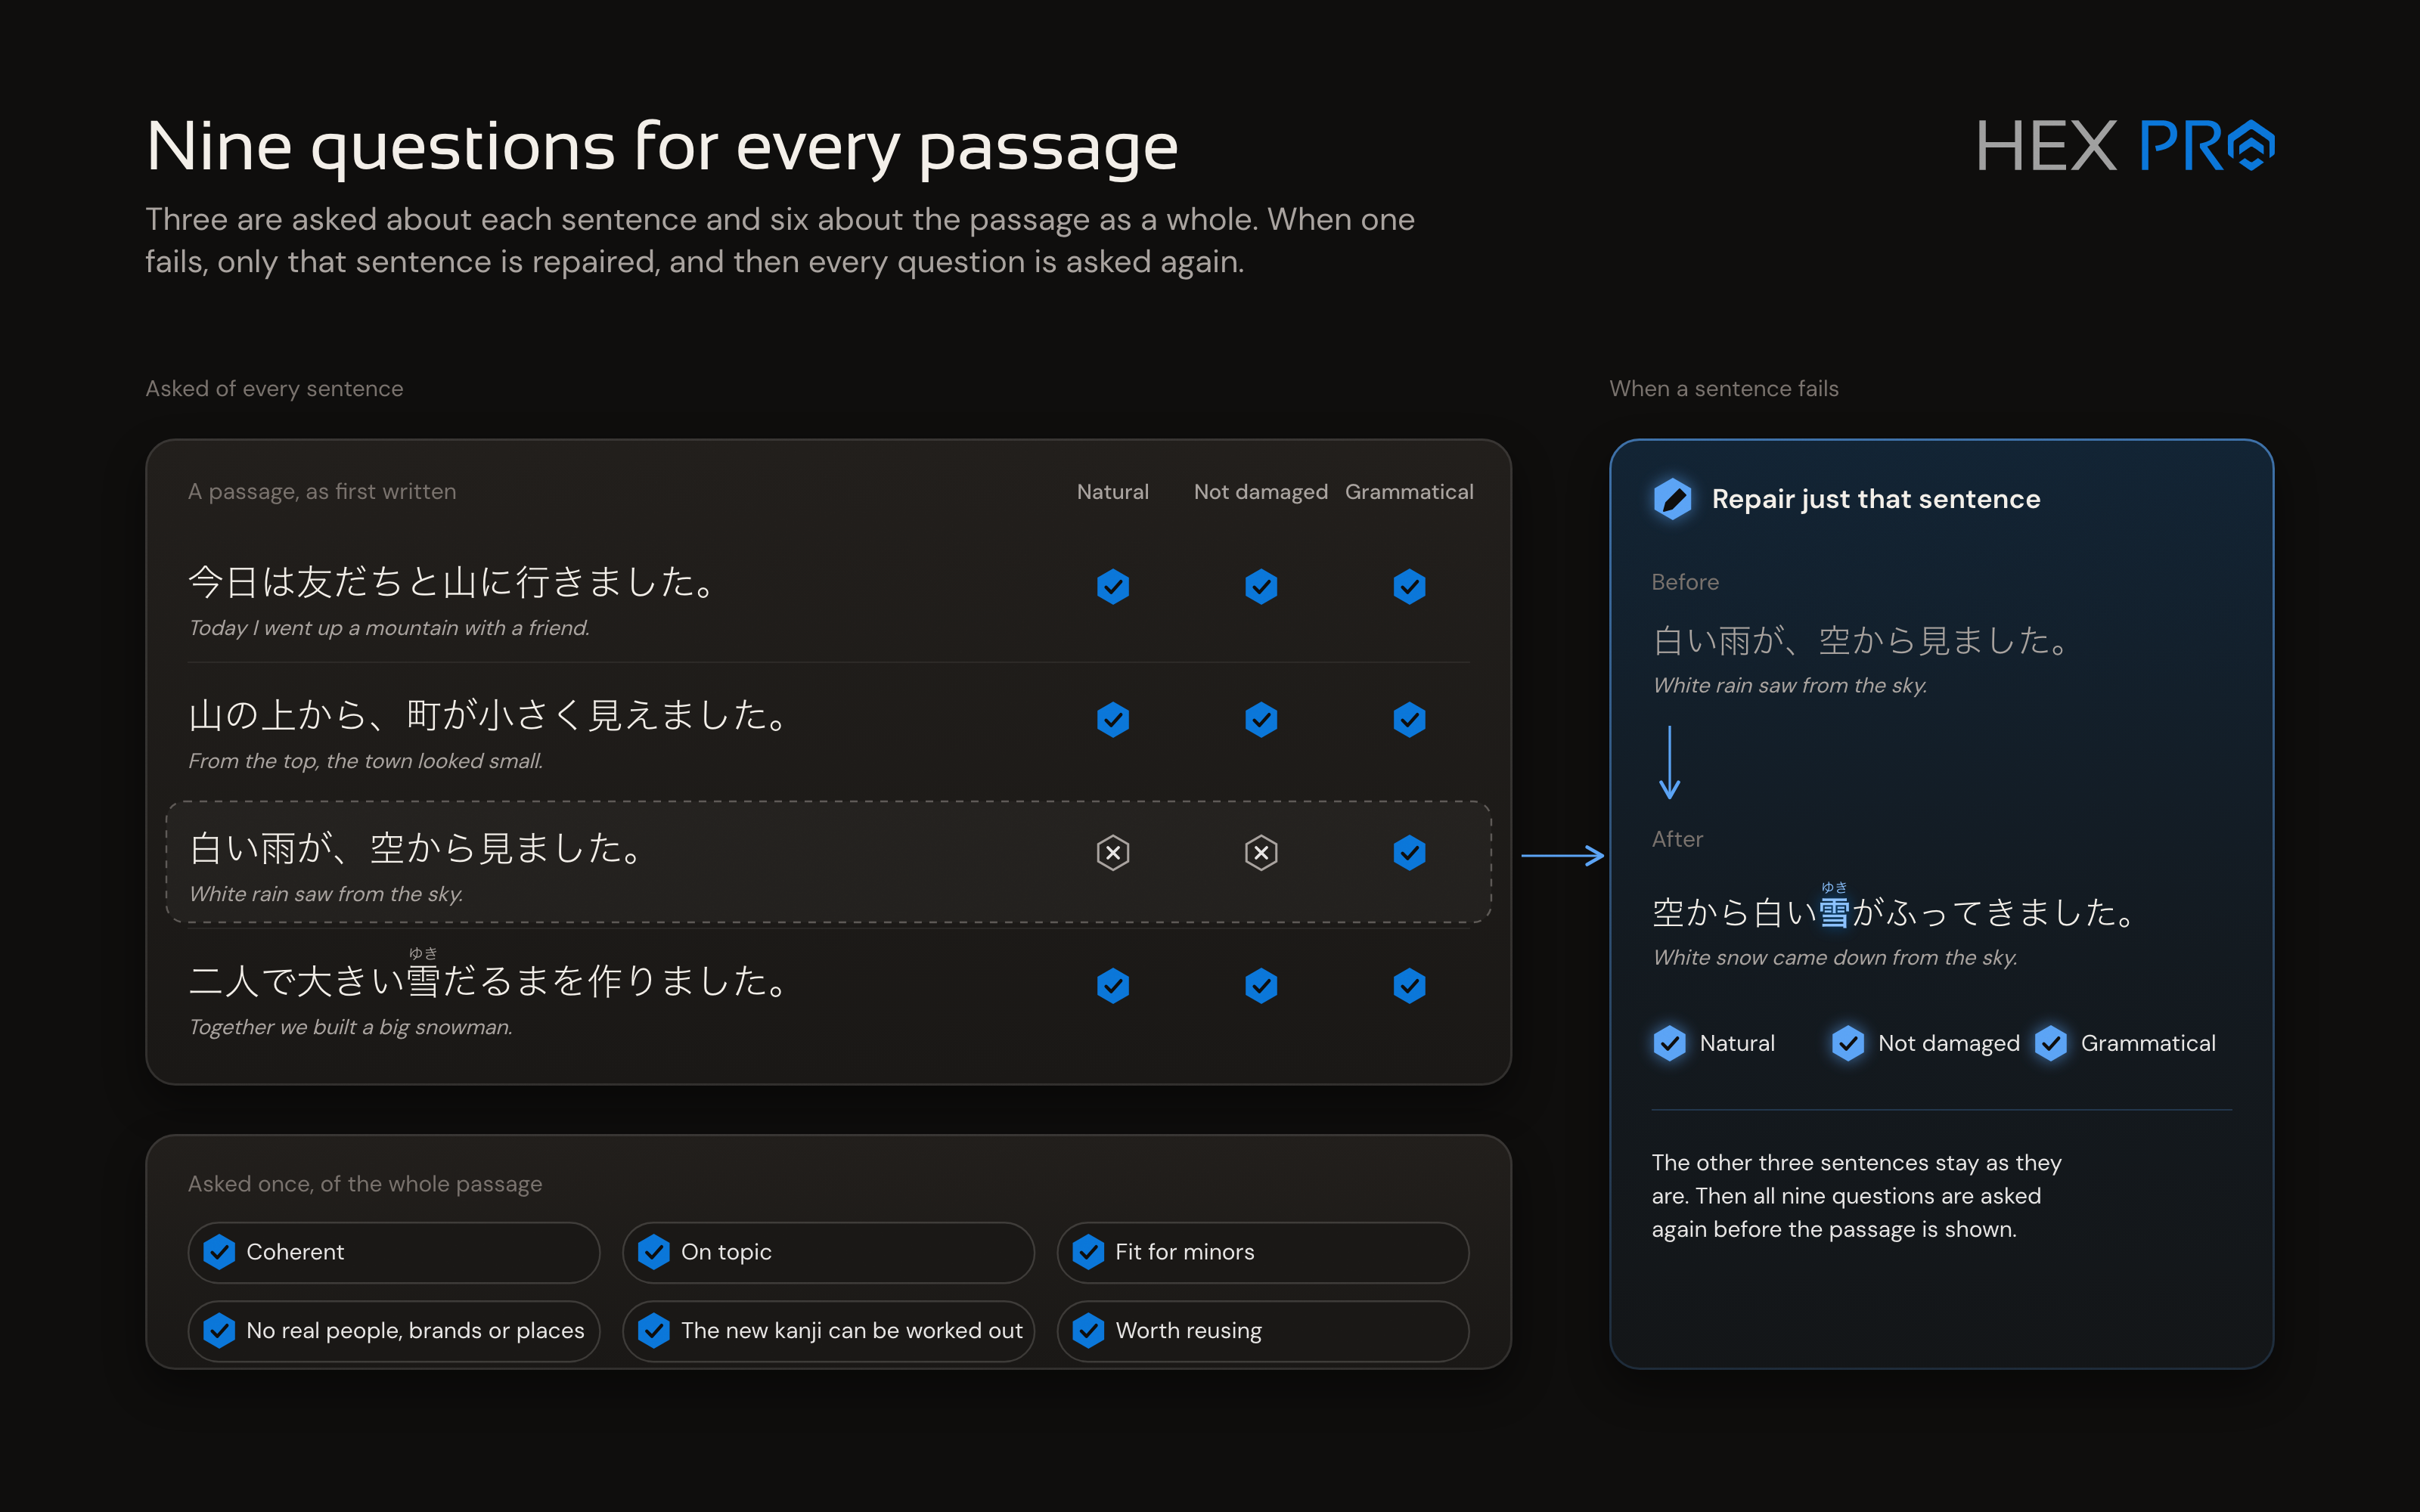
 Los retos de producir material de lectura de alta calidad se agrupan en varias familias: básicamente, preguntas que hay que hacerse para asegurarse de que el LLM no se ha equivocado y, si se ha equivocado, si podemos reparar los errores sin generar una respuesta completamente nueva.
- ¿Hasta qué punto es natural la oración?
- ¿La oración parece filtrada o dañada?
- ¿El texto es coherente?
- ¿El texto se ajusta al tema?
- ¿El texto es apropiado para menores?
- ¿Contiene personas, marcas o lugares reales?
- ¿Se puede deducir por el contexto una inserción N+1?
- ¿Vale la pena reutilizar el texto en el futuro?
- ¿La oración es gramatical?
No es una lista exhaustiva, pero son las principales preguntas que hay que hacerse sobre el contenido generado.
### Créditos, créditos y más CRÉDITOS DE API
Algo que quedó clarísimo desde el principio es que usar la API de un LLM de terceros hundiría el proyecto antes de empezar. Los créditos de API son sencillamente demasiado caros y se comerían la mayor parte de los ingresos de las suscripciones. O peor aún, nos harían entrar en números rojos.
Solo había una solución: construir nuestra propia infraestructura de IA. No es tarea fácil para alguien que monta una startup con poco capital disponible. La buena noticia es que los LLM más pequeños son más capaces cada pocos meses. Desde luego no están al nivel de los modelos de frontera; tener un LLM de la categoría de Opus con el que trabajar es algo con lo que solo puedo soñar. Pero con una arquitectura de software de alcance muy acotado y bien apoyada (es decir, mucho trabajo para domar al modelo), estos LLM más pequeños pueden producir resultados de alta calidad.
Eso no resuelve que la infraestructura sea de pequeña escala al principio, y los recursos de inferencia serán limitados con miles de usuarios generando contenido cada día. Además, tenemos que generar el contenido a una velocidad razonable. Nadie quiere quedarse 2 minutos esperando a que aparezca en pantalla un párrafo en japonés, por muy bueno que sea.
Así que las tareas de inferencia que la IA tendría que realizar en cada generación podrían ser estas:
1. Generar una oración, un párrafo o un relato corto dentro de las restricciones. Probablemente requiere algo de razonamiento, y cuanto más largo es el contenido, más tiempo lleva.
2. Evaluar el material producido según las familias de preguntas de la lista anterior.
3. Someter las oraciones a pasadas de reparación quirúrgicas y específicas allí donde las correcciones no pudieran aplicarse mediante código.
4. Repetir el paso 2 una vez más.
5. Posiblemente, repetir el paso 3 y el paso 2 una vez más antes de enviar el contenido al usuario.
 Incluso con una GPU de nivel empresarial y caché de prefijos, este proceso puede tardar uno o dos minutos, y solo tenemos 8 huecos para inferencia en paralelo, lo que significa que los trabajos tienen que ponerse en cola cuando más de 8 personas intentan generar contenido a la vez. Nada práctico, se mire por donde se mire.
Y aquí es donde entran en escena los modelos System One.
## Cómo Jev lo cambió todo
Los modelos System One tienen algunas ventajas clave sobre los LLM tradicionales que los hacen increíblemente útiles en casos de uso como el mío.
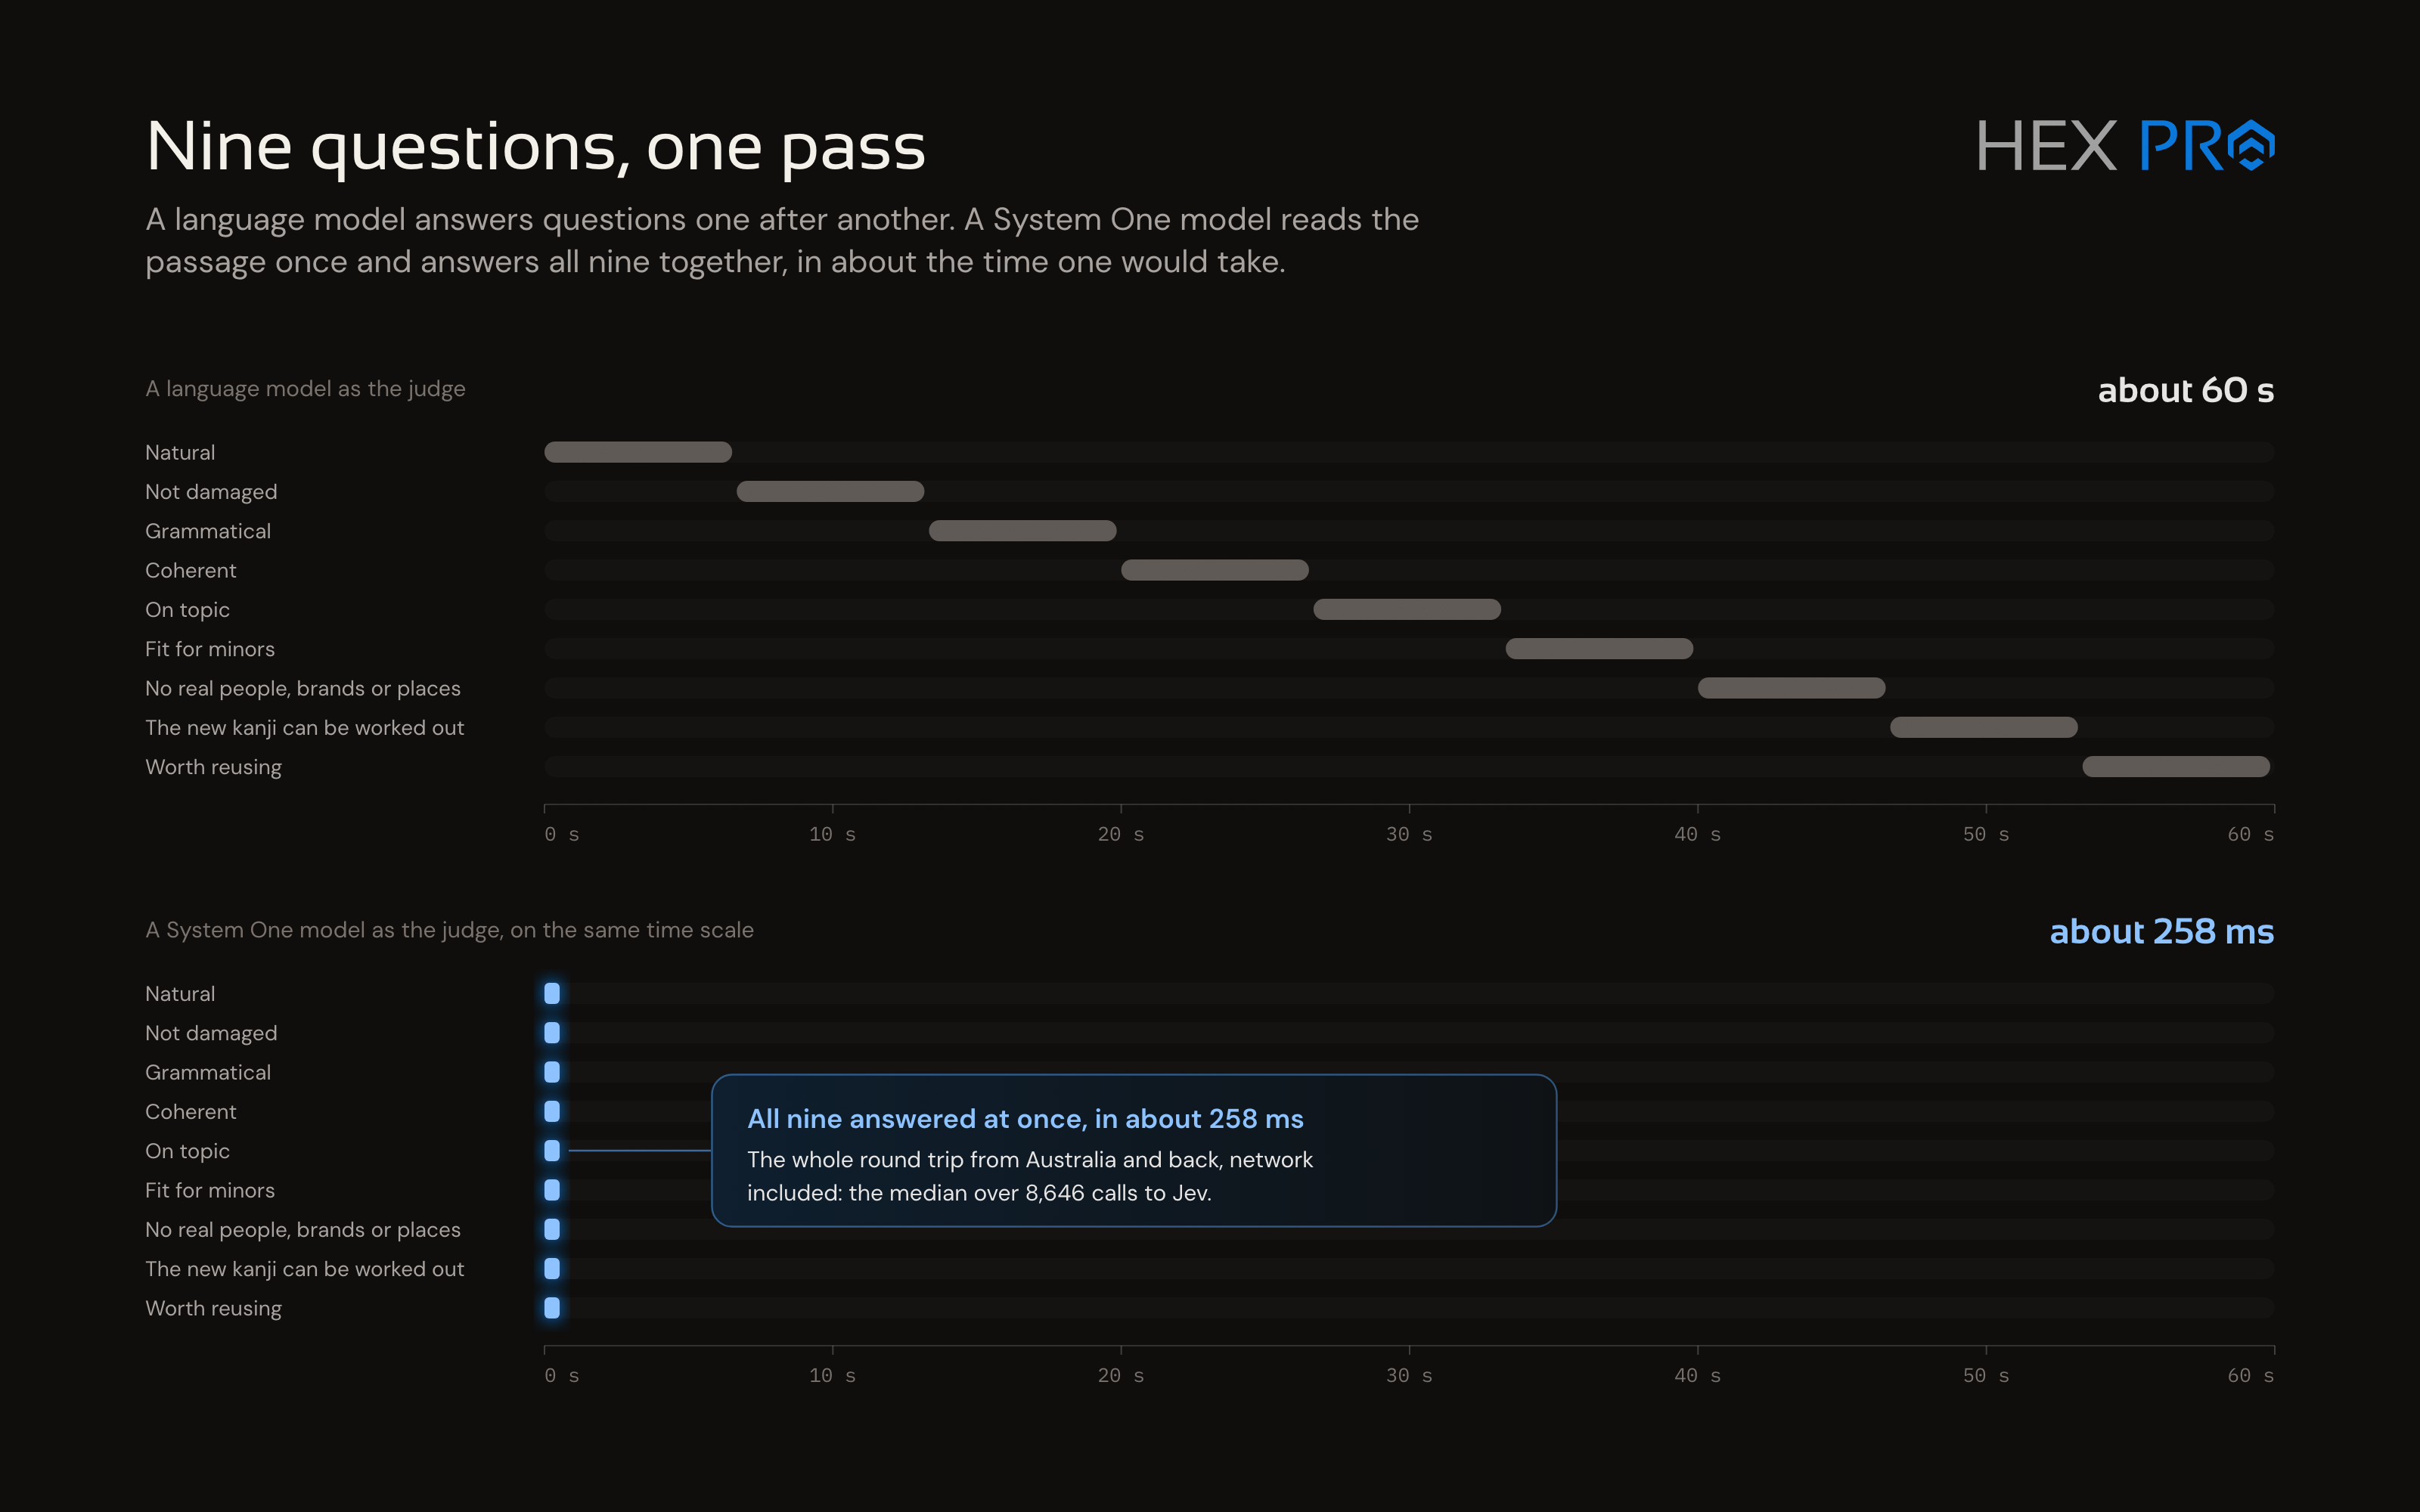
1. Responden a una velocidad de vértigo. Yo estoy en Australia y Jev funciona desde Silicon Valley, y aun así una llamada tarda unos 258 ms en volver, ping incluido. Es una ventaja enorme frente a un LLM tradicional.
2. Responden a muchas preguntas en paralelo. A diferencia de un LLM, que tiene que procesar cada pregunta en orden secuencial, los modelos System One pueden recibir un montón de preguntas y responderlas en más o menos el mismo tiempo que una sola. Es decir, si con un LLM se tardaban **60 segundos** en responder bien nueve preguntas, con un modelo System One solo se tardan **258 ms** en responder esas mismas nueve. Cuantas más preguntas necesites hacer, más partido le sacas a una herramienta como Jev.
 3. Son baratísimos. Durante este proyecto, solo gasté **0,025 USD** en Jev por cada 1000 llamadas. Una de las lecciones es que Jev es **increíblemente económico** de usar. No me sentiría nada incómodo integrándolo en todas partes; es prácticamente gratis.
Otra ventaja de la que se habla poco es la fiabilidad. Algunos LLM se descontrolan y dan respuestas sin estructura que no se pueden procesar mediante código. Jev es 'typesafe' (con seguridad de tipos) en el sentido de que siempre da una respuesta válida que se puede interpretar.
## Laya: el competidor de código abierto
Lo que me lleva a Laya, el objeto de este experimento y probablemente la razón por la que estás leyendo este artículo. A los pocos días del lanzamiento público de Jev, apareció un aluvión de intentos de código abierto de recrear la tecnología.
> https://github.com/NandhaKishorM/laya
Con nada menos que 35.000 estrellas en GitHub en el momento de escribir esto, Laya irrumpió en escena con fuerza, con más de 1000 commits en un par de semanas y cerca de 3000 a día de hoy. Un lanzamiento bastante impresionante, que demostró cuánto interés tiene la comunidad de ingeniería de software en los modelos System One.
Laya venía con tres modelos base: `laya (421M)`, `laya-multilingual (322M)` y `laya-typed-decisions (421M)`. En resumen, `laya` es el modelo todoterreno, `laya-multilingual` funciona mejor con idiomas distintos del inglés pero es menos preciso, y `laya-typed-decisions` tiene más precisión a costa de menos flexibilidad según la situación y una capacidad multilingüe pobre.
### Ventajas de Laya
La ventaja más evidente de Laya es que es de código abierto y tú controlas la infraestructura. No hay que preocuparse de que Laya quiebre de repente y apague sus servidores, lo que te obligaría a buscar a toda prisa un sustituto adecuado o a ver cómo tu software sufre un fallo catastrófico. Es un incentivo atractivo para empresas como la mía, que aspiran a crecer mucho y quieren minimizar el riesgo.
La otra ventaja de Laya es el pequeño tamaño del modelo. Por defecto necesita muy poca VRAM para funcionar, e incluso puede ejecutarse en CPU, según el [enorme README.md generado con IA](https://github.com/NandhaKishorM/laya/blob/main/README.md). Creo que en mis experimentos el modelo base funcionaba con 2 GB de VRAM, así que cabía sin problemas en la infraestructura de mi servidor.
### Las desventajas no tan evidentes
Cuando algo parece demasiado bueno para ser verdad, normalmente lo es. Las estadísticas y comparaciones con Jev que aparecen en la [página de GitHub](https://github.com/NandhaKishorM/laya/blob/efbe194/BENCHMARKS.md) afirman cosas como estas:
| | Laya | Jev (publicado) |
|---|---|---|
| typed-decisions (2,000 decisiones) | **0.766** | 0.727 |
| AG News (4 etiquetas) | **0.953** | 0.910 |
| DAIR Emotion (6 etiquetas) | **0.600** | 0.480 |
| ECE tras el ajuste de temperatura | **0.081** | 0.246 |
| Latencia p50, 1 pregunta (T4) | **32.8 ms** | 236-276 ms |
A mí me parece bastante convincente. Entonces, ¿dónde está la trampa? Fíjate en los temas con los que se pusieron a prueba los modelos de Laya.
| tema | laya | laya-multilingual | laya-typed-decisions | datos |
|---|---|---|---|---|
| Spam de correo electrónico | **0.993** | 0.993 | 0.958 | en el entrenamiento |
| Phishing | 0.980 | **0.993** | 0.940 | en el entrenamiento |
| Barreras de protección de LLM (jailbreak) | 0.708 | 0.755 | **0.762** | **fuera del entrenamiento** |
| Moderación (toxicidad) | **0.530** | 0.525 | 0.530 | **fuera del entrenamiento** |
| Relevancia de pasajes en RAG | 0.625 | **0.657** | 0.625 | en el entrenamiento |
| Triaje de soporte (cola de 10 vías) | 0.502 | **0.522** | 0.505 | en el entrenamiento |
| Enrutamiento de modelos (dominio) | 0.639 | 0.123 | **0.659** | fuera del entrenamiento |
'Spam de correo electrónico', 'phishing', 'relevancia de pasajes en RAG' y 'triaje de soporte'. Son temas muy específicos y muy relevantes para las desventajas. Verás que 'barreras de protección de LLM', 'moderación' y 'enrutamiento de modelos' están marcados como "fuera del entrenamiento", y es una distinción importante.
Dicho de forma sencilla, Laya no es un modelo one-shot. _No_ puedes tomarlo tal cual y meterlo en cualquier caso de uso. Tal como viene, tiene capacidades muy específicas y es prácticamente inútil para todo lo demás. Ahí es donde Jev demuestra por primera vez lo que vale de verdad: 'simplemente funciona'. Mis primeras pruebas con Infinilang y el modelo `laya-multilingual` fueron un fracaso absoluto: no fue capaz de realizar **ninguna** de las tareas necesarias con un nivel suficiente.
## Entrenar un modelo personalizado para Laya: infini-jp-v1
Tras el fracaso inicial, no me rendí enseguida. Como a kcalc.ai y a Infinilang todavía les falta un tiempo para llegar a producción, tengo una infraestructura de servidores bastante seria prácticamente sin usar. Eso significa que Qwen 3.8 27B está ahí esperando a que le dé trabajo, y puedo apagarlo para entrenar siempre que necesite una GPU potente. Era hora de hacer algunos experimentos.
### Las reglas básicas
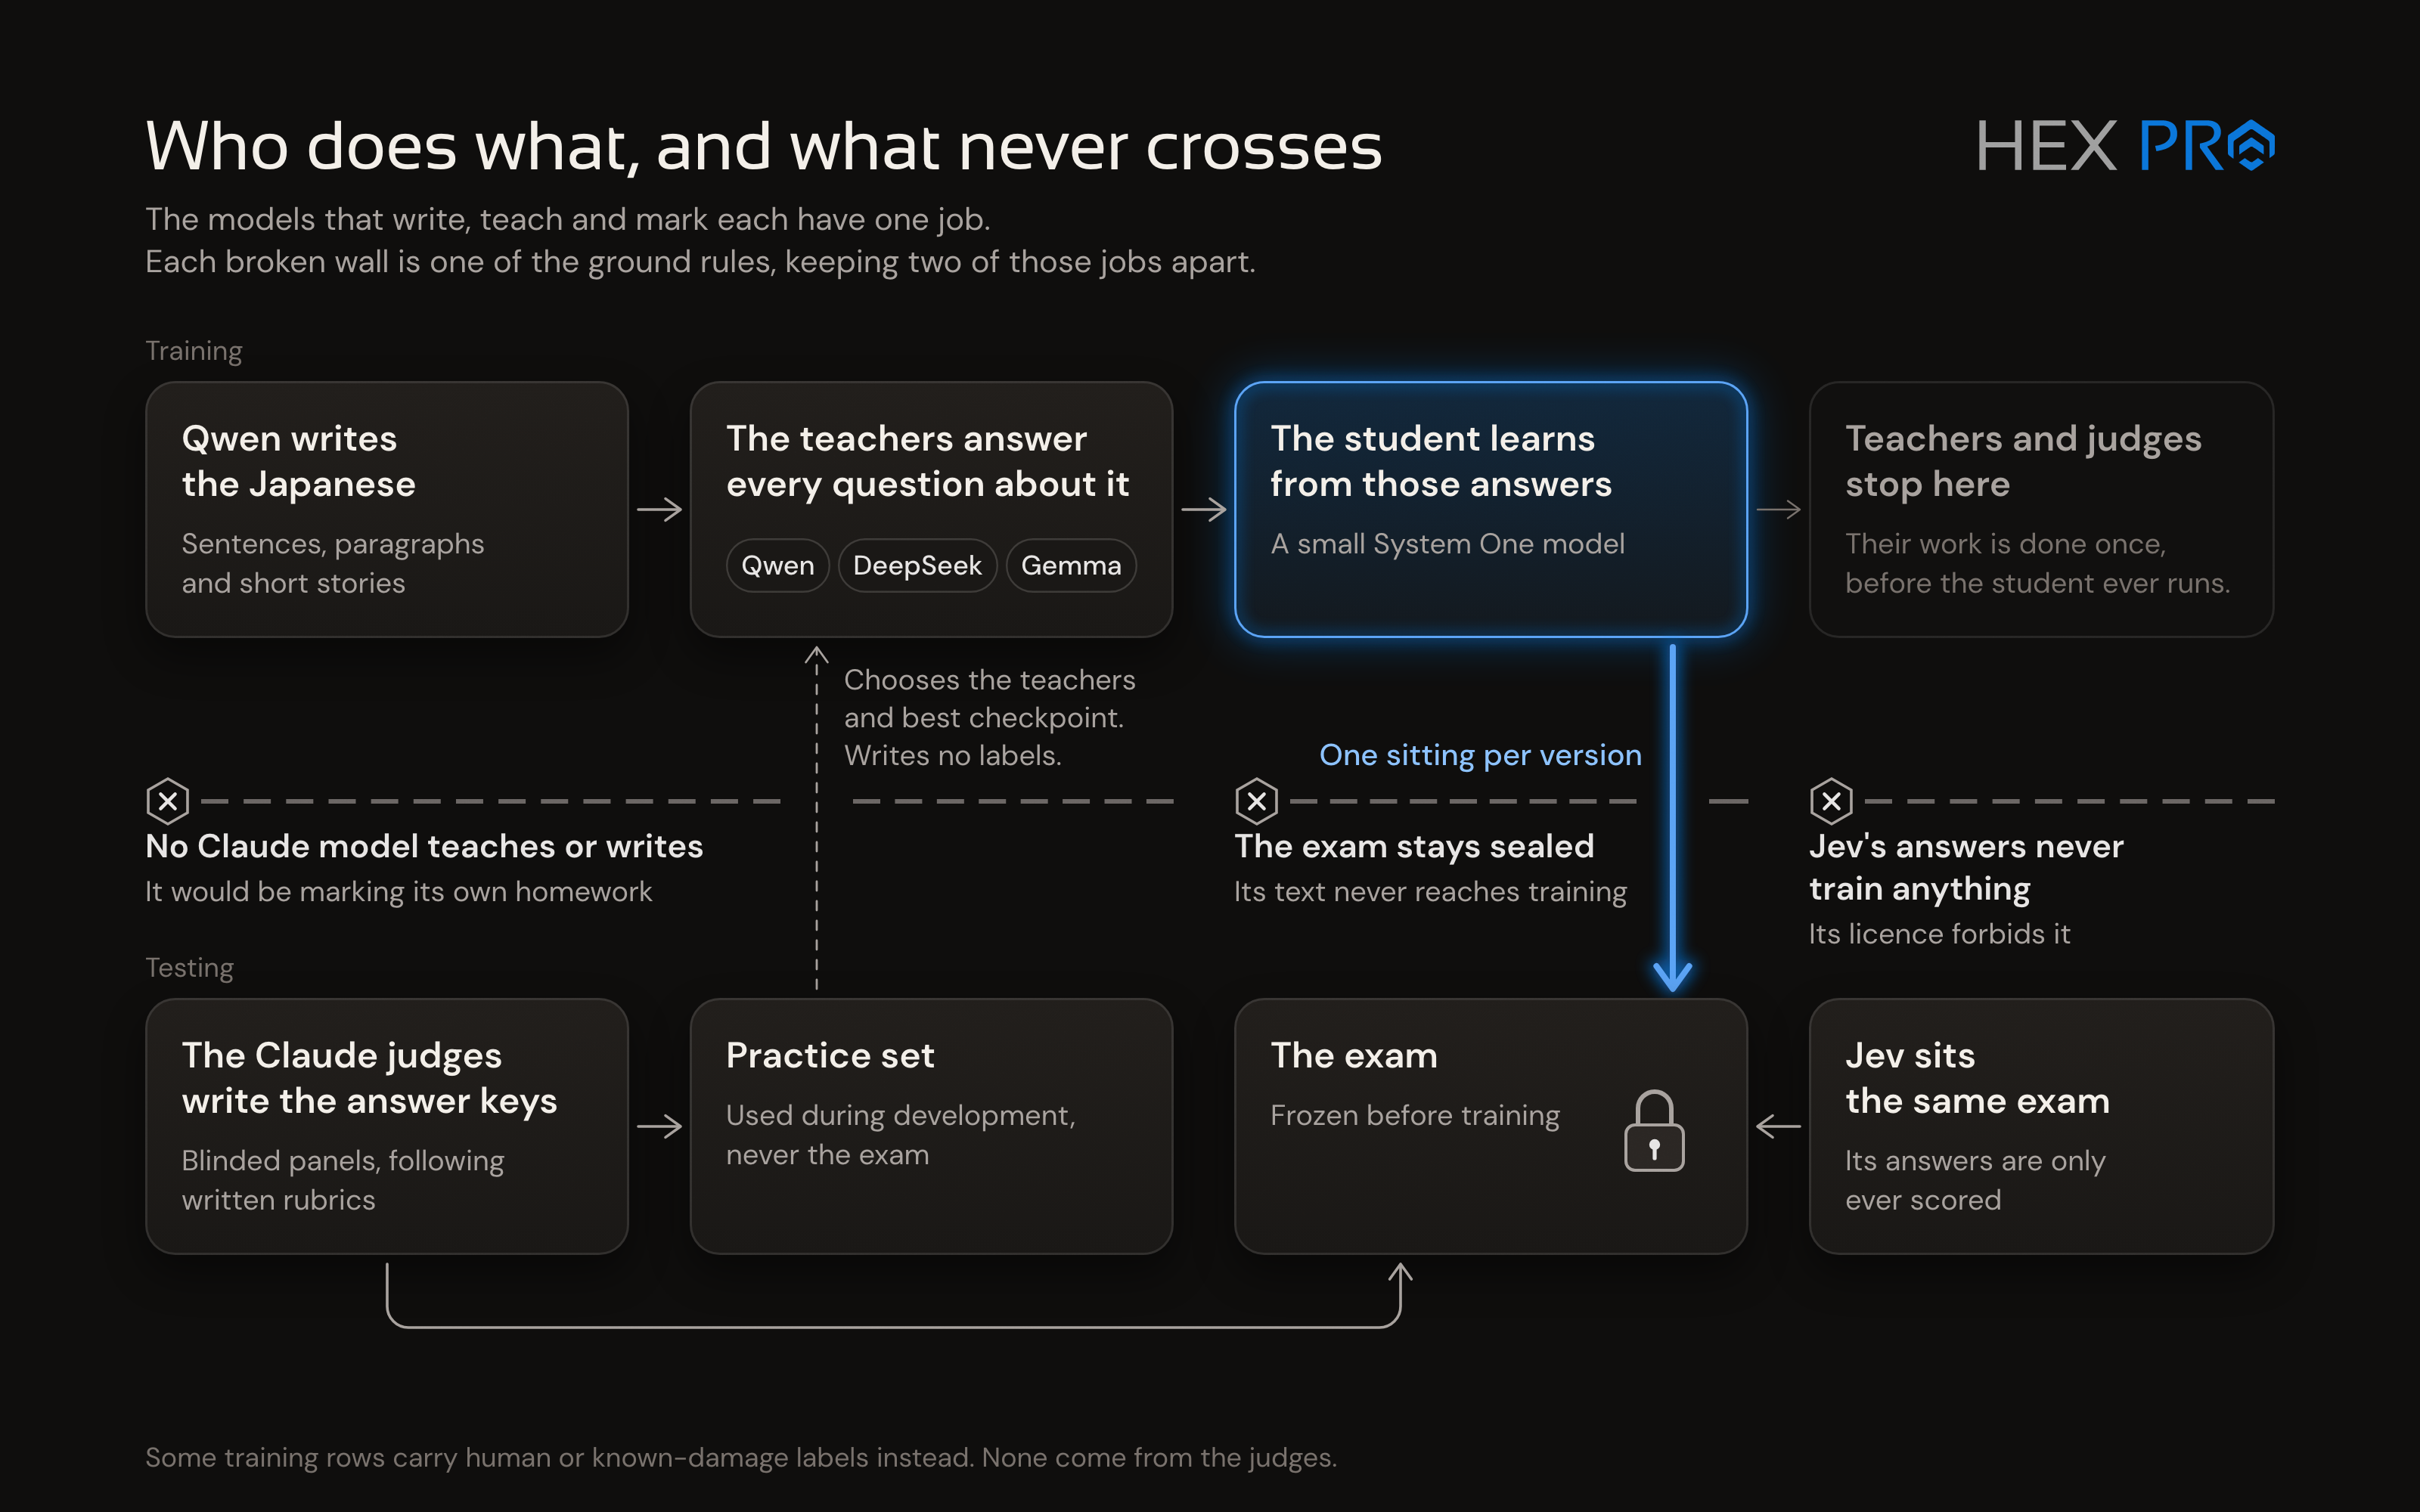 | Regla | Por qué | Cómo se cumplió |
| --- | --- | --- |
| La salida de Jev nunca entrena nada | La licencia de TypeSafe prohíbe la destilación | Contratos de importación, un hook de auditoría que rechaza cualquier lector de `quarantine/` salvo el módulo de informes, y un enum de origen de etiquetas sin ningún miembro Jev |
| Ni profesor ni generador Claude | El patrón oro es un panel de Claude; un profesor Claude estaría corrigiendo su propio examen | Un control de independencia por familia, linaje declarado, id del modelo y host. Anthropic prohíbe usar sus modelos para entrenar, así que usamos modelos de pesos abiertos para el entrenamiento. |
| El benchmark se gasta con cuidado | Cada vistazo al patrón oro de prueba lo debilita | Un intento por versión y por benchmark, un token del propietario de un solo uso por intento, un registro de accesos encadenado por hash, y ninguna cifra del benchmark decide nada |
Lo cierto es que entrenar modelos de IA plantea obstáculos legales serios. Como entidad jurídica, Hex Pro tiene que cumplir estas leyes al pie de la letra. Así que me esforcé mucho por asegurarme de cumplir todos los requisitos de las licencias.
### Experimento 1: Qwen 3.8 como profesor
El primer experimento era relativamente sencillo. El objetivo era averiguar si un modelo entrenado podía alcanzar un listón fijado de antemano.
1. Qwen 3.8 generó 1995 ejemplos en japonés de la misma forma que lo requeriría el prototipo de Infinilang.
2. Claude Opus evaluó cada resultado con paneles de 3 para seis familias, y eso nos dio nuestro 'patrón oro' con el que medir.
3. Qwen 3.8, como profesor, etiquetó los datos de entrenamiento con sus propias evaluaciones de esas mismas seis familias.
Las seis familias del experimento inicial eran:
- **S1**: Grado de naturalidad de una oración - **Puntuación sobre 5** (Métrica: [Spearman](https://en.wikipedia.org/wiki/Spearman%27s_rank_correlation_coefficient))
- **S2**: La oración parece filtrada o dañada - **Sí o no** (Métrica: [pAUROC](https://en.wikipedia.org/wiki/Partial_Area_Under_the_ROC_Curve))
- **S3**: El inglés es una traducción fiel - **Sí o no** (Métrica: pAUROC)
- **P1**: La mejor de tres reparaciones candidatas, o ninguna - **Elección entre 4** (Métrica: concordancia con el patrón oro)
- **P2**: ¿Alguna de las reparaciones candidatas es aceptable? - **Sí o no** (Métrica: pAUROC)
- **G1**: La oración es gramatical - **Sí o no** (Métrica: pAUROC)
El resultado fue decepcionante. Lo que más llamaba la atención era S1 (naturalidad), que tenía que alcanzar un listón de [Spearman](https://en.wikipedia.org/wiki/Spearman%27s_rank_correlation_coefficient) de 0,60, pero se quedó en 0,452. Mi primer impulso fue descartar ahí mismo la idea de entrenar con Laya. Para entonces le había dedicado alrededor de un día y medio, y esos resultados simplemente no eran lo bastante buenos.
Ahí cancelé el experimento: no valía la pena. Jev es tan barato de usar que entrenar un modelo costaría órdenes de magnitud más que Jev en 5 años de uso intensivo. Más tarde ese mismo día, por capricho, decidí probar Jev en el mismo experimento y encontré algo _muy_ interesante.
| Familia | Profesor | Jev | Comparación | Calibración (confianza) |
|--------|--------:|----:|-----------:|------------------------:|
| S1 (Spearman) | 0.452 | 0.446 | +0.006 | Jev 20.4% mejor |
| S2 (AUROC) | 0.920 | 0.900 | +0.02 | Jev 64.9% mejor |
| S3 (AUROC) | 0.972 | 0.983 | -0.011 | Profesor 36% mejor |
| P1 (concordancia) | 0.874 | 0.75 | **+0.124** | Jev 14.5% mejor |
| P2 (AUROC) | 0.878 | 0.849 | +0.029 | Jev 75.7% mejor |
| G1 (AUROC) | 0.782 | 0.766 | +0.016 | Jev 72.5% mejor |
**_¡GUAU!_** A ver, a ver. ¿Qué números son estos? El profesor estaba a la altura de Jev en todas las métricas, e incluso le ganaba con claridad al elegir entre reparaciones candidatas de oraciones. Pero la cifra que más me convenció fue el 0,446 de S1. _Jev tampoco alcanzaba el listón de 0,6._
Esos resultados le dieron nueva vida al proyecto, y enseguida me propuse construir a partir de ellos. Con un primer intento sin muchas pretensiones, ya había igualado a Jev en esas tareas de Infinilang. Hubo un aspecto en el que Jev resultó imbatible en todo momento: la _calibración_. Aunque los resultados en sí eran sólidos con Laya, la puntuación de 'confianza' que da Jev es muchísimo mejor en todos los sentidos. La puntuación de Jev es multidimensional, y _sabe_ cuándo está seguro de algo y cuándo no. Para un modelo one-shot que se puede meter en cualquier tarea, eso es muy importante. Para un modelo pensado para un conjunto de tareas muy concreto, esa cifra de calibración es menos necesaria.
### Experimento 2: comparativa y refinamiento
Llegados a este punto, el experimento 1 quedó cerrado y los benchmarks, congelados. Iba a haber que gastar dinero, y la cosa se iba a poner seria. Ahora el objetivo era conseguir una mejora sustancial respecto a las capacidades de Jev para Infinilang. Veía tres formas de mejorar las puntuaciones del experimento 1.
1. Más datos de entrenamiento
2. Mejores modelos LLM
3. Una rúbrica más diversa
En ese momento se decidió generar los benchmarks de Jev solo _después_ de haber reunido todos los resultados. En cuanto abriera el benchmark de Jev, tendría que pasar a un nuevo conjunto de datos para mantener a Jev en cuarentena.
El primer paso fue evaluar profesores alternativos. Buscaba modelos que fueran mucho más grandes o que pudieran rendir mejor con las restricciones del japonés de Infinilang. Los candidatos fueron:
- DeepSeek V4.1 - Modelo de razonamiento enorme y capaz, con una inferencia razonablemente barata. Buenas puntuaciones en japonés.
- Gemma 4 31B - Probado para el prototipo de Infinilang, destacó por evitar las fugas de kanji. Además, es lo bastante pequeño para ejecutarse en la infraestructura de mi servidor, así que probarlo sale prácticamente gratis.
- Qwen 3.8 Flash Next - Básicamente, un adelanto de Qwen 4. Es un modelo de mezcla de expertos ([MOE](https://en.wikipedia.org/wiki/Mixture_of_experts)), lo que lo hace mucho más grande y con más conocimientos que Qwen 3.8 27B.
- Hy3 e Inkling-Small - Dos modelos menos conocidos que pensé que _quizá_ tuvieran buenas capacidades en japonés.
Otros modelos se descartaron, normalmente porque su licencia no permite usarlos para entrenar.
#### La comparativa
Qwen 3.8 Flash Next fue el primero en caer. El gran problema era el riesgo de autopreferencia, ya que pertenece a la misma familia que el generador (Qwen 3.8 27B). Vale la pena echar un vistazo a [_Extreme Self-Preference in Language Models_](https://arxiv.org/html/2509.26464v2) (Steven A. Lehr, Mary Cipperman y Mahzarin R. Banaji, 2026), un estudio que demostró que los LLM adoran lo que generan ellos mismos y tienden a ser críticos con lo que generan los demás.
> _"La autopreferencia es un rasgo fundamental de los organismos biológicos. Dado que los grandes modelos de lenguaje (LLM) no son sintientes, cabría esperar que evitaran tales distorsiones. Sin embargo, a lo largo de 72 experimentos y ~41.000 consultas, descubrimos autopreferencias masivas en ocho LLM de uso generalizado."_
El riesgo de que la autopreferencia afectara a los resultados era demasiado alto, y de todos modos las pruebas mostraron que sus resultados coincidían mucho con los de Qwen 3.8 27B. No tenía sentido invertir dinero de verdad en un modelo que suponía ese tipo de riesgo cuando podía usar gratis la versión 27B y obtener un resultado parecido.
Los siguientes en quedar fuera fueron Hy3 e Inkling-Small. Poco que decir aquí. Eran caros y no lograron mejores resultados que ningún otro modelo.
DeepSeek V4.1 fue, con diferencia, el que más destacó en todos los frentes. Los resultados superaron con creces lo que esperaba. Siempre me había dado la impresión de que DeepSeek no era más que un modelo chino de baja calidad, una imitación que se lo había robado todo a OpenAI y a Anthropic. Aunque esto último probablemente sea cierto, ya no es de baja calidad. Era claramente el mejor modelo de pesos abiertos que además permitía entrenar con sus datos. Dios bendiga a los chinos.
Gemma 4 era el último modelo. En la mayoría de las familias, DeepSeek arrasó. Gemma 4 estuvo a la altura de DeepSeek en casi todo y destacó especialmente en S3 (traducción fiel). También rindió bien en P2 (alguna reparación aceptable) y B2 (ajustado al tema). Como probarlo era gratis, decidí que valía la pena seguir con él.
Así que todas las pruebas posteriores se harían con Qwen 3.8 27B, Gemma 4 31B y DeepSeek V4.1.
#### Mejorar la rúbrica
El experimento inicial tenía un conjunto limitado de familias, pero hay muchas más formas de usar este modelo dentro de Infinilang, y quería asegurarme de que se entrenara en todas las tareas que tendría que cumplir.
La nueva rúbrica constaba de 14 familias. Se pulió y se precisó la redacción de las 6 ya mencionadas (S1, S2, S3, P1, P2, G1), y se añadieron estas nuevas:
- **B1**: El texto es coherente - **Sí o no** (Métrica: [pAUROC](https://en.wikipedia.org/wiki/Partial_Area_Under_the_ROC_Curve))
- **B2**: El texto se ajusta al tema - **Sí o no** (Métrica: pAUROC)
- **B3**: El texto es apropiado para menores - **Sí o no** (Métrica: pAUROC)
- **B4**: No hay marcas ni lugares reales - **Sí o no** (Métrica: pAUROC)
- **B5**: La palabra N+1 (kanji nuevo) se puede deducir por el contexto - **Sí o no** (Métrica: pAUROC)
- **B6**: Vale la pena reutilizar el texto - **Puntuación sobre 5** (Métrica: [Harrell's C](https://statisticaloddsandends.wordpress.com/2019/10/26/what-is-harrells-c-index/))
- **B7**: El japonés del texto es natural - **Puntuación sobre 5** (Métrica: Harrell's C)
- **PS2**: El japonés del texto parece dañado - **Sí o no** (Métrica: pAUROC)
Esta vez, los datos de entrenamiento no se limitarían a una línea de japonés (1 o 2 oraciones). Serían una mezcla de oraciones, párrafos y relatos cortos. La rúbrica se amplió para cubrir esta necesidad. También verás que había otras funciones que me interesaban, como guardar textos en caché para reutilizarlos con otros usuarios e identificar el contenido apto para menores de cara a las restricciones de edad.
#### Generar los datos de entrenamiento
Mi GPU se pasó 10 horas zumbando sin parar, generando nuevos temas y material de entrenamiento con Qwen 3.8 27B. Opté por seguir generando los datos de entrenamiento con Qwen, porque, de todos modos, es el modelo que se usaría en las generaciones de Infinilang de aquí en adelante. Usar un modelo más potente en este paso sería contraproducente.
Acabé con 215.000 filas, cada una con los juicios del panel patrón oro de Claude. Jev también iba a recibir la rúbrica ampliada y mejorada, lo que mejoró notablemente sus resultados frente al benchmark del experimento 1.
#### Resultados de la comparativa
Ten en cuenta que los resultados siguientes usan las nuevas reglas desarrolladas con la rúbrica mejorada, así que superan con creces los del experimento 1. Además, en algunas familias probé a promediar los resultados de DeepSeek + Gemma, ponderándolos según su grado de acuerdo entre sí. Otra salvedad es que, en ciertos casos y con ciertos modelos, más razonamiento llegaba a empeorar el resultado. Así que estos resultados son los mejores que pude obtener tras ajustar distintas combinaciones de razonamiento y sin razonamiento, con reglas y sin reglas, para cada modelo y familia.
| Familia | Jev | Qwen 3.8 | DeepSeek | Gemma | Media DS+G | Frente a Jev |
|--------|----:|---------:|---------:|------:|--------------:|------------:|
| B1 (coherente) | 0.897 | 0.432 | **0.921** | 0.912 | - | +0.024 |
| B2 (ajustado al tema) | 0.896 | 0.540 | **0.971** | 0.968 | - | +0.075 |
| B5 (palabra deducible) | 0.627 | 0.580 | **0.840** | 0.754 | 0.809 | +0.213 |
| B6 (vale la pena reutilizarlo) | 0.786 | 0.596 | **0.819** | 0.613 | 0.740 | +0.033 |
| B7 (texto natural) | 0.826 | 0.317 | 0.617 | 0.672 | **0.681** | -0.145 |
| PS2 (texto dañado) | 0.635 | 0.537 | **0.943** | 0.937 | - | +0.308 |
| S1 (oración natural) | 0.721 | 0.740 | 0.753 | 0.774 | **0.784** | +0.063 |
| S2 (oración dañada) | 0.760 | 0.926 | **0.956** | 0.953 | - | +0.196 |
| S3 (traducción fiel) | 0.701 | 0.765 | 0.966 | **0.987** | - | +0.286 |
| G1 (gramatical) | 0.764 | **0.966** | 0.960 (K8) | 0.960 | - | +0.202 |
| P1 (mejor reparación) | 0.671 | 0.801 | 0.851 | 0.857 | **0.864** | +0.193 |
| P2 (alguna aceptable) | 0.653 | 0.759 | 0.855 | **0.872** | 0.872 | +0.219 |
| B3 (apto para menores) | 0.984 | 0.948 | **1.000** | 0.994 | - | +0.016 |
| B4 (sin nombres reales) | 0.962 | **0.994** | 0.974 | 0.991 | - | +0.032 |
*K8: ocho respuestas cortas muestreadas con el razonamiento desactivado, en forma de histograma suavizado
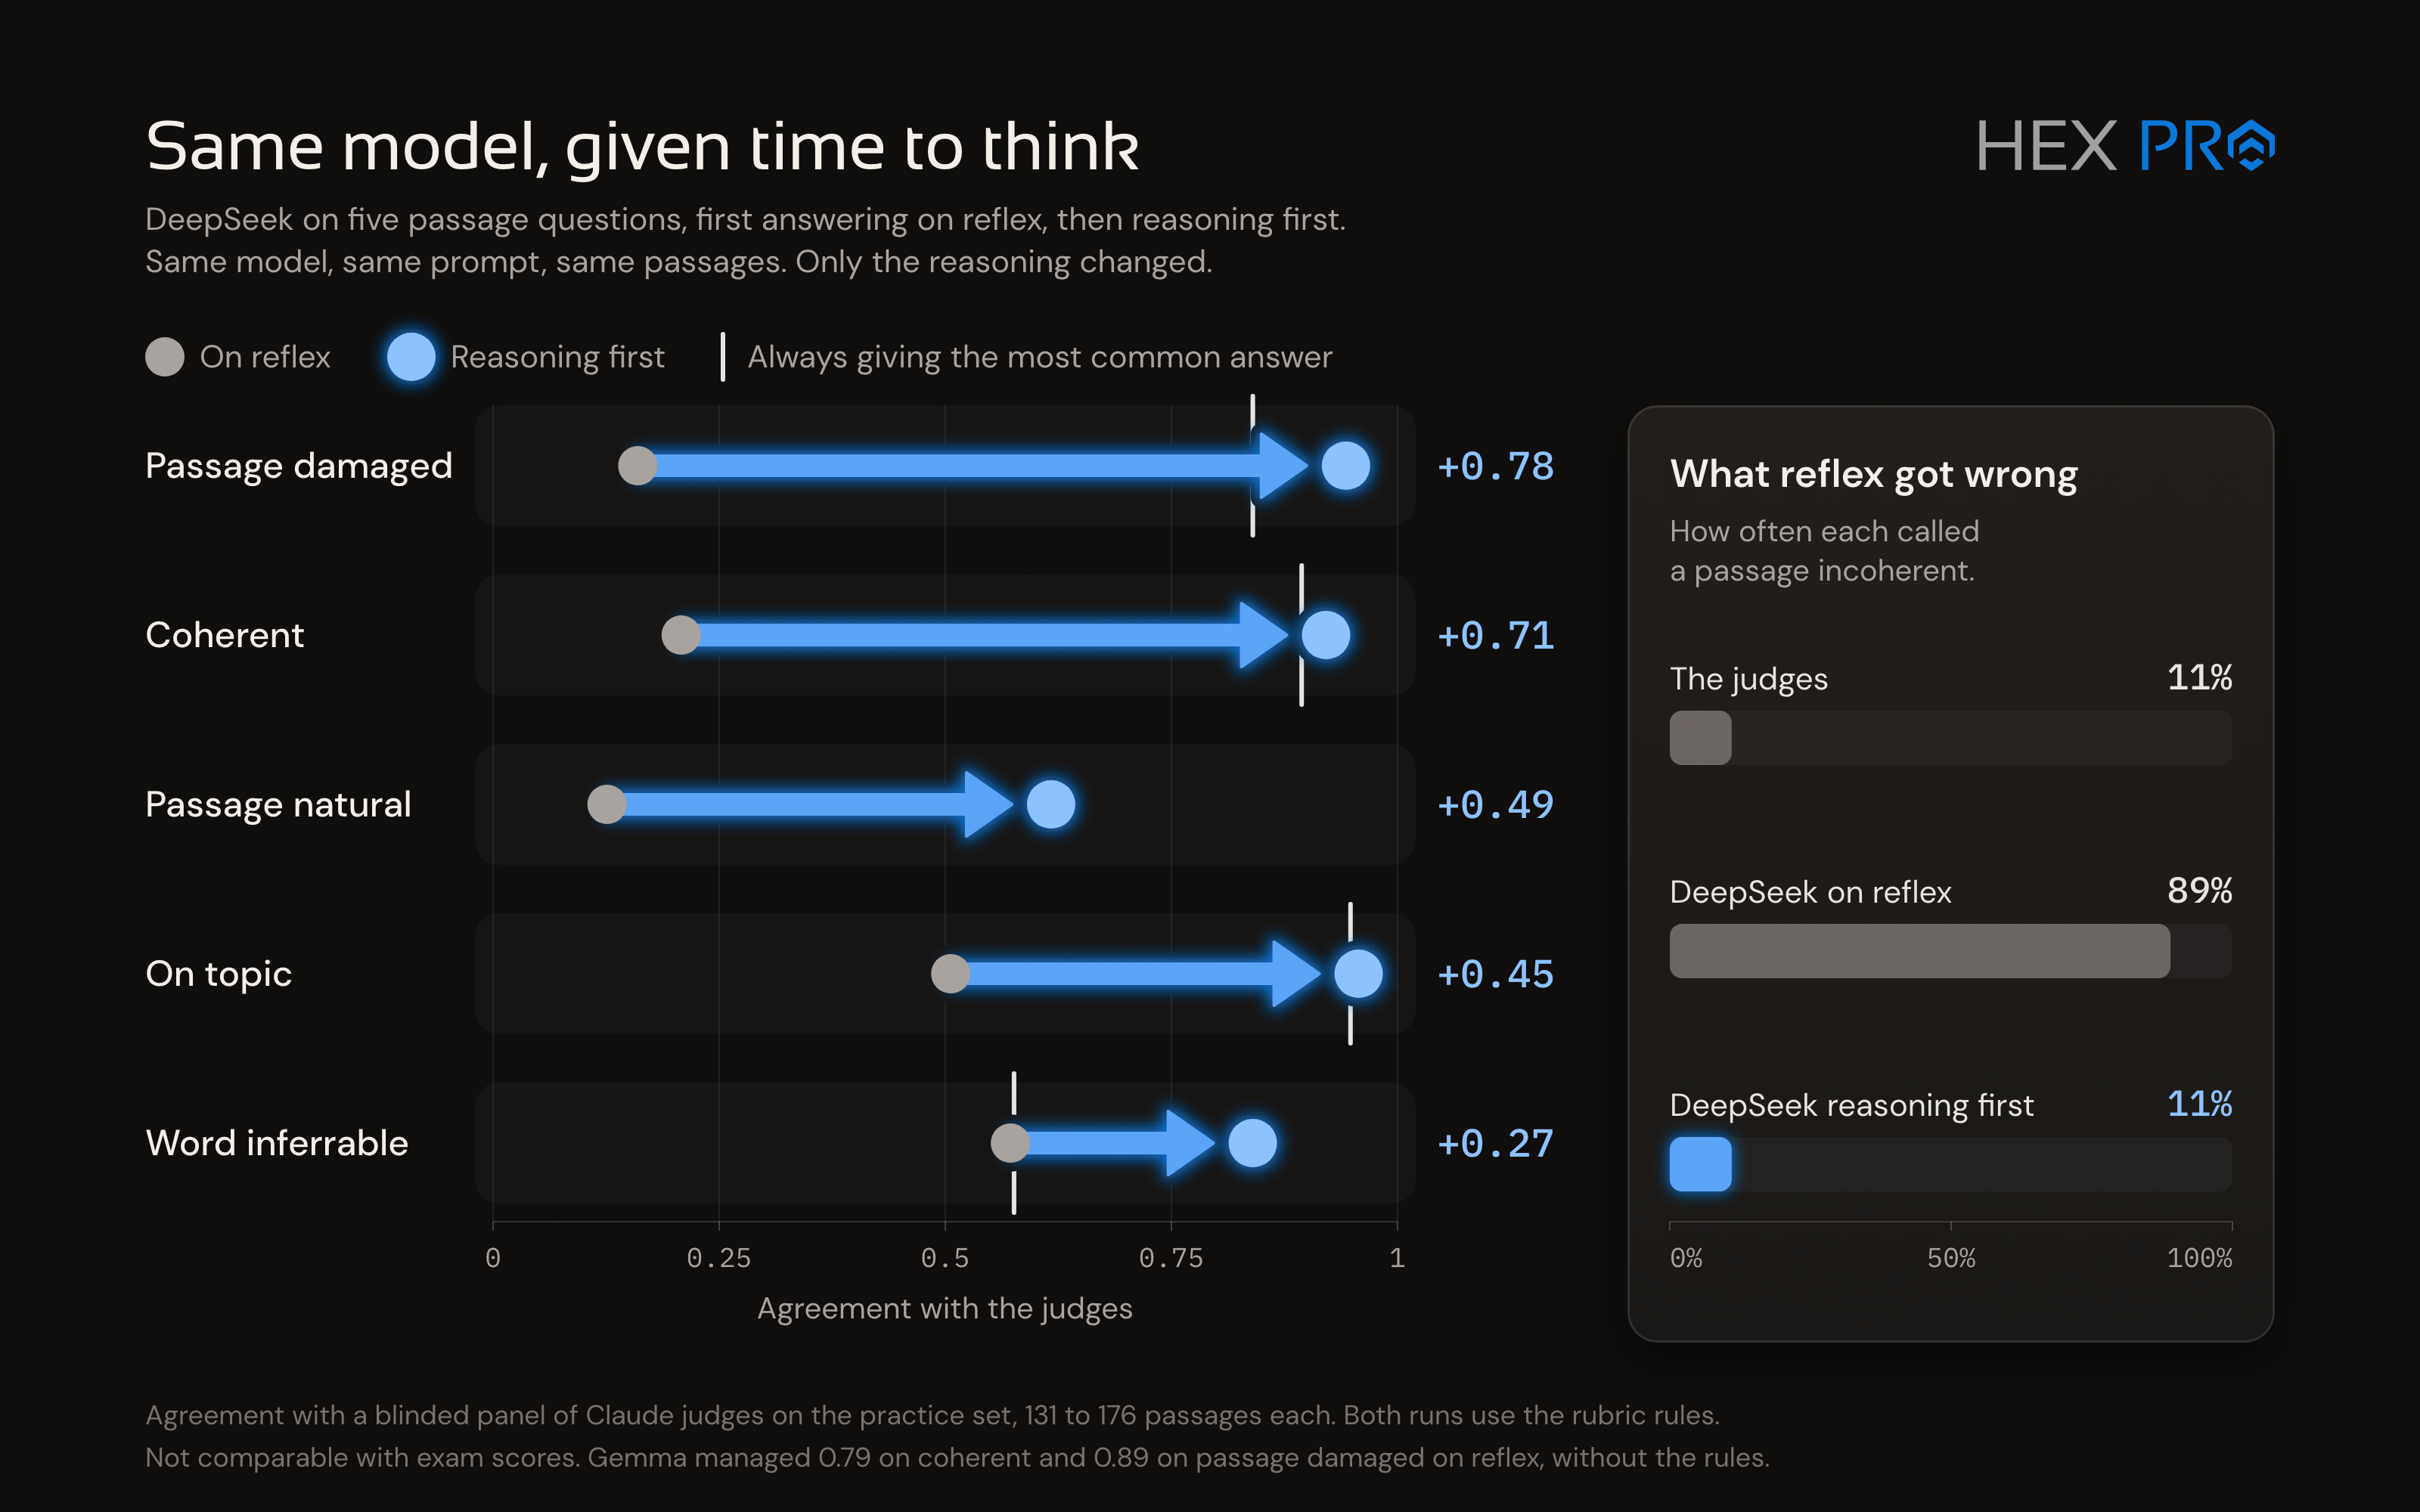 Estas cifras me dieron una idea bastante clara de con qué contaba. Como ya he dicho, también probé Jev con estos nuevos criterios y descubrí que esta vez rendía mucho mejor. Jev destacó con los textos más largos, algo que conviene tener en cuenta en el contexto de Laya, que no tiene una ventana de contexto tan larga y maneja peor los textos largos.
### Experimento 3: los candidatos para producción
Ahora que tenía decididos los profesores de cada familia, había llegado el momento de entrenar de verdad el modelo System One. Recuerda que el experimento 2 servía para determinar qué profesor sería el mejor para cada familia. Eso no significa necesariamente que el modelo alumno vaya a rendir tan bien como el profesor: inevitablemente habrá que hacer concesiones cuando todas estas tareas se combinen en un único modelo. Quien esté pensando en usar Laya debería plantearse cuántas tareas necesita que realice un solo modelo. Por ejemplo, si entrenara un modelo distinto para cada familia, lo optimizara al máximo y luego colocara los 14 modelos en puntos estratégicos de mi programa, obtendría los mejores resultados en todo. Pero entonces el problema es que necesitas ejecutar 14 modelos distintos, lo que supone asignar bastantes más recursos de GPU. Así que es una cuestión de escala. Si eres una megacorporación con miles de millones que gastar en servidores caros, ni te lo pienses. Uno solo de estos modelos puede atender a un número astronómico de usuarios con una asignación de recursos mínima. Para todos los demás, probablemente no sea el mejor uso de tu valiosa capacidad de cómputo de GPU.
Había llegado la hora de ponerse serio. La GPU volvió a ponerse en marcha, y esta vez se dedicaron 35 horas a generar y etiquetar más datos de entrenamiento. Después, los paneles patrón oro de Claude volvieron a ejecutarse sobre los datos nuevos, lo que consumió más de 200 millones de tokens con un plan Ultra (antes Max 20x).
DeepSeek fue el caro: como no se podía ejecutar en local, necesitaba inferencia en la nube. Se eligió para 9 familias, costó 233,56 AUD y tardó 18 horas en terminar. En USD todo parece muy inocente, pero en AUD los movimientos del banco se ven muchísimo peor. La inferencia de Gemma 4 se ejecutó en nuestra propia infraestructura, así que salió gratis y tardó unas 60 horas en etiquetar las pocas familias que tenía asignadas.
#### Los cuatro alumnos
Al final, entrené cuatro candidatos con distintos ajustes y planteamientos: `prod-q38`, `prod-ds41`, `prod-mix1` y `prod-mix2`. Cada alumno se entrenó con tres brazos y dos semillas por brazo, para asegurarnos de que un valor atípico no nos jugara una mala pasada. Los finalistas se entrenaron con tres semillas más.
- Brazo A: `laya-multilingual` (mmBERT) con su cabeza preentrenada.
- Brazo B: `modernbert-ja-310m` con una cabeza nueva.
- Brazo E: `sokudan-ja-310m` trasplantado a la arquitectura del brazo B.
También hubo un brazo D, una prueba de latencia con 130 millones de parámetros, que se quedó atrás en rendimiento.
##### prod-q38: Qwen 3.8
El primero y el más barato de entrenar. Usaba solo Qwen, en distintas configuraciones (con o sin razonamiento, con o sin reglas) según lo que puntuara mejor. Sabía que no rendiría tan bien como los demás, pero era la continuación del experimento 1 y daba una referencia de cuánto podían mejorar los otros modelos.
##### prod-ds41: DeepSeek y Qwen
DeepSeek fue claramente el que mejor rindió en el experimento anterior, pero Qwen tenía ventaja o se quedaba bastante cerca de DeepSeek en algunas familias. Donde igualaba o superaba a DeepSeek, usé Qwen para ahorrar algo de dinero.
##### prod-mix1: DeepSeek, Gemma y Qwen
Este tomaba lo mejor de cada familia e intentaba crear el combo definitivo. También probaba a sustituir Qwen por DeepSeek en los puntos donde el alumno `prod-ds41` parecía rendir peor de lo esperado.
##### prod-mix2: DeepSeek, Gemma y Qwen (remix)
Un planteamiento parecido al de `prod-mix1`, pero P1 y B3 se revirtieron para que coincidieran con `prod-ds41`, a ver si eso ayudaba a mejorar los resultados.
#### A propósito de los brazos
Entrenar con distintos brazos fue una decisión acertada, porque reveló datos muy importantes. Todos los brazos entrenados a partir de `laya-multilingual` (brazo A) fueron inferiores al brazo B y al brazo E. Fue un hallazgo importante, porque demostró que la versión multilingüe, al menos en mi caso, en el que solo necesitaba japonés, era una basura.
Recomiendo encarecidamente a cualquiera que intente entrenar un modelo System One que descarte los modelos de Laya tal como vienen y entrene a partir de ModernBERT con una cabeza limpia. O que, al menos, haga la prueba con varios brazos como hicimos nosotros, para que un checkpoint inferior no lo tome por sorpresa.
#### Los alumnos se enfrentan al examen
Estas son las cifras finales de cada alumno frente a las cifras finales de Jev, con la rúbrica mejorada y sobre los nuevos datos de entrenamiento.
| Familia | Jev | prod-q38 | prod-ds41 | prod-mix1 | prod-mix2 |
|---|---:|---:|---:|---:|---:|
| S1 | **0.721** | 0.604 | 0.641 | 0.620 | 0.639 |
| S2 | 0.760 | 0.879 | 0.889 | **0.890** | 0.884 |
| S3 | **0.701** | 0.552 | 0.631 | 0.574 | 0.521 |
| P1 | 0.671 | 0.833 | 0.825 | **0.857** | 0.813 |
| P2 | 0.603 | 0.788 | 0.852 | **0.887** | 0.820 |
| B1 | 0.897 | 0.734 | **0.921** | 0.898 | 0.894 |
| B2 | 0.846 | 0.858 | 0.890 | 0.884 | **0.900** |
| B3 | **0.984** | 0.938 | 0.955 | 0.933 | 0.955 |
| B4 | 0.962 | 0.968 | 0.943 | 0.957 | **0.969** |
| B5 | 0.627 | 0.571 | **0.656** | 0.627 | 0.614 |
| B6 | 0.777 | 0.841 | 0.843 | **0.879** | 0.867 |
| B7 | 0.826 | 0.847 | **0.882** | 0.878 | 0.871 |
| PS2 | 0.615 | 0.705 | 0.830 | 0.838 | **0.850** |
| G1 | 0.764 | 0.804 | **0.815** | 0.814 | **0.815** |
| **Puntuación compuesta** | 0.768 | 0.780 | **0.827** | 0.824 | 0.815 |
Los resultados son fascinantes porque no siempre son intuitivos ni previsibles. Lo fundamental es entender que el entrenamiento de los valores de cada familia afecta a todas las demás en un grado pequeño, pero que se va acumulando. Por eso las cifras son tan dispares. En algunos casos, el alumno puntúa mejor que el profesor; en muchos, puntúa algo peor.
También es muy difícil decidir un ganador real, porque no todas las familias valen lo mismo. Por ejemplo, S1 (naturalidad del japonés) es una familia importante, y aquí Jev queda bastante por encima de los demás. En cambio, B7 (naturalidad del japonés en todo el _texto_) también es muy importante, y aquí Jev va por detrás de todos los demás modelos.
En la misma línea, que un modelo 'gane' muchas familias no lo hace automáticamente mejor. `prod-ds41`, `prod-mix1` y `prod-mix2` están muy cerca unos de otros en la mayoría de los casos. La diferencia entre el 0,890 de `prod-mix1` en S2 y el 0,889 de `prod-ds41` es prácticamente nula. Se ve más claro si eliminamos el ruido y mostramos solo la ventaja o desventaja frente a Jev, pero únicamente para los que ganan la familia o empatan en el primer puesto.
| Familia | Jev | prod-q38 | prod-ds41 | prod-mix1 | prod-mix2 |
|---|---:|---:|---:|---:|---:|
| S1 (oración natural) | 0.721 | -12% | -8% | -10% | -8% |
| S2 (oración dañada) | 0.760 | +12% | +13% | +13% | +12% |
| S3 (traducción fiel) | 0.701 | -15% | -7% | -13% | -18% |
| P1 (mejor reparación) | 0.671 | +16% | +15% | +19% | +14% |
| P2 (alguna aceptable) | 0.603 | +19% | +25% | +28% | +22% |
| B1 (coherente) | 0.897 | -16% | +2% | 0% | 0% |
| B2 (ajustado al tema) | 0.846 | +1% | +4% | +4% | +5% |
| B3 (apto para menores) | 0.984 | -5% | -3% | -5% | -3% |
| B4 (sin nombres reales) | 0.962 | +1% | -2% | -1% | +1% |
| B5 (palabra deducible) | 0.627 | -6% | +3% | 0% | -1% |
| B6 (vale la pena reutilizarlo) | 0.777 | +6% | +7% | +10% | +9% |
| B7 (texto natural) | 0.826 | +2% | +6% | +5% | +5% |
| PS2 (texto dañado) | 0.615 | +9% | +22% | +22% | +24% |
| G1 (gramatical) | 0.764 | +4% | +5% | +5% | +5% |
| Puntuación compuesta | 0.768 | +1% | +6% | +6% | +5% |
En mi opinión, `prod-ds41` es el todoterreno que interesa. `prod-mix1` tiene resultados impresionantes en algunas familias (sobre todo P1, P2 y B6), pero pierde mucho terreno frente a Jev en otras donde `prod-ds41` pierde menos (S3, S1, B1 y B3). `prod-mix2` tiene puntos débiles serios en comparación con los otros dos: es claramente más flojo en varias (S3, P1, P2 y B5) y no especialmente fuerte en el resto. Aun así, en conjunto, los tres suelen tener ventaja sobre Jev, con algunas excepciones en las que Jev destaca _de verdad_ (S1, S3 y B3).
Así que, puestos a elegir entre `prod-ds41` y `prod-mix1`, `prod-ds41` sale ganando simplemente por rendir bien de forma más constante en todas las familias.
## El veredicto
`prod-ds41` acabó llevándose la corona y ganándose la etiqueta `infini-jp-v1`. Las cifras demuestran con mucha claridad que es capaz de cubrir la mayoría de las funciones, con la decepcionante excepción de S1, la naturalidad de la oración, para la que de todos modos encontré otra solución (más sobre eso después).
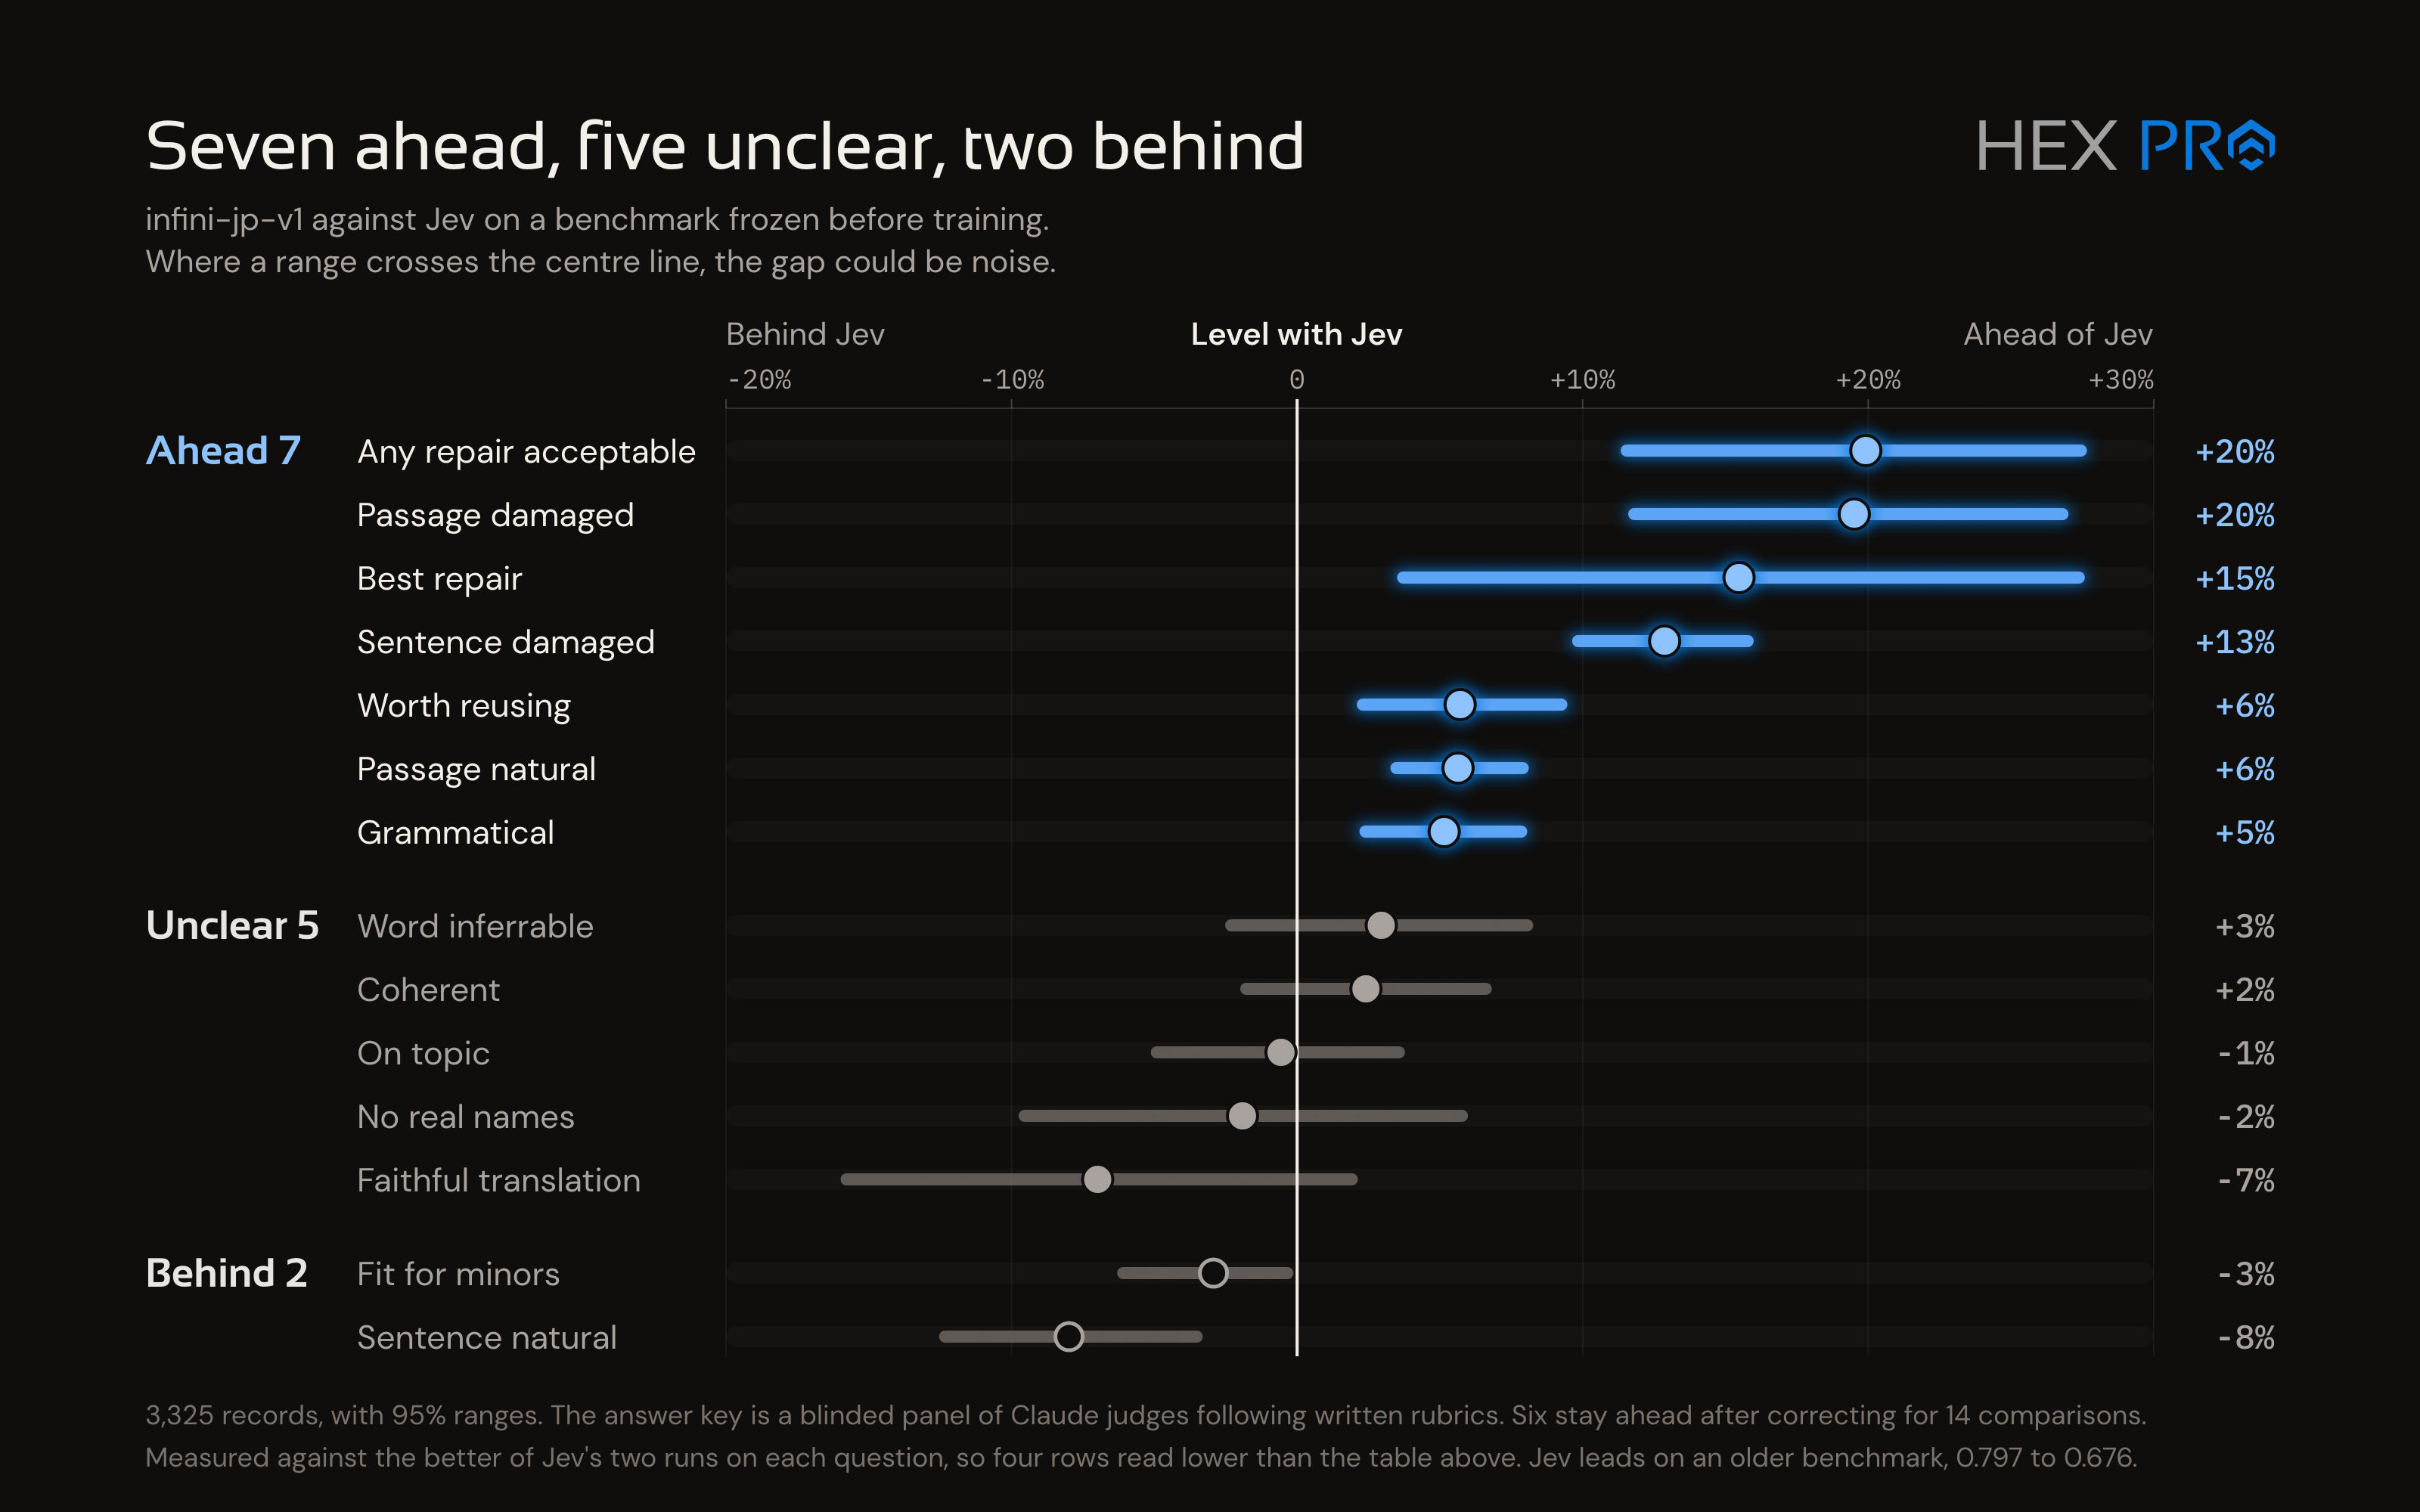 En cuanto a la pregunta principal, ¿es Laya mejor que Jev? ¿Quizá? Pero probablemente no. Aunque en este caso supera a Jev en este conjunto concreto de tareas, hagamos balance de lo que costó desarrollarlo.
### ¡Dinero contante y sonante, baby!
En total, gasté 270 USD (389 AUD) en este proyecto: 268,23 USD en inferencia en la nube y **0,21 USD en Jev**. Barato para lo que suele costar entrenar IA, si hacemos caso a los cientos de miles de millones de deuda que están asumiendo Anthropic y OpenAI. No tan barato para una startup con poco capital y unos ingresos mínimos (por ahora). Pero fue una I+D valiosa, porque respondió a preguntas importantes sobre si debería usar esto en mis otros proyectos en el futuro. Además, ahora tengo un proyecto de pipeline de entrenamiento con más de 1000 commits y 14.522 pruebas unitarias, lo que significa que desarrollar otro modelo System One en el futuro es solo cuestión de pulir la rúbrica y hacer las comparativas de modelos.
### ¡TIEMPO!
En tiempo de dedicación directa, no fue nada barato. Gracias a Dario por Claude Code, porque se encargó de gran parte del trabajo rutinario (vigilar cuándo terminaban las ejecuciones, poner en cola las siguientes partes, etc.). Eso supuso un tiempo muerto mínimo: el trabajo siguió avanzando por la noche. Aun así, terminar este proyecto de principio a fin me llevó 24 días. Sin la ayuda de la IA habría tardado seis meses, no me cabe la menor duda.
Aunque la IA me ahorró muchísimo tiempo y me permitió trabajar en otras cosas en paralelo, las horas que le dediqué yo mismo habrían valido unos 5000 AUD de mano de obra a mi antigua tarifa. Es un coste que _hay_ que tener en cuenta al entrenar un modelo System One.
### Cómputo de GPU y electricidad
Tengo cierta suerte, porque dispongo de una GPU de nivel empresarial rápida y potente. Pero este proyecto necesitó más de 40 horas de uso exclusivo de la GPU, y me da miedo pensar en cuánto subió la factura de electricidad. Ni siquiera quiero saberlo.
El otro coste continuo es que ocupa aproximadamente 2 GB de VRAM en mi servidor.
### ¿Vale la pena?
Es una pregunta importante y difícil de cuantificar. Estas son las preguntas que querría responder si me estuviera planteando intentarlo:
- ¿Es Jev capaz de hacer bien la tarea?
- ¿Qué volumen de llamadas esperas tener?
- ¿Cuántas tareas necesitas que haga, y hasta qué punto son variadas?
- ¿Cuánto tardarás en recuperar la inversión?
- ¿Qué importancia tiene para ti la tranquilidad de saber que tu software seguirá funcionando después de que TypeSafe desaparezca?
- ¿Cuánto te importa una calibración/confianza precisa?
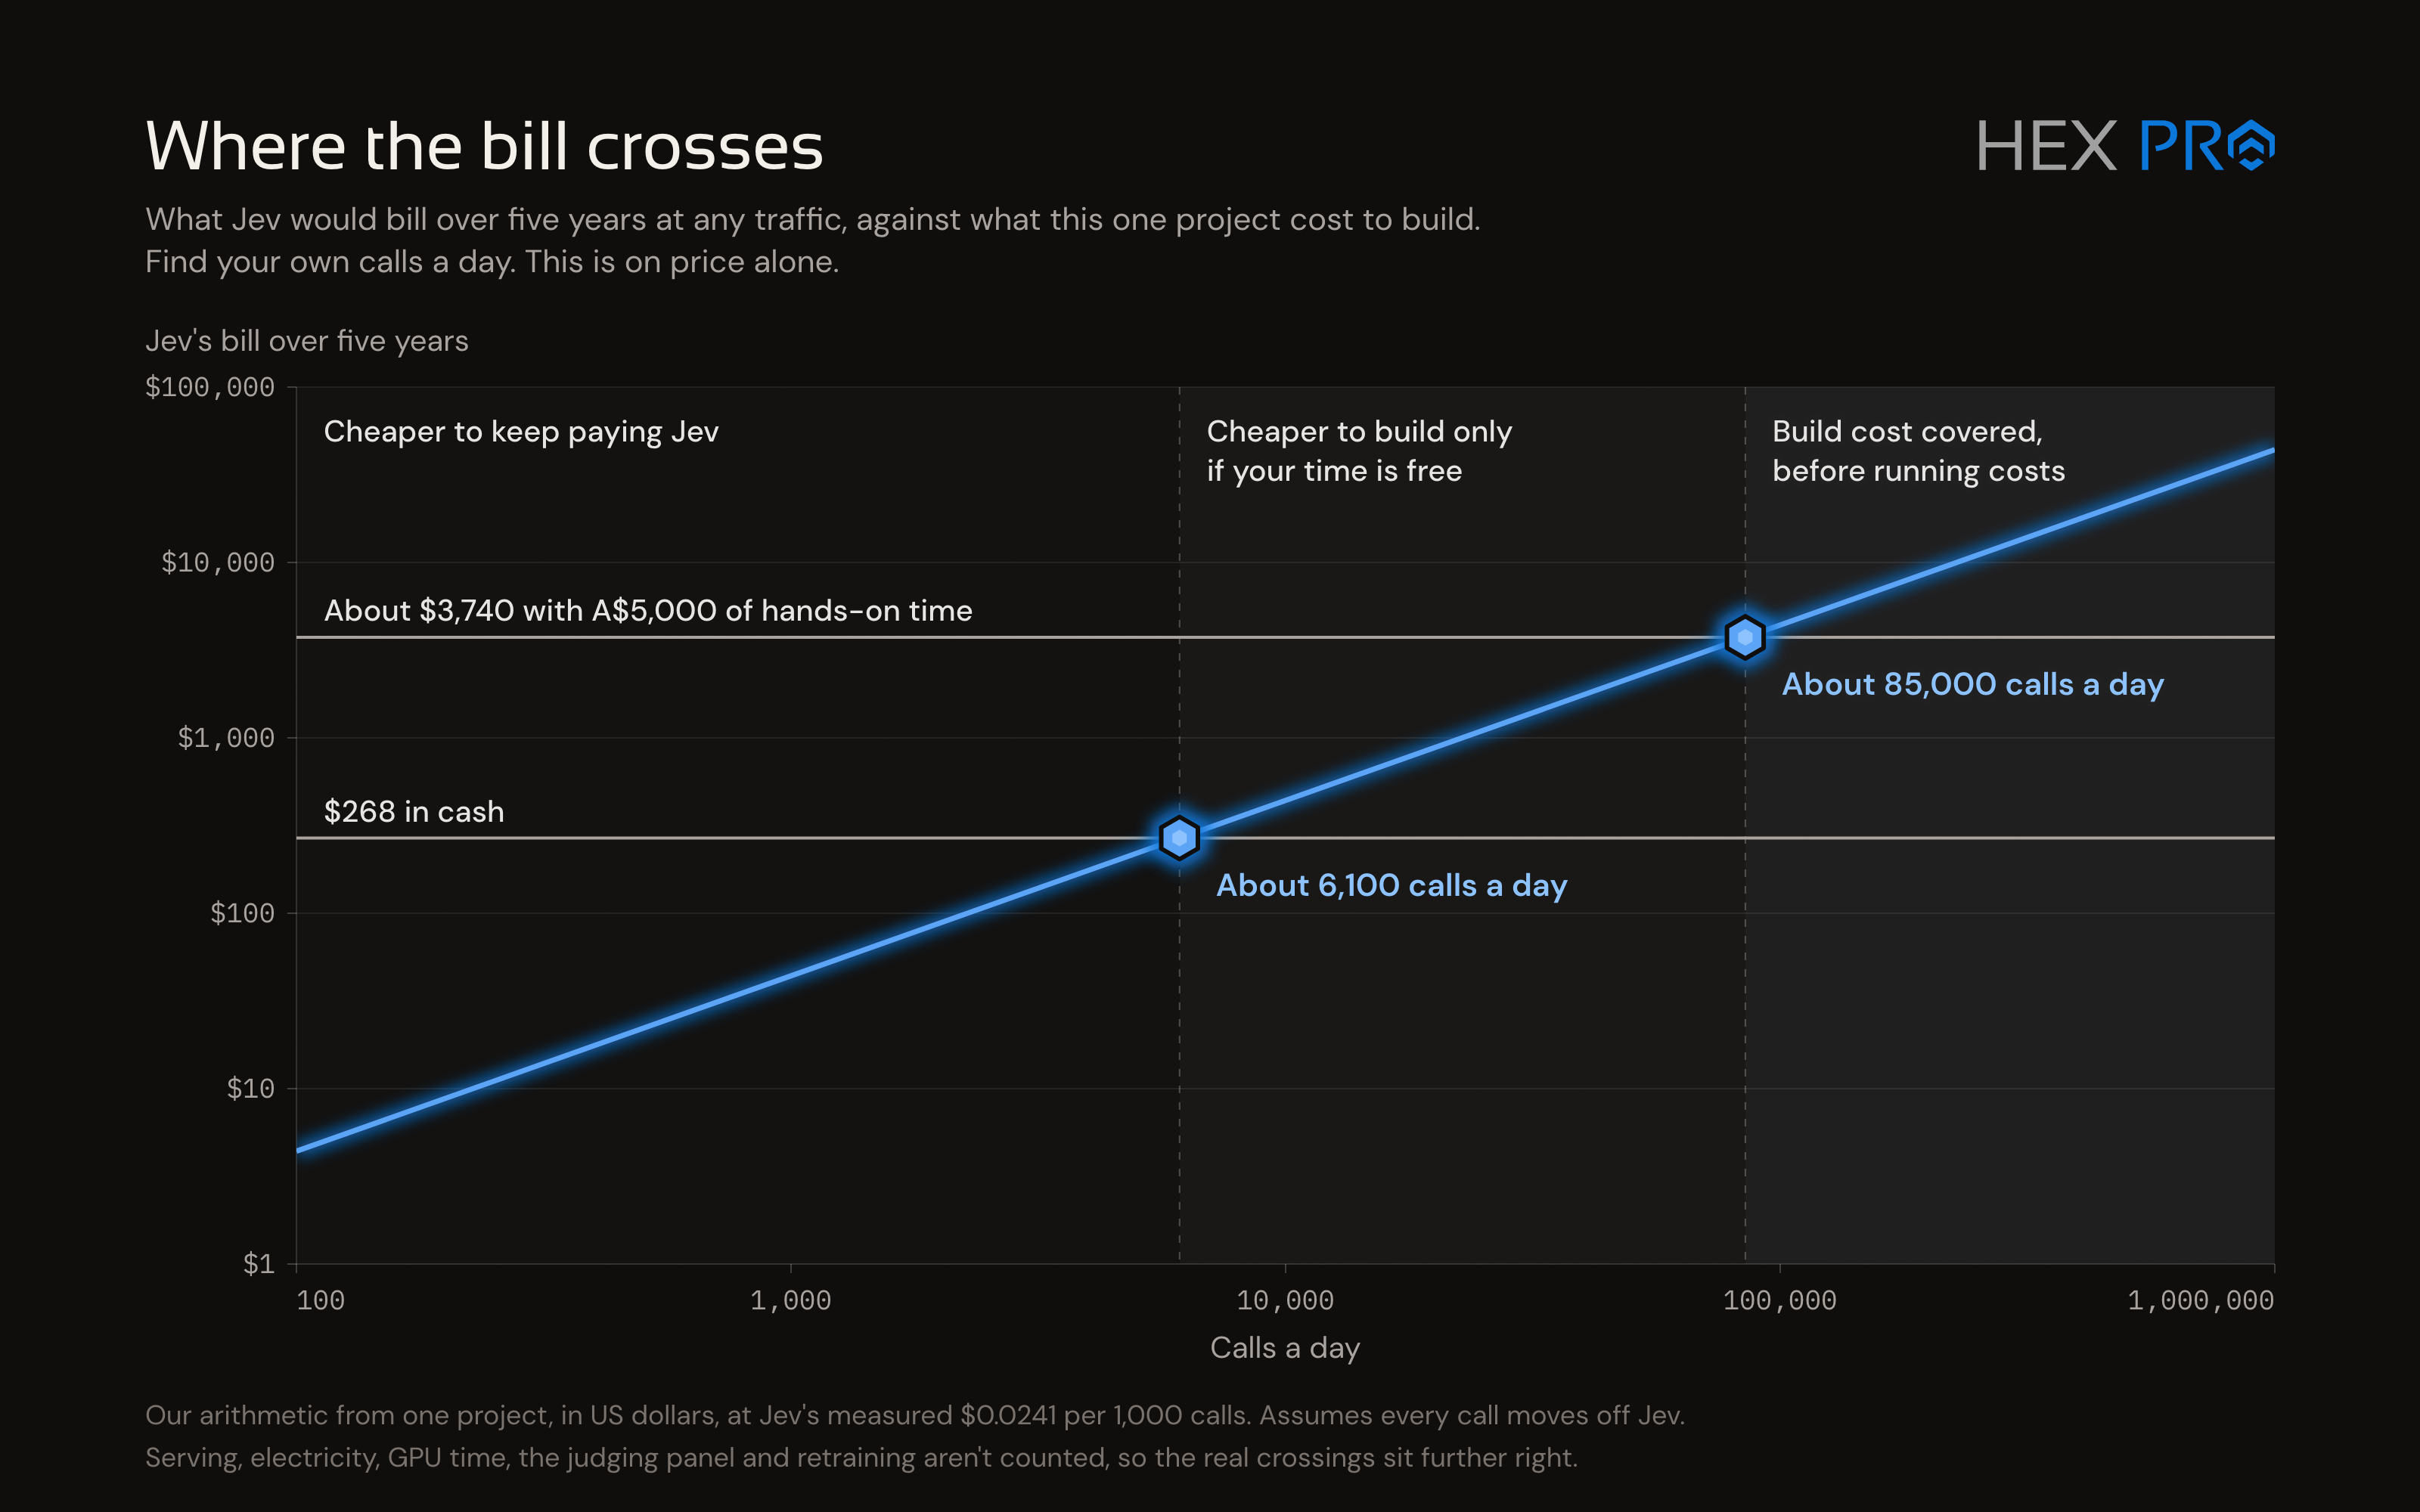 En mi caso, la mejora de capacidad puede ayudar a que Infinilang funcione mejor. Si gracias a eso Infinilang funciona mejor y me permite reunir una base de usuarios más grande, acabará amortizándose inevitablemente. Es la única forma en que puedo justificar usar Laya en lugar de Jev.
### Las mayores ventajas
- **Latencia**: desde Australia, Jev tarda unos 258 ms en ir y volver. Laya tarda de media unos 19 ms: es al menos 13 veces más rápido que Jev, y 2000 veces más rápido que DeepSeek.
- **Coste de oportunidad de la GPU**: ocupa 2 GB de VRAM. No es despreciable, pero tampoco es una barbaridad. Ahora bien, la verdadera ventaja es esta: esas 14 familias de preguntas que responde `infini-jp-v1` son preguntas que no tiene que responder (mal) Qwen 3.8 27B, lo que deja libre la GPU para atender otras peticiones más importantes y adecuadas.
- **Imitar a un modelo superior**: no necesitas ejecutar DeepSeek V4.1 para obtener respuestas bastante parecidas a las que daría. `infini-jp-v1` rinde muchísimo mejor que Qwen 3.8 27B en estas tareas, y no hace falta sacar un modelo DeepSeek de 614 GB de VRAM para conseguirlo.
- **Seguridad para el negocio**: como he dicho varias veces, si uso mi propio modelo no tengo que preocuparme de que Jev desaparezca de un día para otro. Nada de caídas inesperadas ni de carreras desesperadas en busca de una alternativa. Si mi software está en marcha, sé que mi modelo System One también lo está.
- **¿Superioridad en tareas concretas?**: está por ver si rinde mejor en producción. Ya veremos. Como viste en las puntuaciones, en teoría es un 6% mejor en Infinilang, pero eso es en el conjunto de las familias, no necesariamente en las que sostienen el peso del sistema.
## A propósito de LoRA
Para los no iniciados: un [LoRA (Low-Rank Adaptation, adaptación de bajo rango)](https://en.wikipedia.org/wiki/LoRA_(machine_learning)) es algo así como una personalidad lista para enchufar a un LLM. Puede que hayas oído a gente llamarlo 'fine-tuning' (ajuste fino). A diferencia de un modelo System One, que es un servicio aparte, un LoRA se aplica directamente al LLM en el momento de la inferencia para modificar sus pesos y hacer que se comporte de otra manera.
Por eso, en una fase posterior del desarrollo de Infinilang, he entrenado un LoRA para ayudar a Qwen 3.8 27B a producir resultados de mejor calidad y a seguir reglas más estrictas. Esto significa que `infini-jp-v1` clasificará material de mayor calidad. No tendrá que esforzarse tanto y su efecto debería ser más fiable, sobre todo con usuarios que conocen menos kanji.
Seguiré esforzándome por mejorar Infinilang aún más a medida que avance el desarrollo.