---
title: "نماذج System One ستُحدث ثورة في الذكاء الاصطناعي: Laya وJev"
description: "درّبت Hex Pro نموذج System One بـ Laya في 3 أسابيع. فما الذي تطلّبه ذلك، وكم كلّف، وهل يضاهي Jev من TypeSafe، النموذج ذا الـ 40 مليون دولار أمريكي؟"
author: "Matthew Scott"
published: "2026-11-11T05:24:58.094Z"
updated: "2026-11-11T05:34:08.290Z"
language: "ar"
canonical: "https://hex.pro/ar/blog/system-one-models-will-revolutionise-ai-software-laya-jev"
markdown: "https://hex.pro/ar/blog/system-one-models-will-revolutionise-ai-software-laya-jev.md"
publisher:
name: "Hex Pro"
url: "https://hex.pro"
---
شهد يوم 15 سبتمبر تحوّلاً زلزالياً في عالم الذكاء الاصطناعي والتقنية، مرّ دون أن يلاحظه عامة الناس إلى حد كبير. وكالعادة، كان مهندسو البرمجيات في طليعة هذا التقدّم الذي فات الجميع غيرهم، إذ أطلقت TypeSafe AI أول نموذج **System One** تجاري، *«Jev»*.
وبعد ثلاثة أسابيع، كنت قد درّبت نموذج System One خاصاً بي لأحد منتجاتنا القادمة. وهذه حصيلة تلك التجربة.
## نماذج System One: مجرد استغلال تجاري آخر لموجة الذكاء الاصطناعي؟
كل من يتابع الذكاء الاصطناعي هذه الأيام يعرف هذا الشعور. يرسل إليك أحدهم رابطاً لمنتج ذكاء اصطناعي جديد في السوق، فتتأفّف. «نماذج System One؟» تسأل. ومن يهتم؟ لديّ Claude Opus وكمّ هائل من العمل. ليس لديّ وقت لـ *Manus* آخر أو *Rabbit r1* آخر.
هذا بالضبط ما دار في رأسي حين سمعت عن Jev أول مرة. لكن الناس كانوا يسألونني عن رأيي، فقررت أن أبحث في الأمر. ومن البداية، يقصّر موقع TypeSafe AI كثيراً في شرح الفكرة. ولن تُلام إن قرأت [تدوينة الإطلاق على مدونتهم](https://typesafe.ai/blog/introducing-system-one-models-and-jev) وظننت أن Jev يُفترض أن ينافس نماذج الذكاء الاصطناعي الرائدة من OpenAI وAnthropic (خصوصاً أن الرسوم البيانية فيها تُظهر ذلك). فهم يرمون بعبارات مثل «التعلّم المعزّز للقرارات المعايَرة» (RLCD)، وهي عبارات لا تعني شيئاً تقريباً للمستهلكين.
احتاج الأمر إلى [هذا المقال الأفضل بكثير من LangChain](https://www.langchain.com/blog/building-a-harness-with-jev) ليشرح ما يفعله Jev *فعلاً*. إن أردت الشرح الكامل، **فاقرأ** ذلك المقال، فهو يستحق القراءة تماماً. وفي الأسفل رسم توضيحي من المقال أذهلني، وشرح حالة الاستخدام أفضل من أي شيء نشرته TypeSafe.
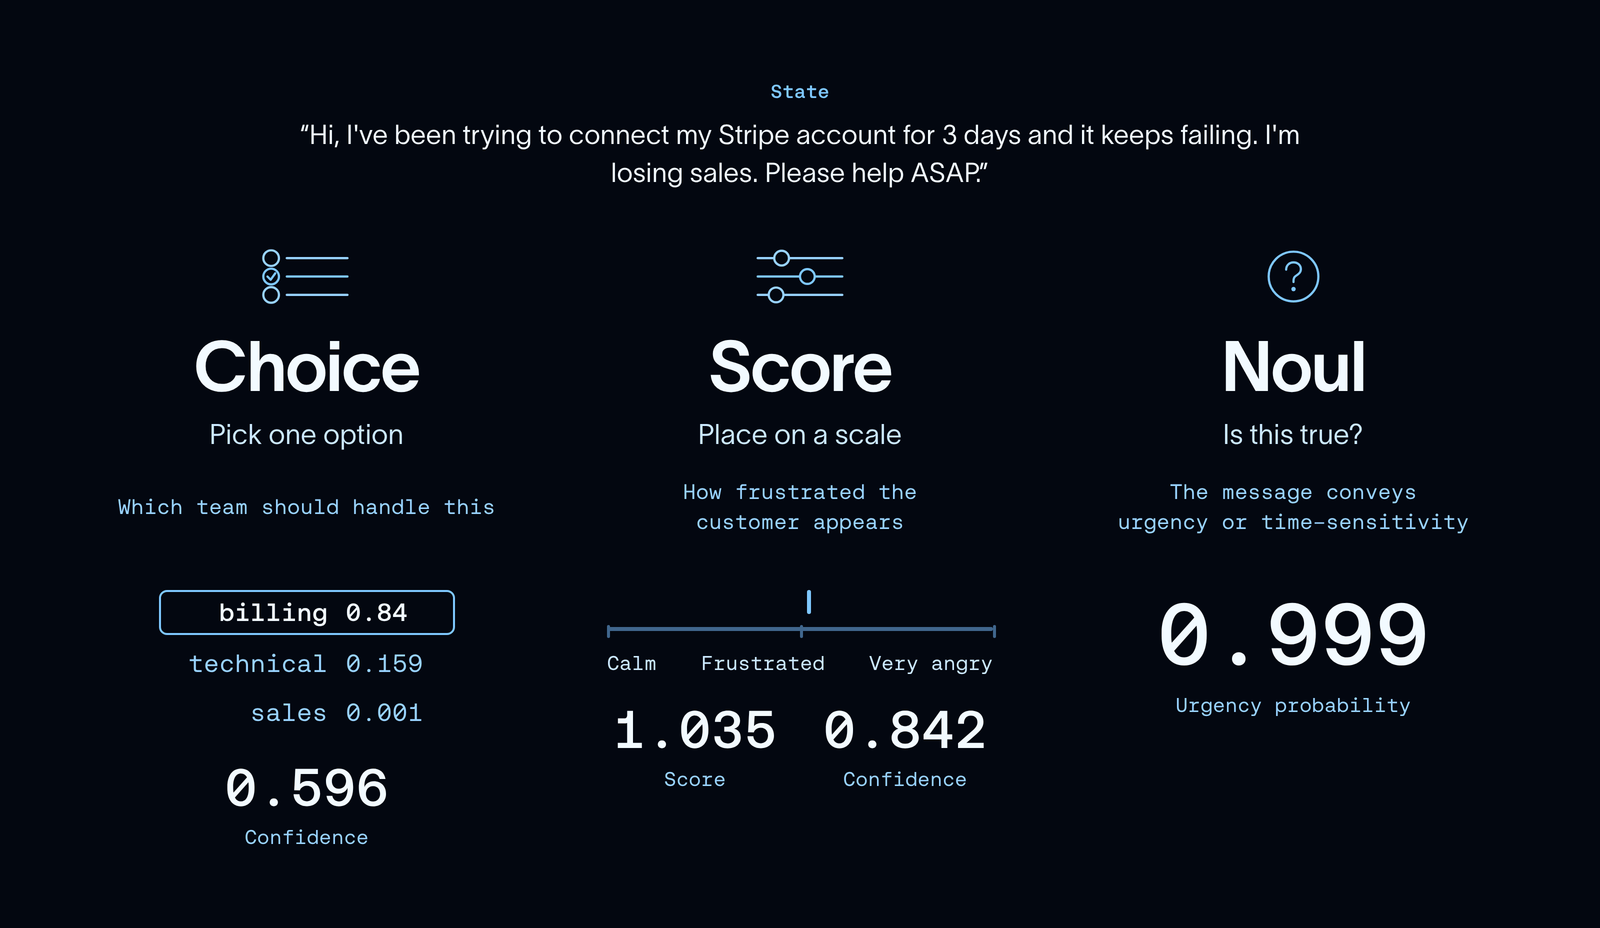 ### الفجوة المذهلة
ما إن رأيت ذلك المثال حتى انفتح أمامي عالم من الإمكانات، وغمرت ذهني الحلول التي يقدّمها للمشكلات التي كنت أواجهها. أدركت أنه يحل مشكلات في اثنين من مشاريعنا القادمة، [Infinilang](https://apps.hex.pro/ar/infinilang) و[kcalc.ai](https://kcalc.ai) (وموقع الأخير لم يكتمل حتى تاريخ هذا المقال).
يعتمد كلا المشروعين في قدراتهما على النماذج اللغوية الكبيرة (LLM). لست من النوع الذي يحشر الذكاء الاصطناعي في أي شيء لمجرد إثبات فكرة، وليست هذه الشركة التي أريد أن أديرها. صغت فكرتي هذين المشروعين بشكل مستقل بينما كانت أدوات الذكاء الاصطناعي تتطور خلال آخر 4 سنوات، وهما يقدّمان حلولاً مبتكرة حقاً لمشكلات عانى منها البشر سنوات طويلة.
*سأقدّم لمحة سريعة عن هذين المشروعين لتتضح لك الصورة، لكننا سنركّز في هذا المقال على Infinilang أساساً، فتجاوز الجزء الخاص بـ kcalc.ai إن كان وقتك ضيقاً.*
#### kcalc.ai: حاسبة السعرات الحرارية التي تستخدم الذكاء الاصطناعي فعلاً
هل حاولت يوماً أن تخسر وزناً أو تكسبه؟ أنا حاولت. ظللت أرتاد صالة الألعاب الرياضية ثلاث سنوات قبل أن أدرك أن تمارين القوة ليست سوى ثلث صورة بناء الأجسام. أما الثلثان الآخران فهما *النوم* و**السعرات الحرارية المتناولة**. ولسوء حظي، لست بارعاً في زيادة الوزن، وكان تناول أكثر مما أحتاجه للحفاظ على وزني أمراً صعباً للغاية.
جرّبت إحدى حاسبات السعرات الحرارية تلك التي تجدها في متجر التطبيقات. تعرف هذا النوع: تسجّل طعامك طوال اليوم وتحاول بلوغ هدف معيّن. الفكرة رائعة، لكن التنفيذ سيئ في كل الأحوال تقريباً. تقضي في تسجيل الطعام وتصحيح توازن العناصر الغذائية الكبرى والسعرات وقتاً أطول مما تقضيه في الأكل نفسه. وعادةً ما توفّر هذه التطبيقات ميزة كاميرا أيضاً، تعمل في نحو 20% من المرات، ولا تصيب *أبداً* في تقدير العناصر الغذائية الكبرى أو حجم الحصة أو السعرات. وهي عديمة الفائدة تقريباً مع الطعام المنزلي وغير المعتاد أيضاً.
ما يميّز kcalc.ai هو أنه يهدف إلى تقليل عناء التسجيل تقليلاً كبيراً. فعندما تلتقط صورة أو تجري مسحاً بـ LiDAR، تمرّ المعلومات عبر خط معالجة معقّد للأدلة من 15 مرحلة. وهو يستخدم مزيجاً من النماذج اللغوية الكبيرة، وقاعدة بيانات متجهية، وقاعدة بيانات ضخمة للأطعمة والوصفات، ونماذج رؤية حاسوبية، وإعادة بناء ثلاثية الأبعاد من مسح LiDAR، ووكلاء تفكير متعدد الخطوات، وغير ذلك الكثير.
وفي الواقع العملي، كان مكوّن الذكاء الاصطناعي في هذا التطبيق مهمة ضخمة. ولا عجب أن قلة حاولوا ذلك، لأنه يتطلب قدراً هائلاً من الخبرة في هندسة البرمجيات وتفكيراً متقدماً في الأنظمة لا يملكه إلا قليلون. ببساطة، لم يكن ليصبح ممكناً لولا مساعدة وكيل برمجة بالذكاء الاصطناعي، أو 10 ملايين دولار أمريكي وعام كامل من وقت 5 مهندسين.
يواجه kcalc.ai عدداً من المشكلات الجدية التي كان لا بد من معالجتها ليصبح مجدياً تجارياً. وأكبر اثنتين منها هما **تقييم الدقة** و**السرعة**.
لننظر في سيناريو.
> يرفع المستخدم صورة لـ «بطاطس مقلية بلجيكية مع المايونيز».
يعالج خط معالجة الأدلة الصورة، ويخلص مزيج المراحل مع خطوات متعددة من تفكير النموذج اللغوي إلى أنها بالفعل بطاطس مقلية بلجيكية، على الأرجح مع المايونيز. والمثير في kcalc.ai أنه لا يعيد إلى المستخدم بالضرورة سجلاً معدّاً مسبقاً، بل يولّد سجلاً ديناميكياً بناءً على السياق وقياسات فعلية للأبعاد مع حسابات للحجم. كل هذا جميل ورائع. إنه يعمل، وإن كان يستغرق نحو دقيقتين ليشق طريقه عبر خط المعالجة.
يتضمن التطبيق ميزة «أطلس العالم» التي تتيح للمستخدمين جمع المطابخ الوطنية أو «الأطباق الكلاسيكية» وملء خريطة العالم الخاصة بهم. ولذلك، ثمة قائمة من الأطباق يجب التحقق منها في نهاية التعرف على الطعام. فكيف نفعل ذلك؟ تقليدياً، ربما كنا سنستخدم نوعاً من التعبيرات النمطية (Regex) أو خوارزمية تشابه للبحث في القائمة والعثور على المطابقات المحتملة. وهذا أول ما جرّبته، فأدى إلى أخطاء متكررة، إذ صار النظام يمنح مدخلات الأطلس خالطاً بين أطعمة متشابهة الأسماء. فكان الخيار البديهي التالي أن أسحب المطابقات المحتملة وأدع نموذجاً لغوياً يختار أنسبها. والمشكلة أن ذلك استهلك موارد حوسبة أكثر من اللازم، ولم أجد مبرراً لتعطيل ميزة تقدير السعرات من أجل ميزة إضافية ثانوية.
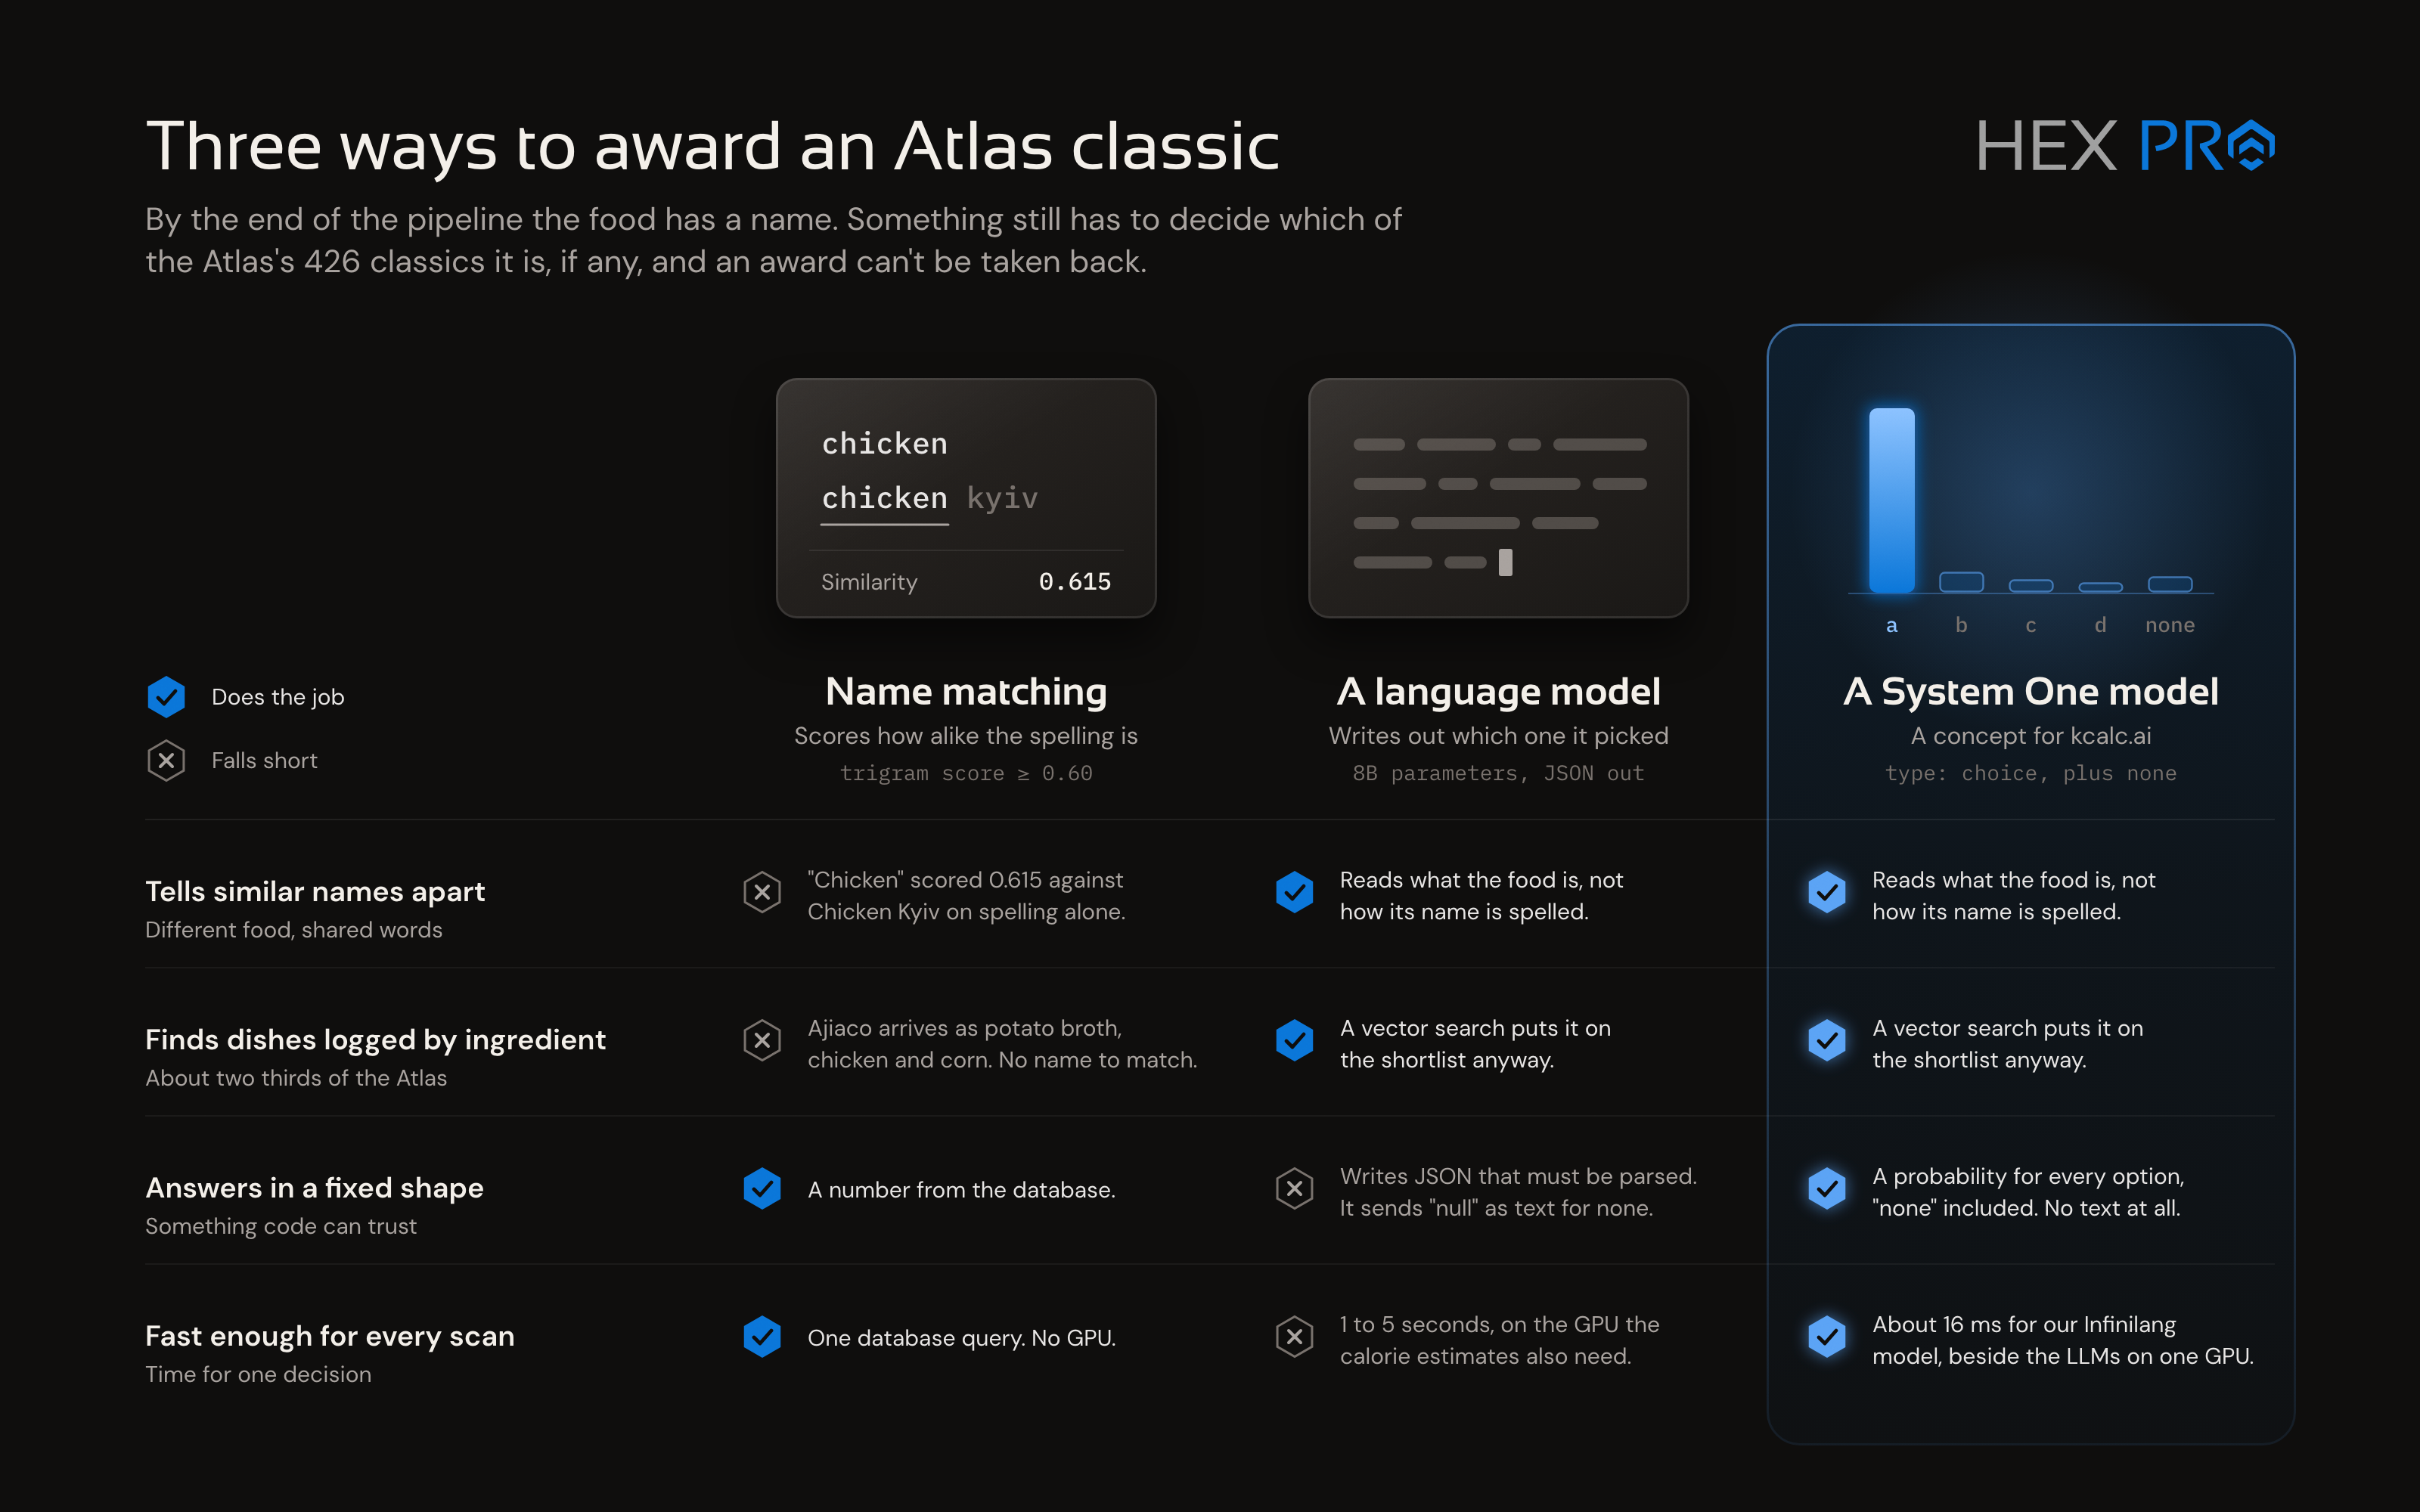 والحل يقدّمه نموذج System One إلى جانب قاعدة بيانات متجهية.
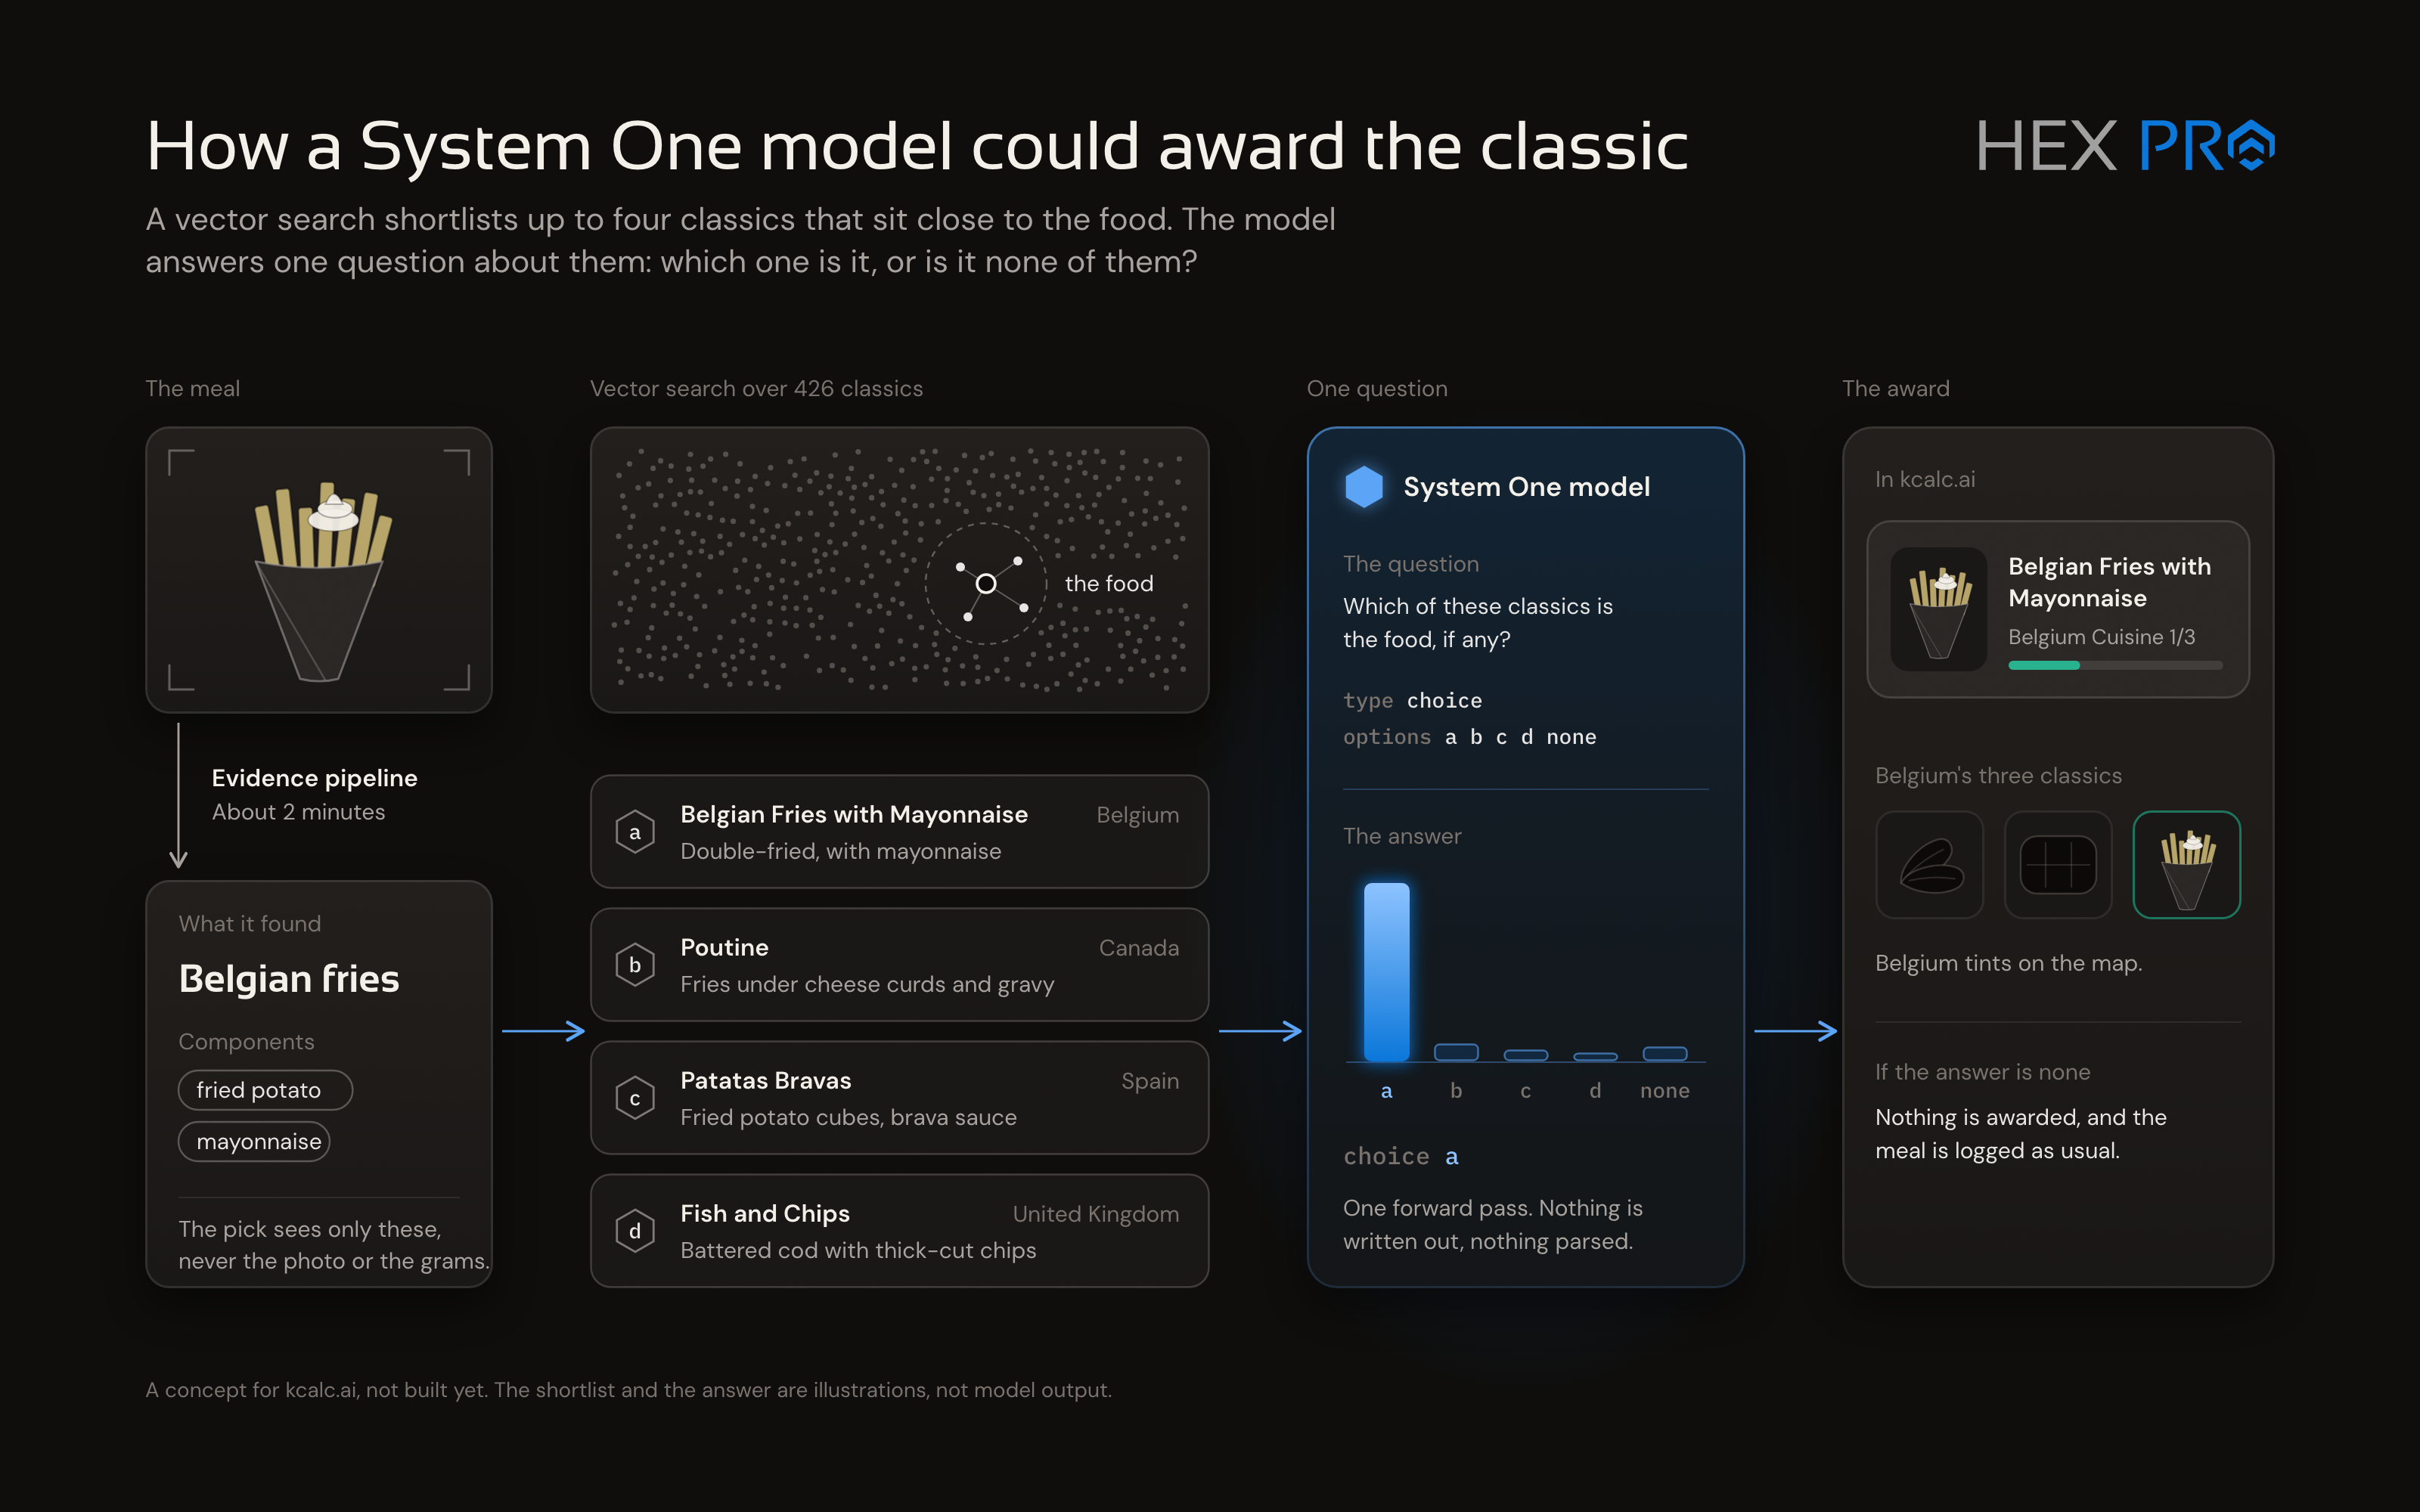 مع نموذج System One، لا يستغرق الحصول على اختيار دقيق سوى أجزاء من الثانية، وتكاليف الموارد زهيدة للغاية مقارنةً بالنماذج اللغوية الكبيرة الكاملة. إنه طوق نجاة في الحالات التي تكثر فيها الخيارات المتشابهة المحتملة.
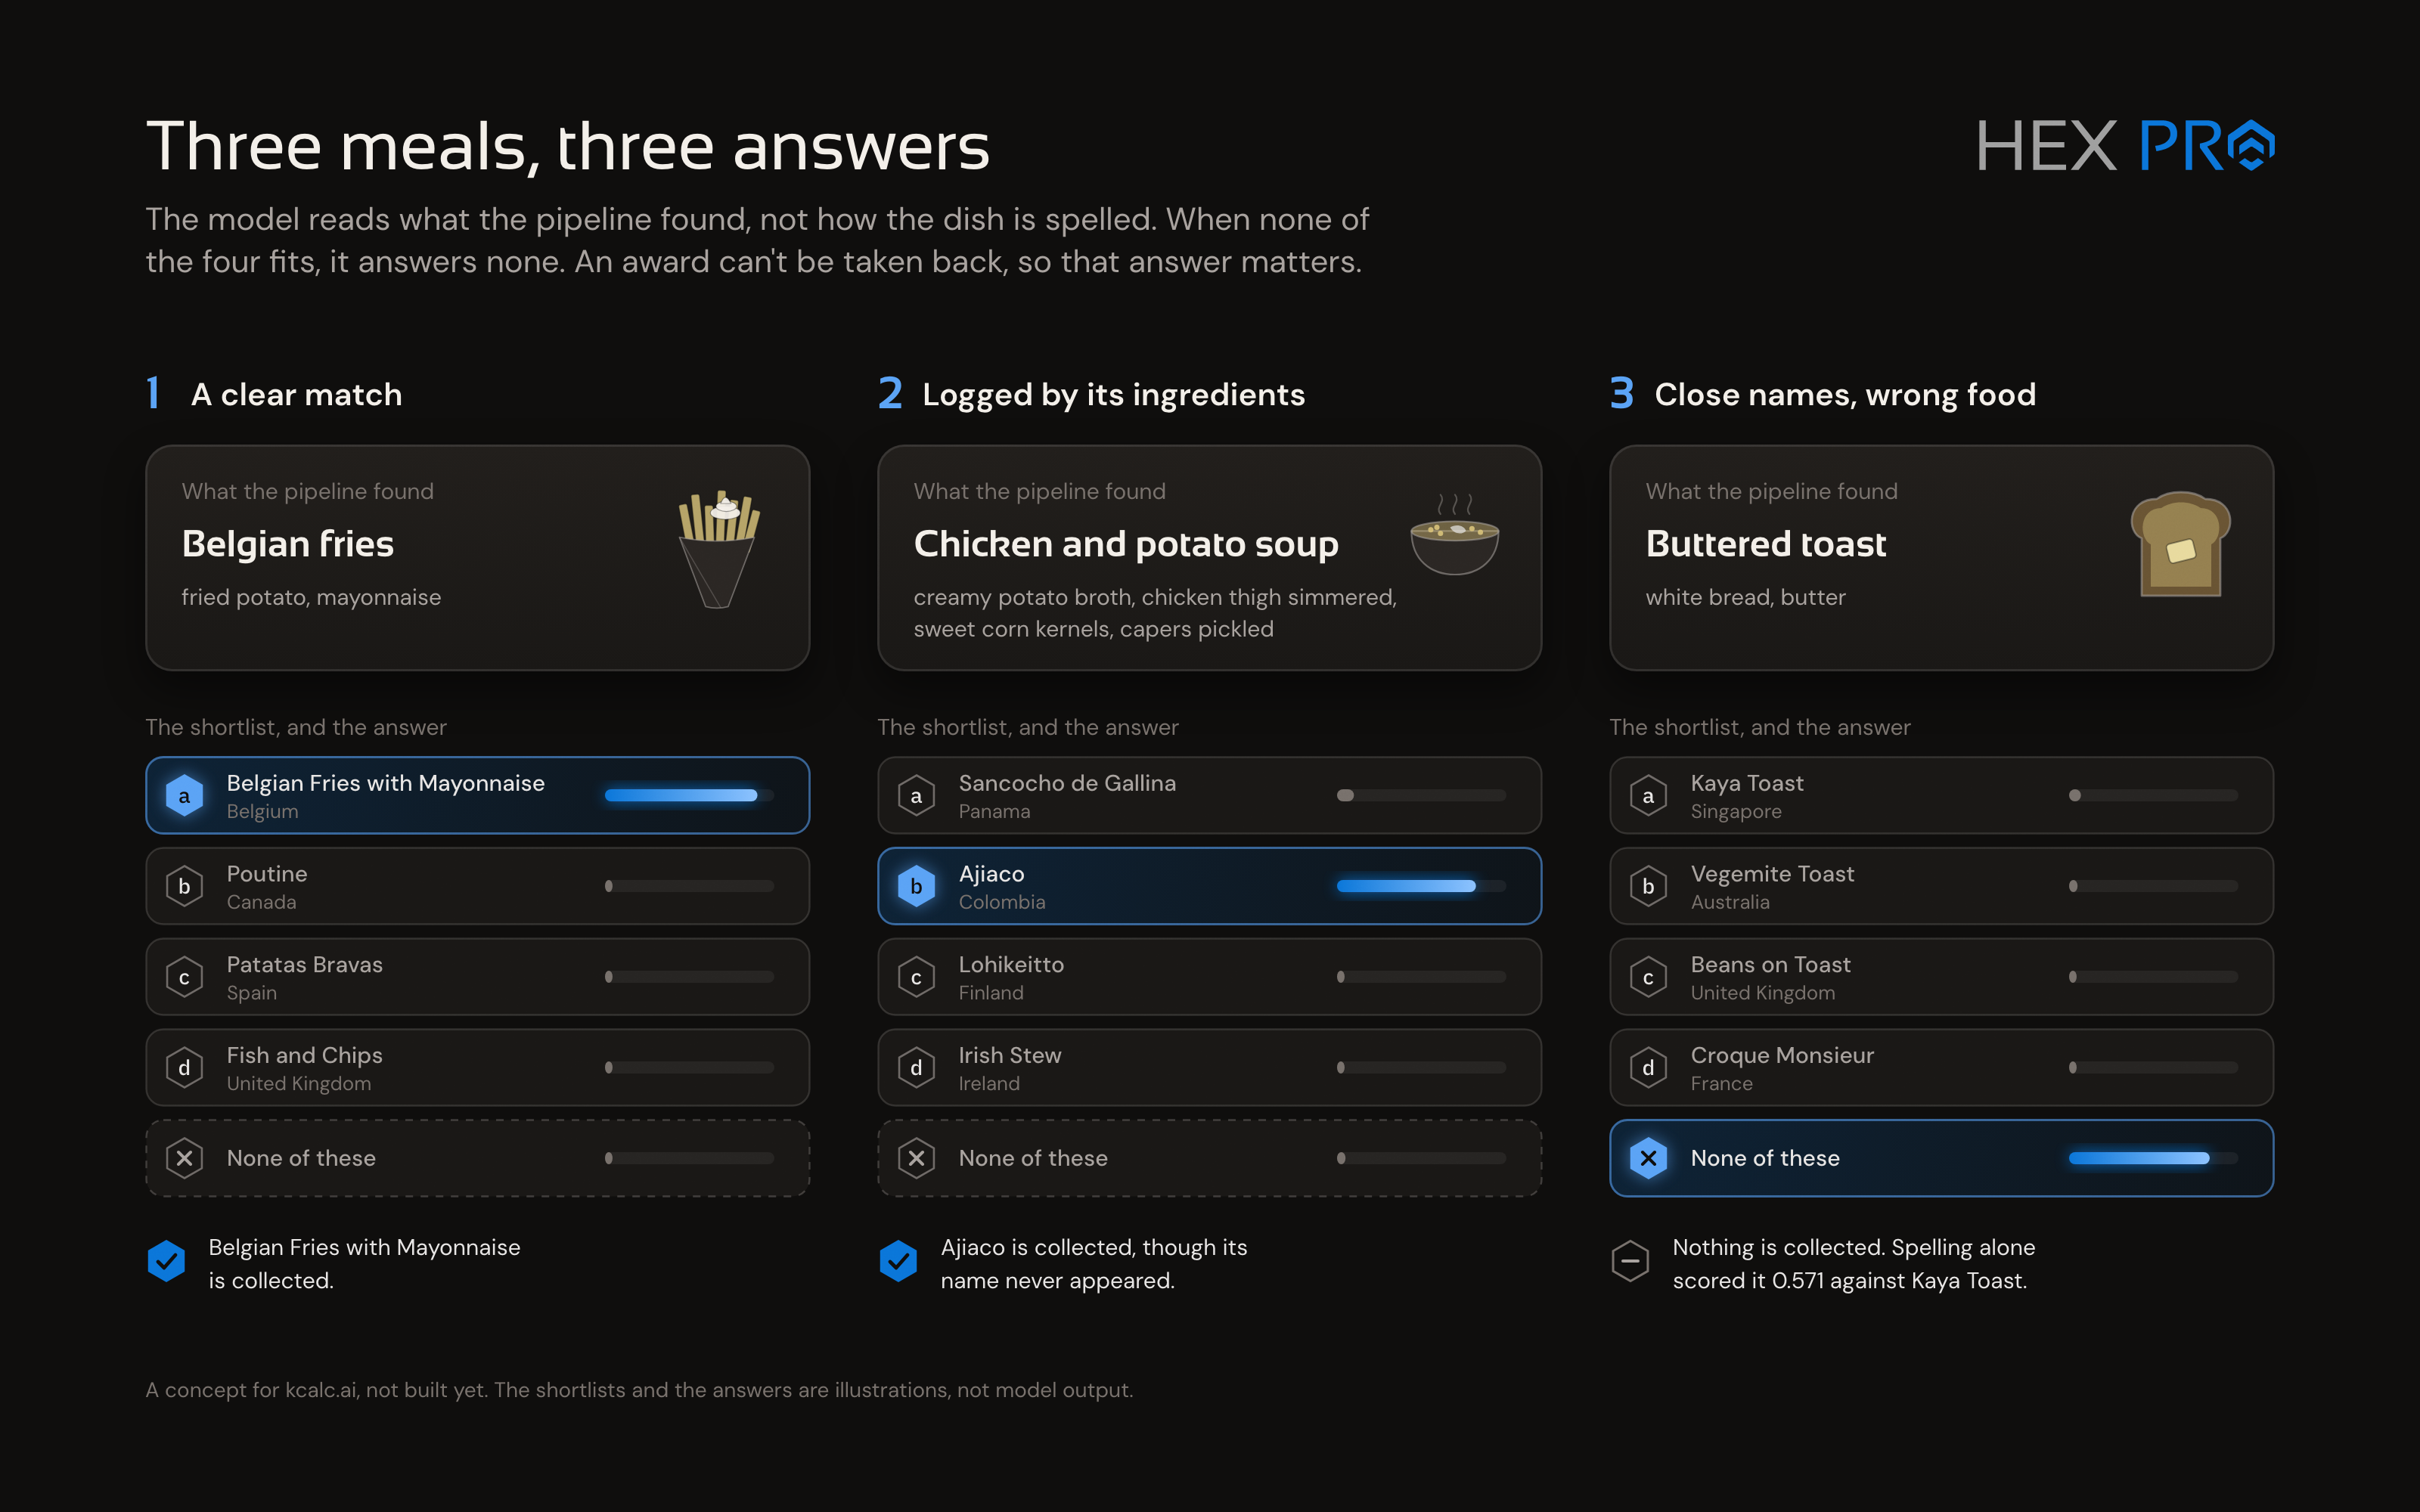 والجمال الحقيقي في واجهة نماذج System One أنها سهلة الدمج إلى حد لا يُصدَّق. يمكنك أن تجد مئات المواضع لإدراجها في قاعدة شفرتك، وهي رخيصة وسريعة إلى درجة أنها لا تكاد تستحق التفكير مرتين. وهذا مثال واحد فقط من مواضع كثيرة أعتقد أن kcalc.ai سيستفيد فيها من هذه التقنية الجديدة.
#### Infinilang: أفضل صديق لمتعلّم اليابانية
بوصفي متعلّماً لليابانية طوال حياتي، بوقت محدود للغاية و(بصراحة) بلا موهبة تُذكر في اللغات، اكتسبت إلماماً مقبولاً إلى حد ما باللغة. يكفي للتنقّل في اليابان، بل ولفتح بعض الأحاديث الطريفة في الحانات، لكنه لا يكفي لأنجو من مجاملات «nihongo jyouzu» («يابانيتك ممتازة!»).
ومن أصعب أجزاء تعلّم اليابانية «الكانجي»، وهي المجموعة الثالثة والأكثر عدداً من الحروف التي يتألف منها نظام الكتابة الياباني. وإليك مثالاً على مجموعات الحروف الثلاث:
- **الهيراغانا**: ありがとうございます (بالحروف اللاتينية *arigatou gozaimasu*، أي «شكراً جزيلاً»)
- **الكاتاكانا**: コールドブリューアイスコーヒー (بالحروف اللاتينية *korudo buru aisu kohi*، أي «قهوة مثلجة مخمّرة على البارد»)
- **الكانجي**: 人工知能 (بالحروف اللاتينية *jinkou chinou*، أي «الذكاء الاصطناعي»)
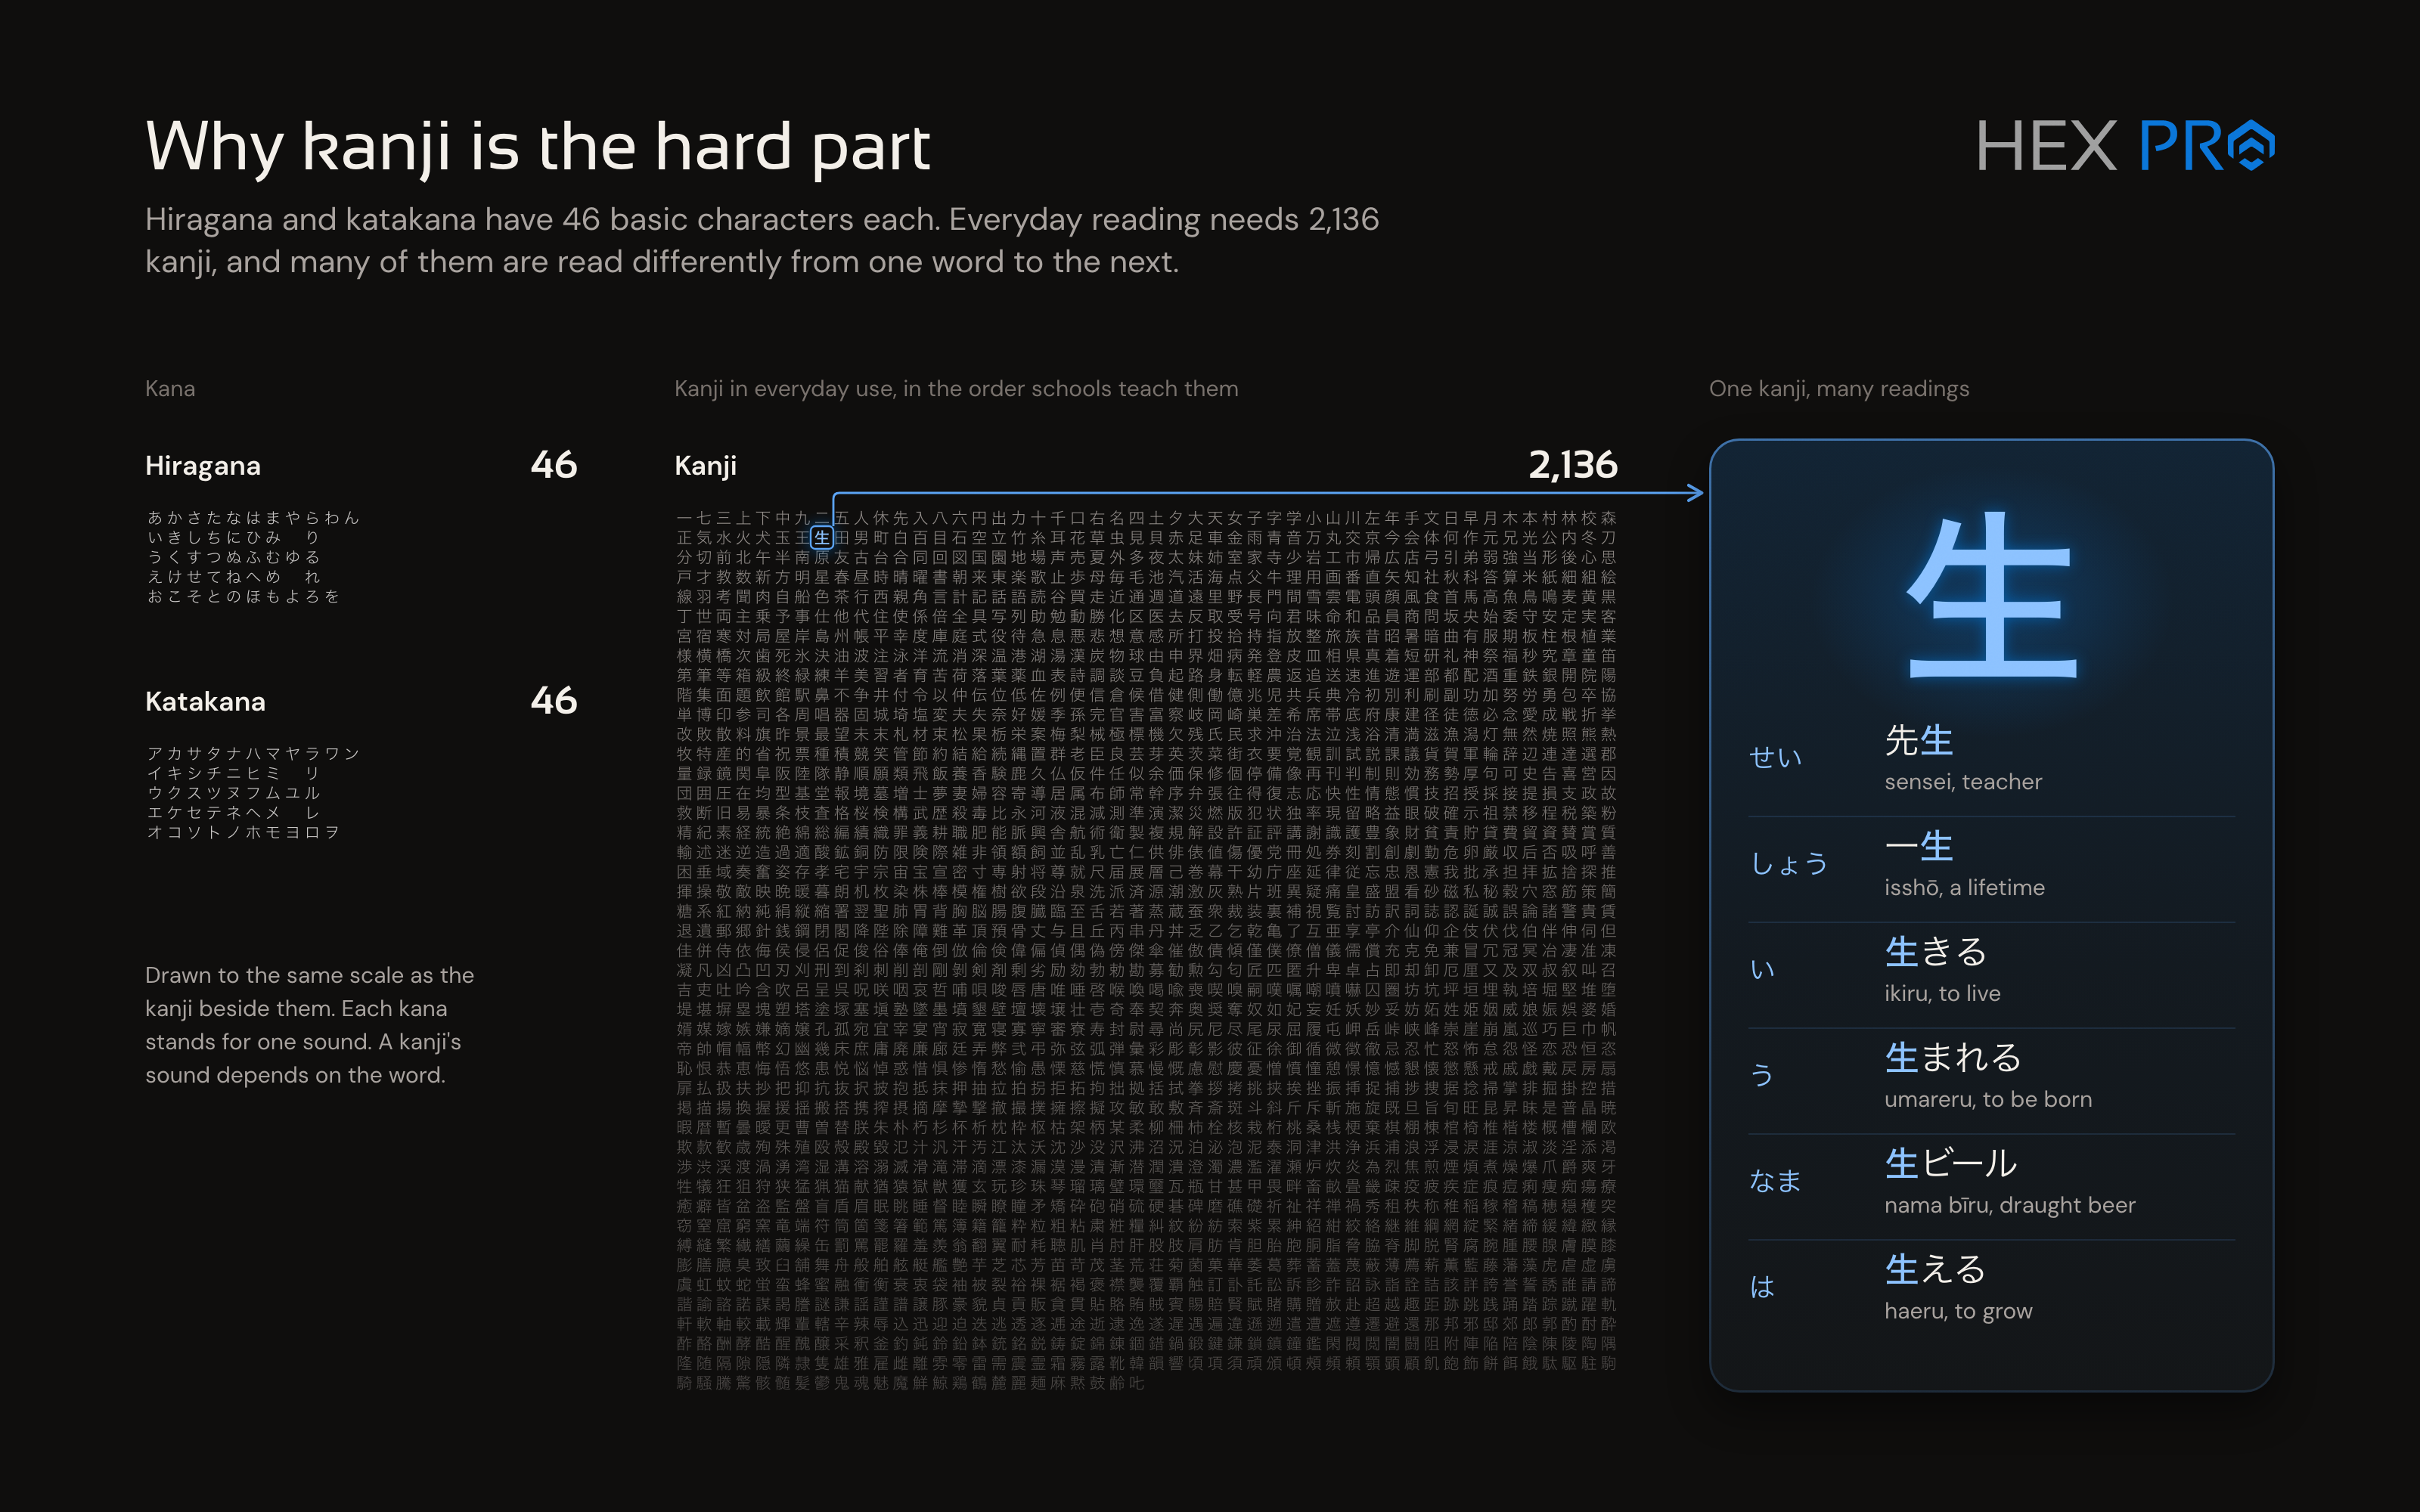
الكانجي مشتقة من الحروف الصينية، وتشترك معها في بعض المعاني، وإن كان نطقها مختلفاً تماماً في الغالب. ويزداد الأمر تعقيداً لأن هناك 2136 حرفاً شائعاً من الكانجي يلزم إتقانها لمحو الأمية الوظيفية، ونحو 4000 حرف للاقتراب من طلاقة أهل اللغة. وما يزيد الطين بلة أن لحروف الكانجي في الغالب عدة *قراءات*، أي أنها تُنطق بشكل مختلف بحسب موضع استخدامها. *كابوس حقيقي لمن يتعلّمها*.
 حين صدر GPT-3 من OpenAI أول مرة، كنت من أوائل من تبنّوه، ورأيت مبكراً الإمكانات شبه اللامحدودة لهذه التقنية. وأهمها بالنسبة إليّ تجربة تعلّم لغات مفصّلة على مقاس المتعلّم، طريقة لتعلّم اللغة بفعالية لم يسبق لها مثيل.
تصوّرت آنذاك ثلاثة تطبيقات جديدة للنماذج اللغوية الكبيرة، وظللت أقلّب هذه الأفكار سنوات. وخلال تلك المدة، طوّرت نسختين متتاليتين من النماذج الأولية لهذه التقنية وأثبتّ أنها تعمل فعلاً.
## فعالية الذكاء الاصطناعي في تسريع اكتساب اللغة
ذلك العنوان الأكاديمي حتى النخاع كان اسم أطروحة كنت أعمل عليها لنيل درجة الماجستير، تدور حول فكرة Infinilang. كنت أنوي في الأصل أن أقدّم هذه الأدوات بحثاً مفتوح المصدر، لكن العمل بدوام كامل ومحدودية الموارد جعلا ذلك صعباً للغاية. لذا أنوي بدلاً من ذلك أن أطرح Infinilang في السوق أولاً تطبيقاً للهواتف مغلق المصدر. وفي وقت لاحق، أنوي إصداره تطبيقاً مفتوح المصدر لأجهزة سطح المكتب، يتيح لك استخدام نموذج الذكاء الاصطناعي الخاص بك (BYO AI).
فما الذي يقدّمه Infinilang؟ بالنسبة إلى متعلّم اليابانية، حفظ الكانجي ليس إلا جانباً واحداً من تعلّم القراءة بفعالية. والحفظ حالياً عملية بطيئة ومملّة تعتمد على أنظمة التكرار المتباعد (SRS). وأشهرها Anki وWaniKani، والأخير هو المفضّل لديّ شخصياً. تقوم أنظمة SRS على عرض بطاقات تعليمية على المستخدم مراراً، مع إطالة الفاصل الزمني بين كل عرض والذي يليه تدريجياً. فالنظام مصمَّم ليعرض عليك الحرف الذي تعلّمته قبيل أن تنساه في كل مرة. وكلما زاد عدد مرات رؤيتك للبطاقة، طالت مدة احتفاظك بالمعلومة، ويكون هذا الاحتفاظ أكثر فعالية كلما تباعدت مرات رؤيتها. أنظمة SRS هي [أفضل طريقة مثبتة **لحفظ** الكانجي](https://doi.org/10.1037/0033-2909.132.3.354)، لكن أكبر نقاط ضعفها هو تعليمك كيف *تقرأ* الجمل التي فيها كانجي بفعالية.
> اقرأ مقالات NHK Easy فحسب، أو كتب الأطفال.
لطالما كانت النصيحة التقليدية أن تجد مواد قراءة سهلة وتبذل قصارى جهدك لتتجاوز حروف الكانجي المجهولة مستعيناً بالفوريغانا 東京، وهي علامات نطق صغيرة بالهيراغانا توضع فوق الكانجي في بعض الوسائط. والمشكلة واضحة. فيكفي أن تجهل حرف كانجي واحداً حتى تتعثر تماماً، وكثيراً ما يجعل ذلك الجملة غير مقروءة.
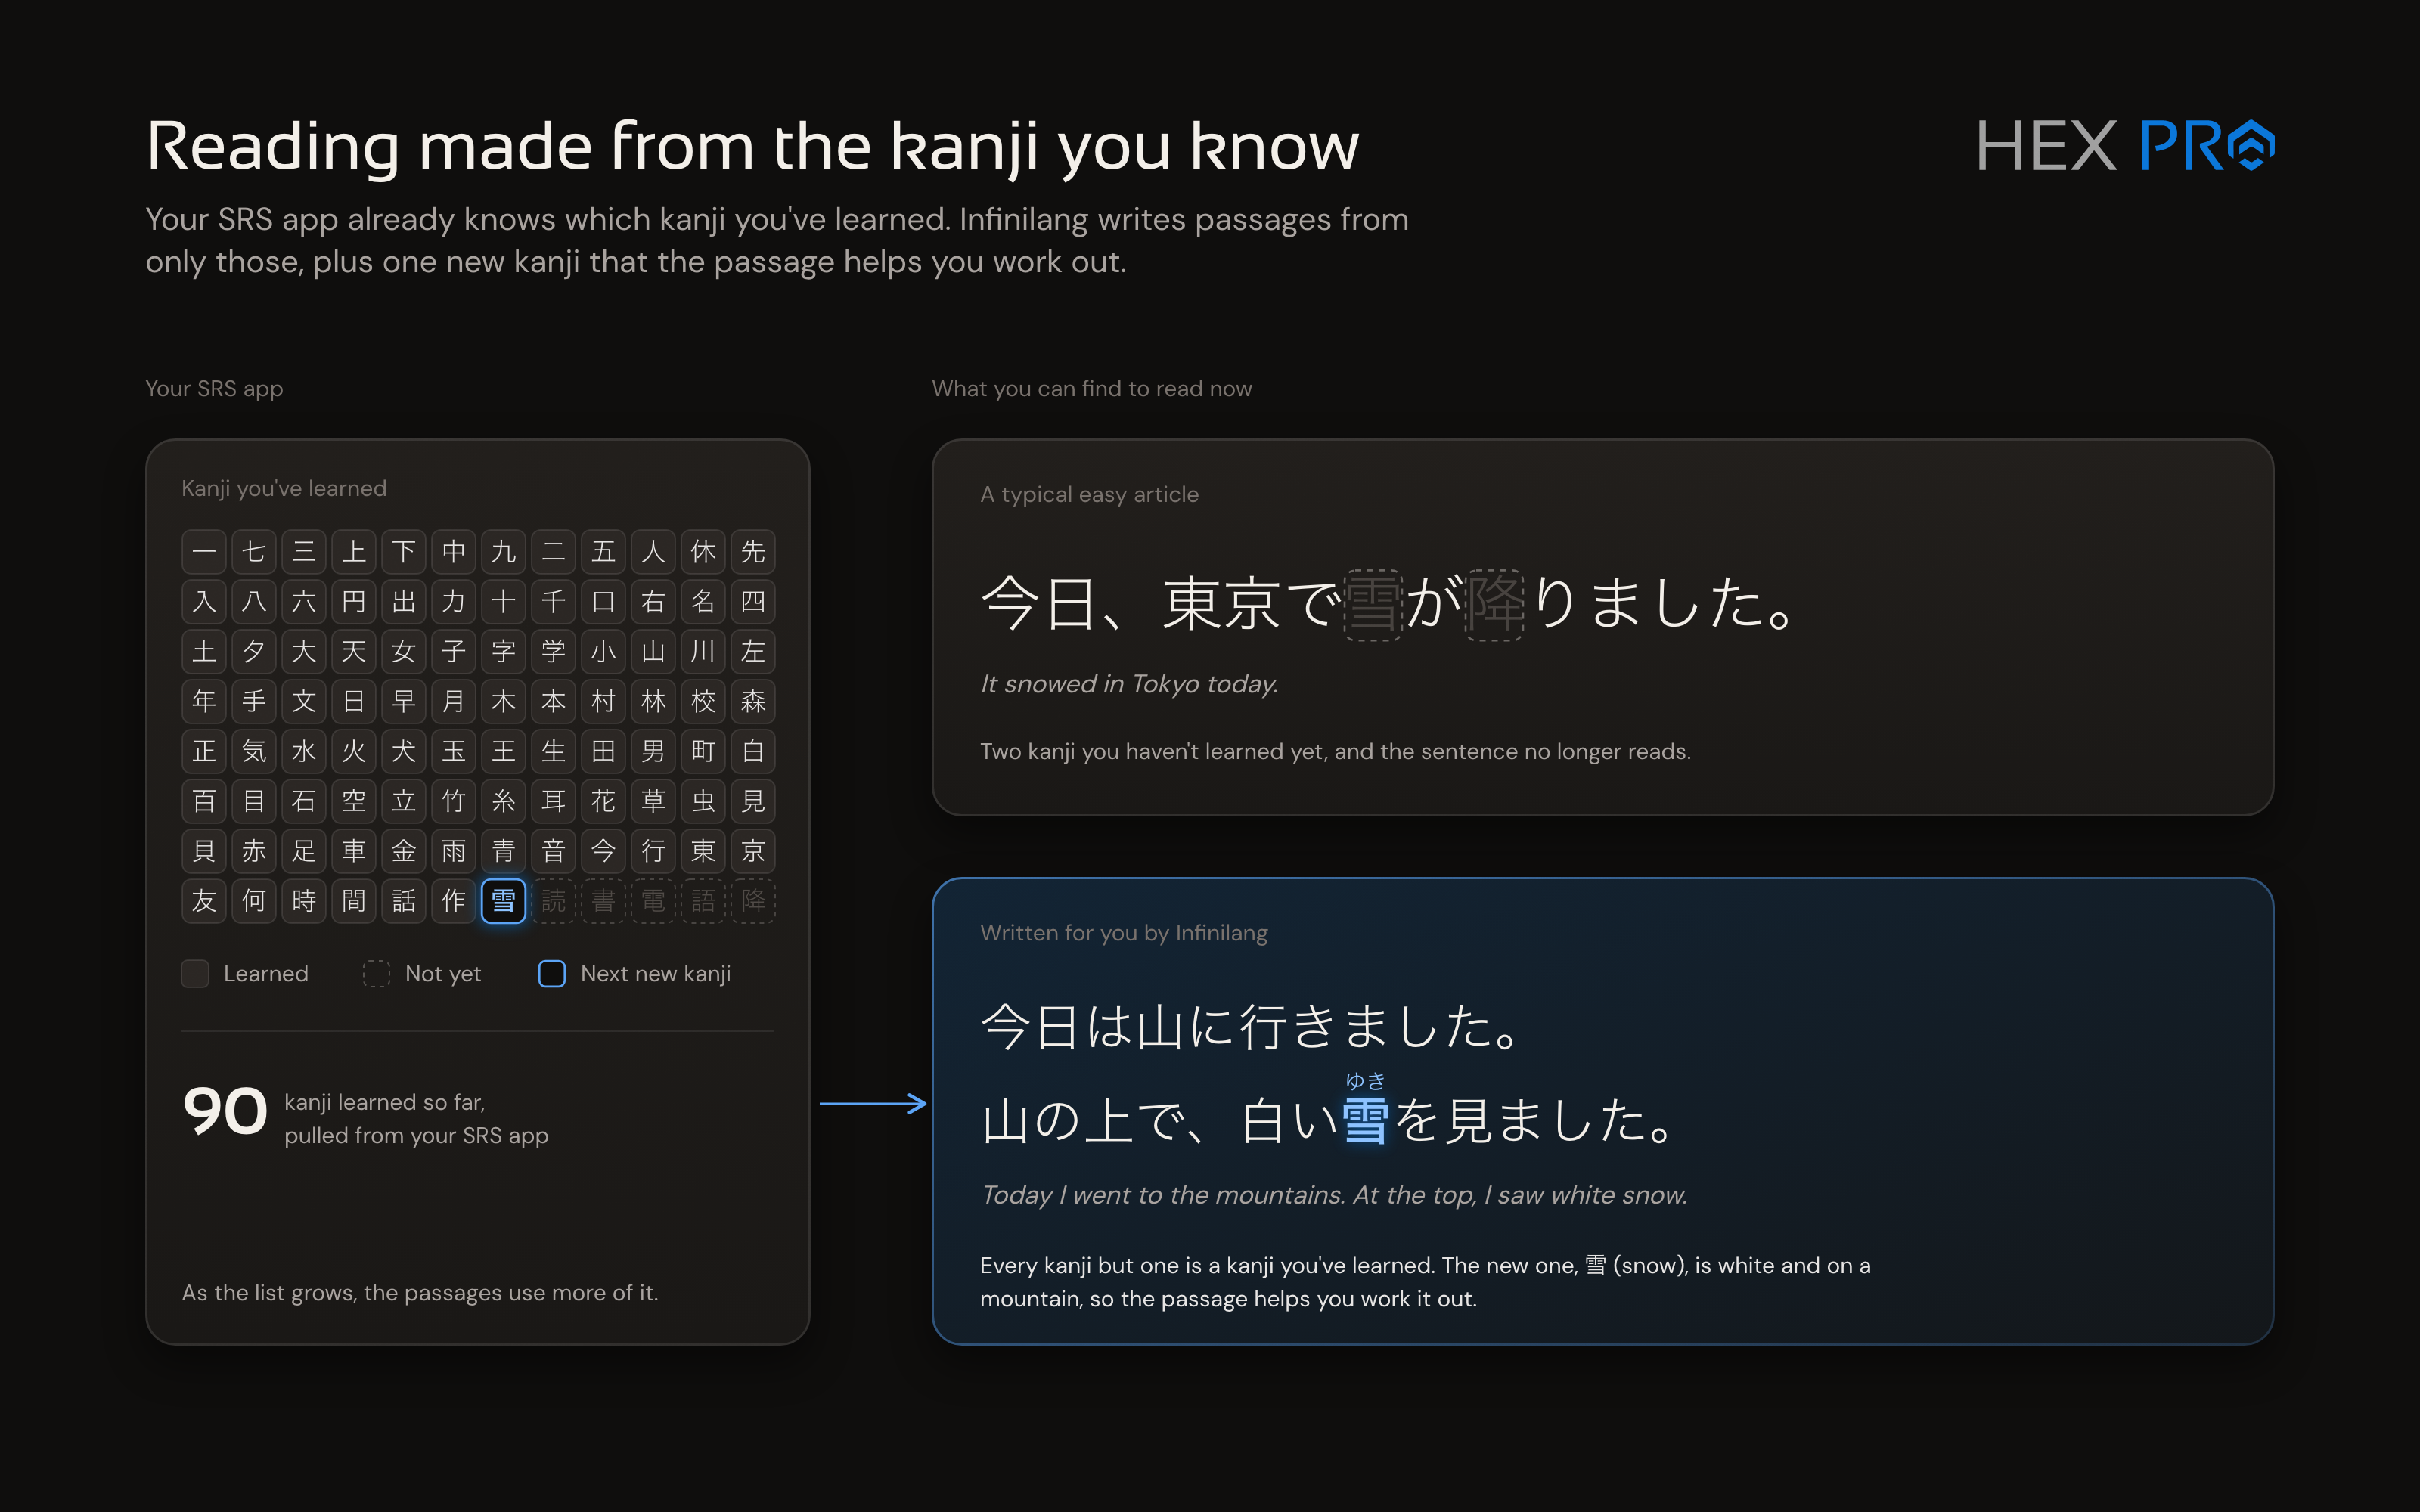
إذن إليك الفكرة. تطبيقات SRS توفّر نظام تتبّع ممتازاً لحروف الكانجي التي تعلّمتها ومدى إتقانك لكل منها. فماذا لو استطعت أن تجد مواد قراءة لا تتألف إلا من الكانجي الذي تعلّمته؟ هذا ما تقدر عليه النماذج اللغوية الكبيرة، وهنا يأتي دور Infinilang.
### توليد مواد قراءة يابانية مقيّدة
هدف Infinilang (المرحلة 1) هو إنتاج مواد قراءة مفصّلة بدقة على مستوى مهارة المستخدم. نزوّد نموذجاً لغوياً كبيراً بحروف الكانجي التي تعلّمتها، والتي تُسحب مباشرةً من تطبيق SRS الذي تستخدمه، ثم نولّد جملاً ضمن مجموعة الحروف المقيّدة. والأمر ليس بسهولة تلقيم النموذج اللغوي مجموعة الحروف والحصول على مواد قراءة رائعة. فترويض الذكاء الاصطناعي ليؤدي المهمة جيداً أصعب بكثير مما قد تتوقع. لكنه *يعمل* فعلاً.
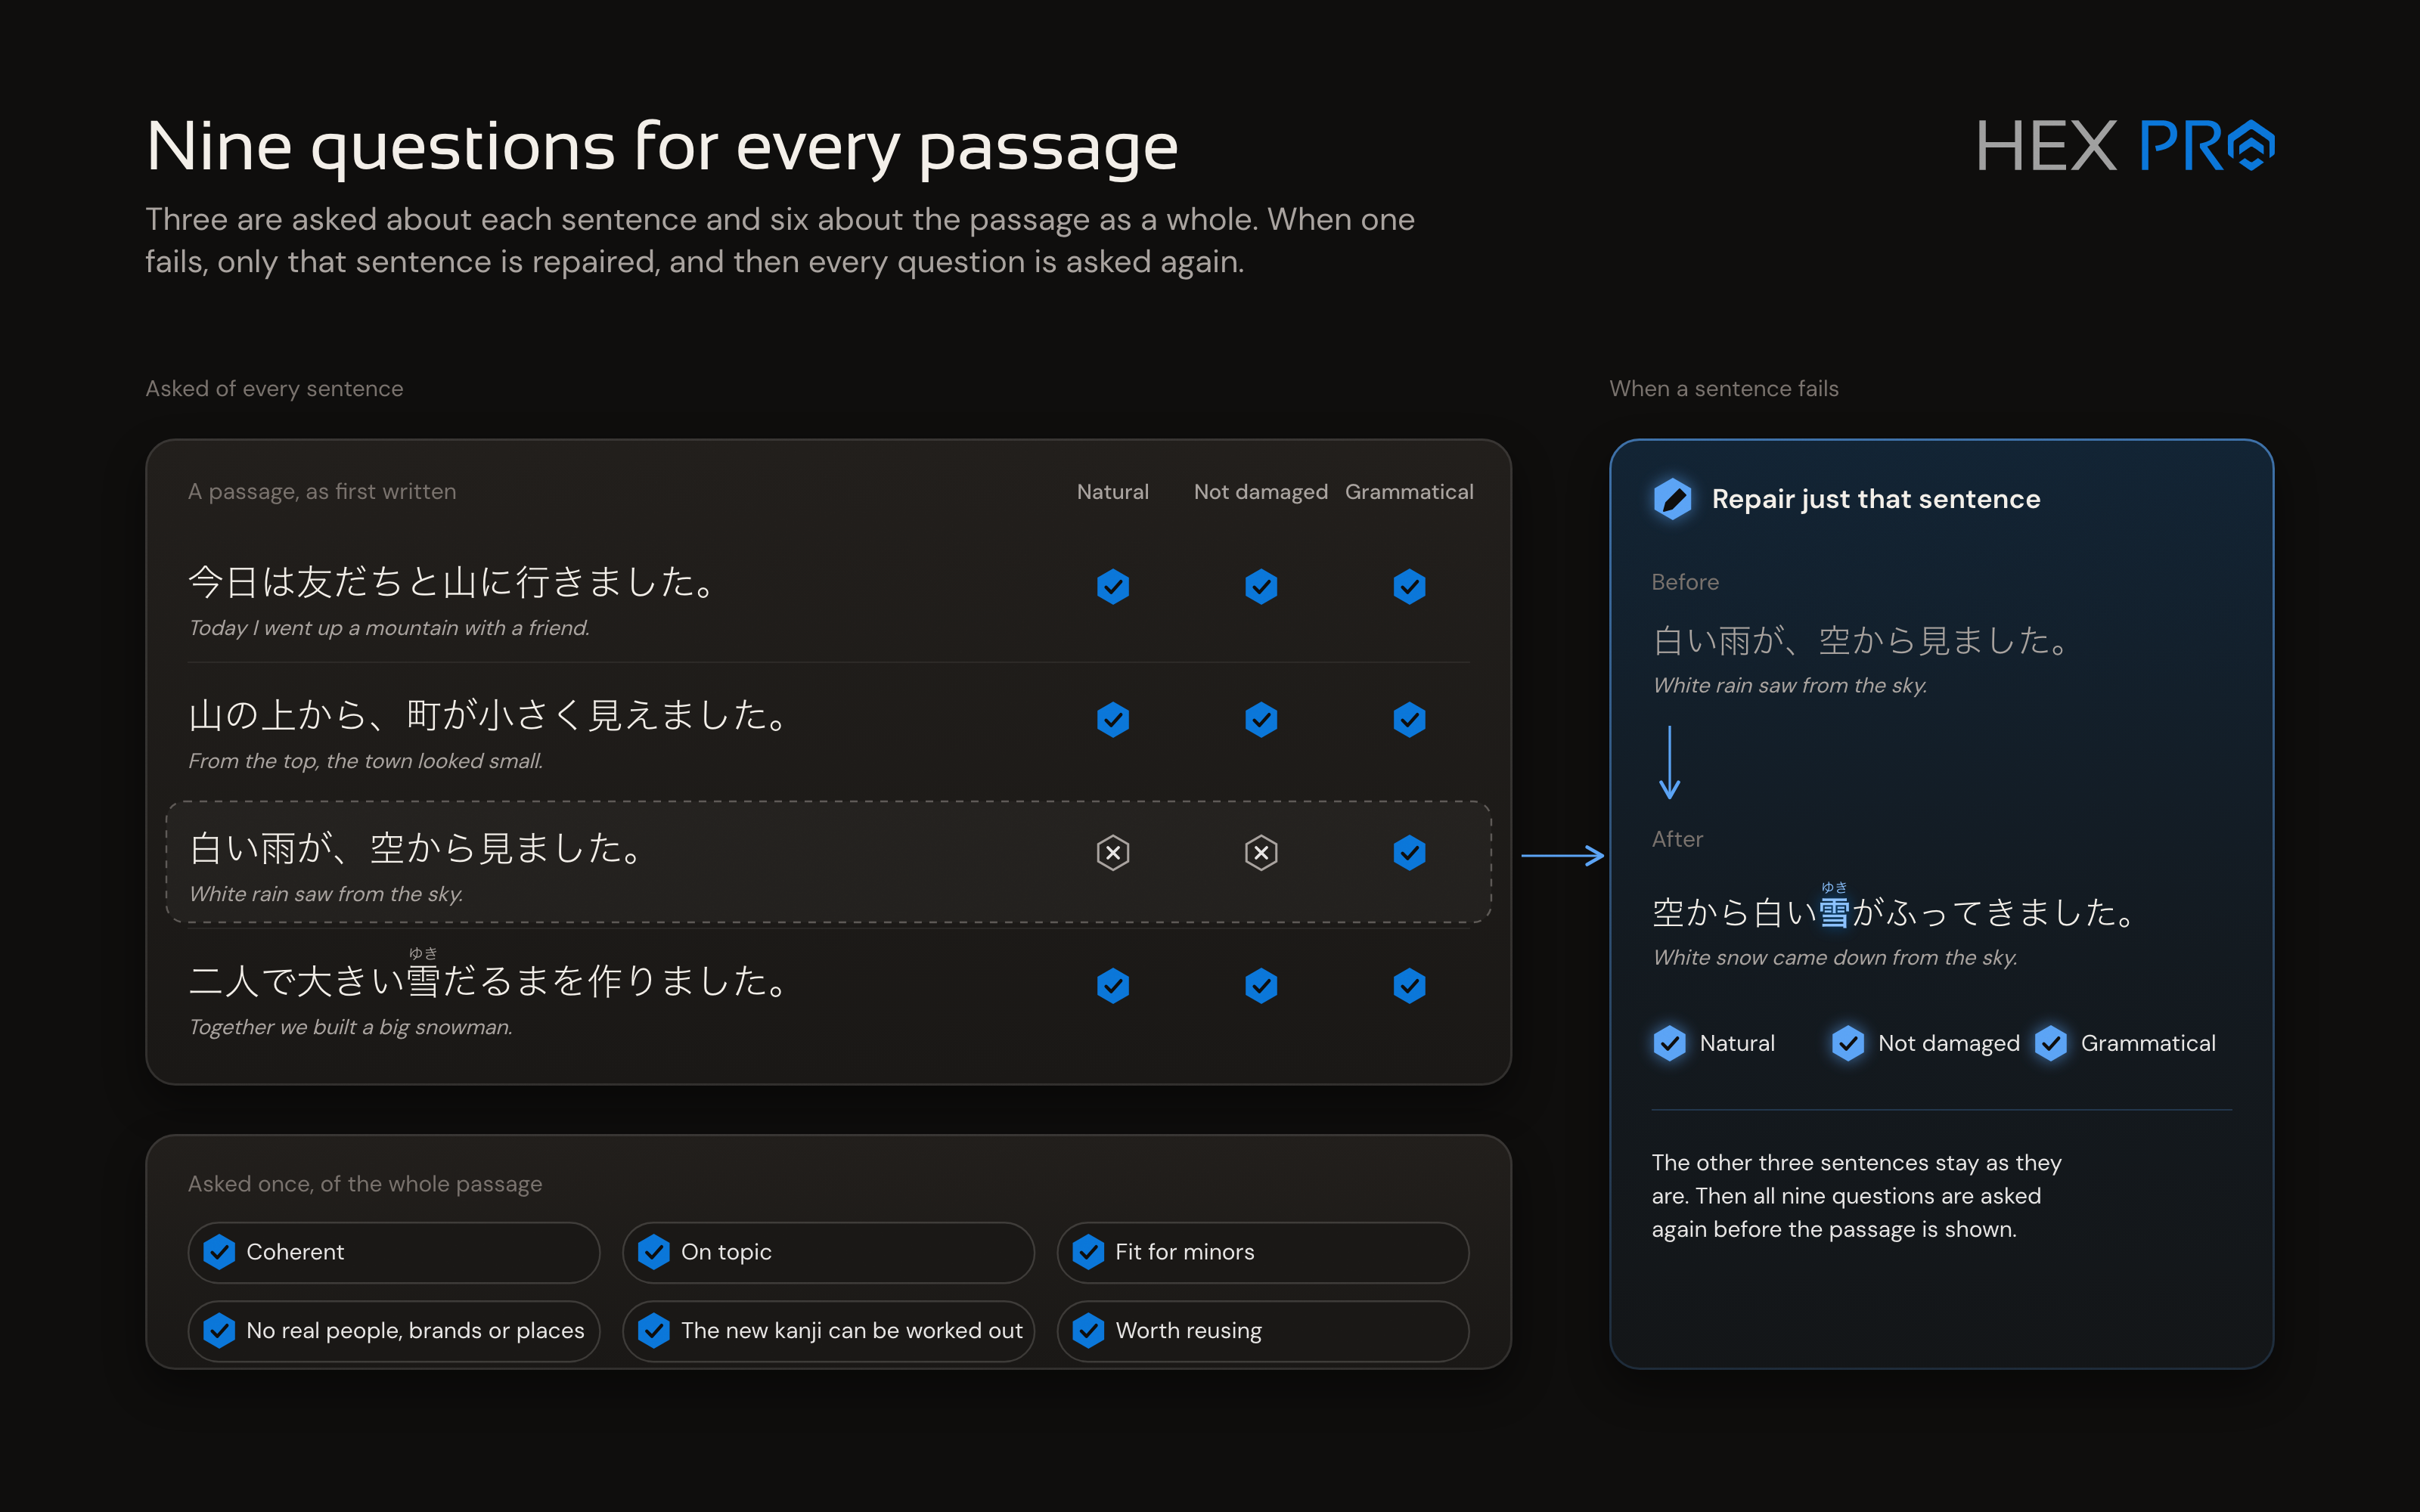
 وتندرج التحديات التي تواجه إنتاج مواد قراءة عالية الجودة ضمن عدد من الفئات، وهي في جوهرها أسئلة يجب طرحها للتأكد من أن النموذج اللغوي لم يخطئ، وإن أخطأ، فهل يمكننا إصلاح أخطائه دون توليد رد جديد كلياً.
- ما مدى طبيعية الجملة؟
- هل تبدو الجملة مفلترة أو تالفة؟
- هل المقطع مترابط؟
- هل يلتزم المقطع بالموضوع؟
- هل المقطع مناسب للقاصرين؟
- هل يحتوي على أشخاص أو علامات تجارية أو أماكن حقيقية؟
- هل يمكن استنتاج الكلمة المُدرجة بأسلوب N+1 من السياق؟
- هل يستحق المقطع إعادة استخدامه مستقبلاً؟
- هل الجملة سليمة نحوياً؟
هذه ليست قائمة شاملة، لكنها الأسئلة الرئيسية التي يجب طرحها حول المحتوى المولَّد.
### أرصدة، وأرصدة، والمزيد والمزيد من أرصدة API
من الأمور التي اتضحت جلياً منذ البداية أن استخدام واجهة API لنموذج لغوي من طرف ثالث سيُغرق المشروع من أوله. فأرصدة API ببساطة باهظة جداً، وستلتهم معظم إيرادات الاشتراكات. أو ما هو أسوأ، ستوقعنا فعلاً في الخسارة.
لم يكن هناك سوى حل واحد: أن نبني بنيتنا التحتية الخاصة للذكاء الاصطناعي. وليست مهمة سهلة على من يبني شركة ناشئة برأس مال محدود. والخبر السار أن النماذج اللغوية الأصغر تزداد قدرةً كل بضعة أشهر. هي بالتأكيد ليست في مستوى النماذج الرائدة، ولا أملك إلا أن أحلم بالعمل مع نموذج لغوي من فئة Opus. لكن مع بنية برمجية محددة النطاق بدقة ومدعومة جيداً (أي الكثير من الترويض)، تستطيع هذه النماذج الأصغر إنتاج مخرجات عالية الجودة.
لكن ذلك لا يحل مشكلة أن البنية التحتية صغيرة النطاق في البداية، وأن موارد الاستدلال ستكون محدودة مع آلاف المستخدمين الذين يولّدون المحتوى يومياً. ونحتاج أيضاً إلى توليد المحتوى بسرعة معقولة. فلا أحد يريد أن يجلس دقيقتين منتظراً ظهور فقرة باليابانية على شاشته، مهما كانت جيدة.
لذا قد تبدو مهام الاستدلال المطلوبة من الذكاء الاصطناعي في كل عملية توليد على هذا النحو:
1. توليد جملة أو فقرة أو قصة قصيرة ضمن القيود. وهذا يتطلب على الأرجح شيئاً من التفكير، وكلما طال المحتوى زاد الوقت الذي يستغرقه.
2. تقييم المادة المنتجة بناءً على فئات الأسئلة المذكورة أعلاه.
3. تمرير الجمل عبر جولات إصلاح جراحية مركّزة حيث تعذّر تطبيق الإصلاحات برمجياً.
4. تكرار الخطوة 2 مرة أخرى.
5. وربما تكرار الخطوة 3 والخطوة 2 مرة أخرى قبل إرسال المحتوى إلى المستخدم.
 وحتى مع GPU من فئة المؤسسات والتخزين المؤقت للبادئات، قد تستغرق هذه العملية دقيقة أو دقيقتين، ولا نملك سوى 8 خانات للاستدلال المتوازي، ما يعني أن المهام يجب أن تنتظر في طابور حين يحاول أكثر من 8 أشخاص التوليد في آن واحد. وهذا غير عملي بأي معنى.
وهنا تدخل نماذج System One إلى الصورة.
## كيف غيّر Jev كل شيء
تتمتع نماذج System One ببضع مزايا أساسية على النماذج اللغوية التقليدية، تجعلها مناسبة للغاية لحالات استخدام مثل حالتي.
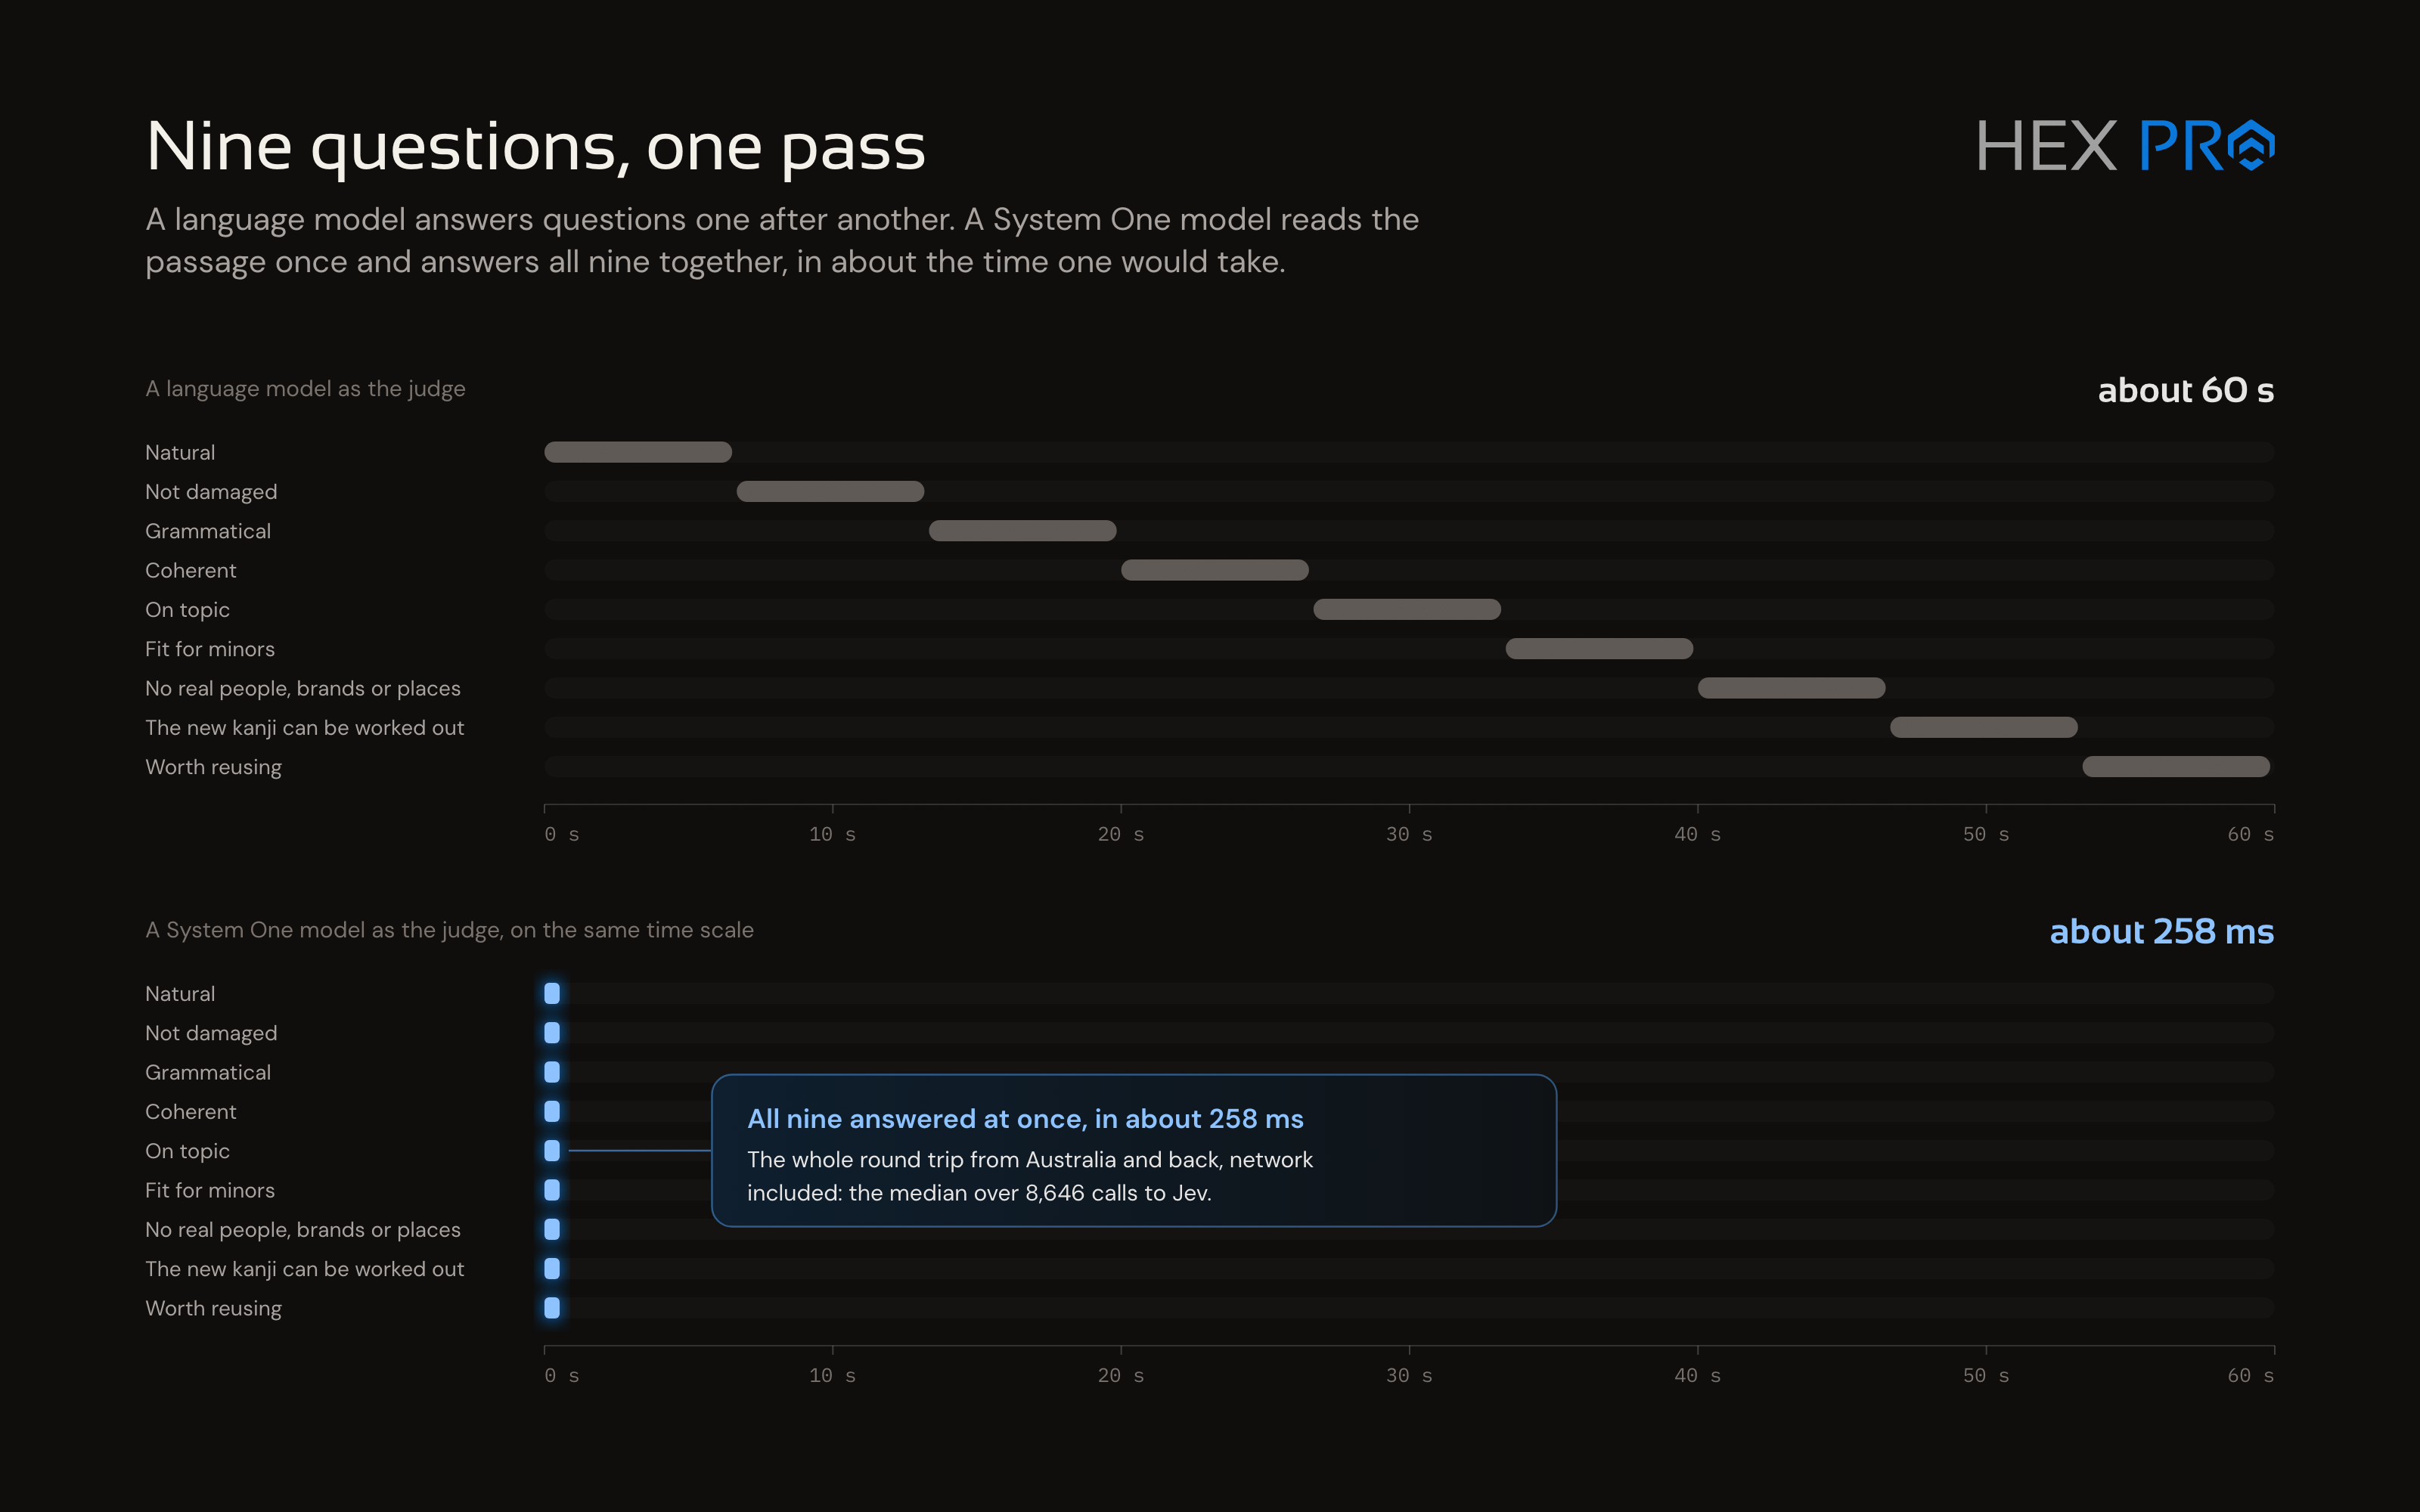
1. تقدّم استجابات فائقة السرعة. أنا مقيم في أستراليا وJev يعمل من وادي السيليكون، ومع ذلك يعود رد الاستدعاء في نحو 258 ملّي ثانية، بما في ذلك زمن الاتصال (ping). وهذه ميزة هائلة مقارنةً بالنماذج اللغوية التقليدية.
2. تجيب عن أسئلة كثيرة بالتوازي. فعلى عكس النموذج اللغوي الذي يحتاج إلى معالجة كل سؤال بالتتابع، تستطيع نماذج System One أن تتلقى مجموعة من الأسئلة وتجيب عنها في نحو الوقت الذي يستغرقه سؤال واحد. أي إنه إذا استغرقت الإجابة الفعالة عن تسعة أسئلة بنموذج لغوي **60 ثانية**، فلن تستغرق الإجابة عن الأسئلة التسعة نفسها بنموذج System One سوى **258 ملّي ثانية**. وكلما زاد عدد الأسئلة التي تحتاج إلى طرحها، زادت الفائدة التي تجنيها من أداة مثل Jev.
 3. رخيصة إلى حد لا يُصدَّق. خلال هذا المشروع، لم أنفق على Jev سوى **0.025 دولار أمريكي** لكل 1000 استدعاء. ومن الدروس المستفادة أن تشغيل Jev **اقتصادي للغاية**. ولن أتردد في دمجه في كل مكان، فهو مجاني عملياً.
وثمة ميزة أخرى لا تحظى بحقها من الاهتمام: الموثوقية. فبعض النماذج اللغوية تخرج عن السيطرة في ردودها وتقدّم ردوداً غير منظمة لا يمكن معالجتها برمجياً. أما Jev فهو «typesafe»، أي آمن من حيث الأنواع، بمعنى أنه يقدّم دائماً رداً صالحاً يمكن تحليله.
## Laya: المنافس مفتوح المصدر
وهذا يقودني إلى Laya، موضوع هذه التجربة، وعلى الأرجح السبب الذي يجعلك تقرأ هذا المقال أصلاً. ففي غضون يومين من إطلاق Jev للعامة، ظهر سيل من المحاولات مفتوحة المصدر لإعادة بناء هذه التقنية.
> https://github.com/NandhaKishorM/laya
حصد Laya عدداً مذهلاً بلغ 35,000 نجمة على GitHub حتى وقت كتابة هذه السطور، ودخل الساحة بقوة وسرعة، بأكثر من 1000 إيداع (commit) في غضون أسبوعين، ونحو 3000 حتى وقت الكتابة. إطلاق مثير للإعجاب حقاً، وقد أظهر مدى اهتمام مجتمع هندسة البرمجيات بنماذج System One.
أتى Laya بثلاثة نماذج أساسية: `laya (421M)` و`laya-multilingual (322M)` و`laya-typed-decisions (421M)`. وباختصار، `laya` هو النموذج متعدد الاستخدامات، و`laya-multilingual` أفضل للغات غير الإنجليزية لكنه أضعف دقةً، و`laya-typed-decisions` أعلى دقةً على حساب مرونة أقل في المواقف المختلفة وقدرة ضعيفة على التعامل مع لغات متعددة.
### مزايا Laya
أوضح مزايا Laya أنه مفتوح المصدر، وأنك تتحكم في البنية التحتية. فلا داعي للقلق من أن يُفلس Laya فجأة ويُغلق خوادمه، فتضطر إلى سباق محموم للعثور على بديل مناسب، أو تواجه انهياراً كارثياً في برمجياتك. وهذا حافز جذاب لشركات مثل شركتي تسعى إلى التوسع الكبير وتريد تقليل المخاطر.
والميزة الأخرى لـ Laya هي صغر حجم النموذج. فهو افتراضياً يحتاج إلى قدر ضئيل جداً من VRAM ليعمل، بل يمكنه العمل على وحدة المعالجة المركزية (CPU) بحسب [ملف README.md الضخم المولَّد بالذكاء الاصطناعي](https://github.com/NandhaKishorM/laya/blob/main/README.md). وأعتقد أن النموذج الأساسي كان يعمل في تجاربي على 2GB من VRAM، فاستوعبته بنية خوادمي التحتية بسهولة.
### العيوب غير الواضحة
حين يبدو شيء ما أجمل من أن يكون حقيقياً، فهو كذلك في الغالب. فالإحصاءات والمقارنات مع Jev الموجودة على [صفحة GitHub](https://github.com/NandhaKishorM/laya/blob/efbe194/BENCHMARKS.md) تطرح ادعاءات كهذه:
| | Laya | Jev (الأرقام المنشورة) |
|---|---|---|
| typed-decisions (2,000 قرار) | **0.766** | 0.727 |
| AG News (4 تسميات) | **0.953** | 0.910 |
| DAIR Emotion (6 تسميات) | **0.600** | 0.480 |
| ECE بعد ضبط معامل الحرارة | **0.081** | 0.246 |
| زمن الاستجابة p50، سؤال واحد (T4) | **32.8 ms** | 236-276 ms |
يبدو مقنعاً جداً في نظري. فأين الخدعة إذن؟ ألقِ نظرة على المواضيع التي اختُبرت عليها نماذج Laya.
| الموضوع | laya | laya-multilingual | laya-typed-decisions | البيانات |
|---|---|---|---|---|
| البريد العشوائي | **0.993** | 0.993 | 0.958 | ضمن التدريب |
| التصيّد الاحتيالي | 0.980 | **0.993** | 0.940 | ضمن التدريب |
| حواجز حماية النماذج اللغوية (كسر القيود) | 0.708 | 0.755 | **0.762** | **مستبعدة من التدريب** |
| الإشراف على المحتوى (السُّمّية) | **0.530** | 0.525 | 0.530 | **مستبعدة من التدريب** |
| صلة المقاطع في RAG | 0.625 | **0.657** | 0.625 | ضمن التدريب |
| فرز طلبات الدعم (10 طوابير) | 0.502 | **0.522** | 0.505 | ضمن التدريب |
| توجيه النماذج (حسب المجال) | 0.639 | 0.123 | **0.659** | مستبعدة من التدريب |
«البريد العشوائي» و«التصيّد الاحتيالي» و«صلة المقاطع في RAG» و«فرز طلبات الدعم»: هذه مواضيع محددة للغاية ووثيقة الصلة بالعيوب. وستلاحظ أن «حواجز حماية النماذج اللغوية» و«الإشراف على المحتوى» و«توجيه النماذج» موسومة بـ «مستبعدة من التدريب»، وهذا فارق مهم.
ببساطة، Laya ليس نموذجاً جاهزاً لأي مهمة. *لا يمكنك* أن تأخذه وتضعه في أي حالة استخدام. فهو بحالته الأصلية يملك قدرات محددة جداً، وعديم الفائدة عملياً في كل ما عداها. وهذا أول موضع يُظهر فيه Jev قدراته حقاً: «إنه يعمل وحسب». كانت اختباراتي الأولى مع Infinilang ونموذج `laya-multilingual` إخفاقاً تاماً، إذ لم يتمكن من أداء **أيٍّ** من المهام المطلوبة بدرجة كافية.
## تدريب نموذج مخصص لـ Laya: infini-jp-v1
بعد الإخفاق الأول، لم أستسلم على الفور. فبما أن kcalc.ai وInfinilang لا يزالان بعيدين بعض الشيء عن مرحلة الإنتاج، لديّ بنية خوادم قوية تقبع هناك شبه معطّلة. أي إن Qwen 3.8 27B قابع هناك ينتظر عملاً يؤديه، ويمكنني إيقافه للتدريب كلما احتجت إلى وحدة GPU قوية. لقد حان وقت بعض التجارب.
### القواعد الأساسية
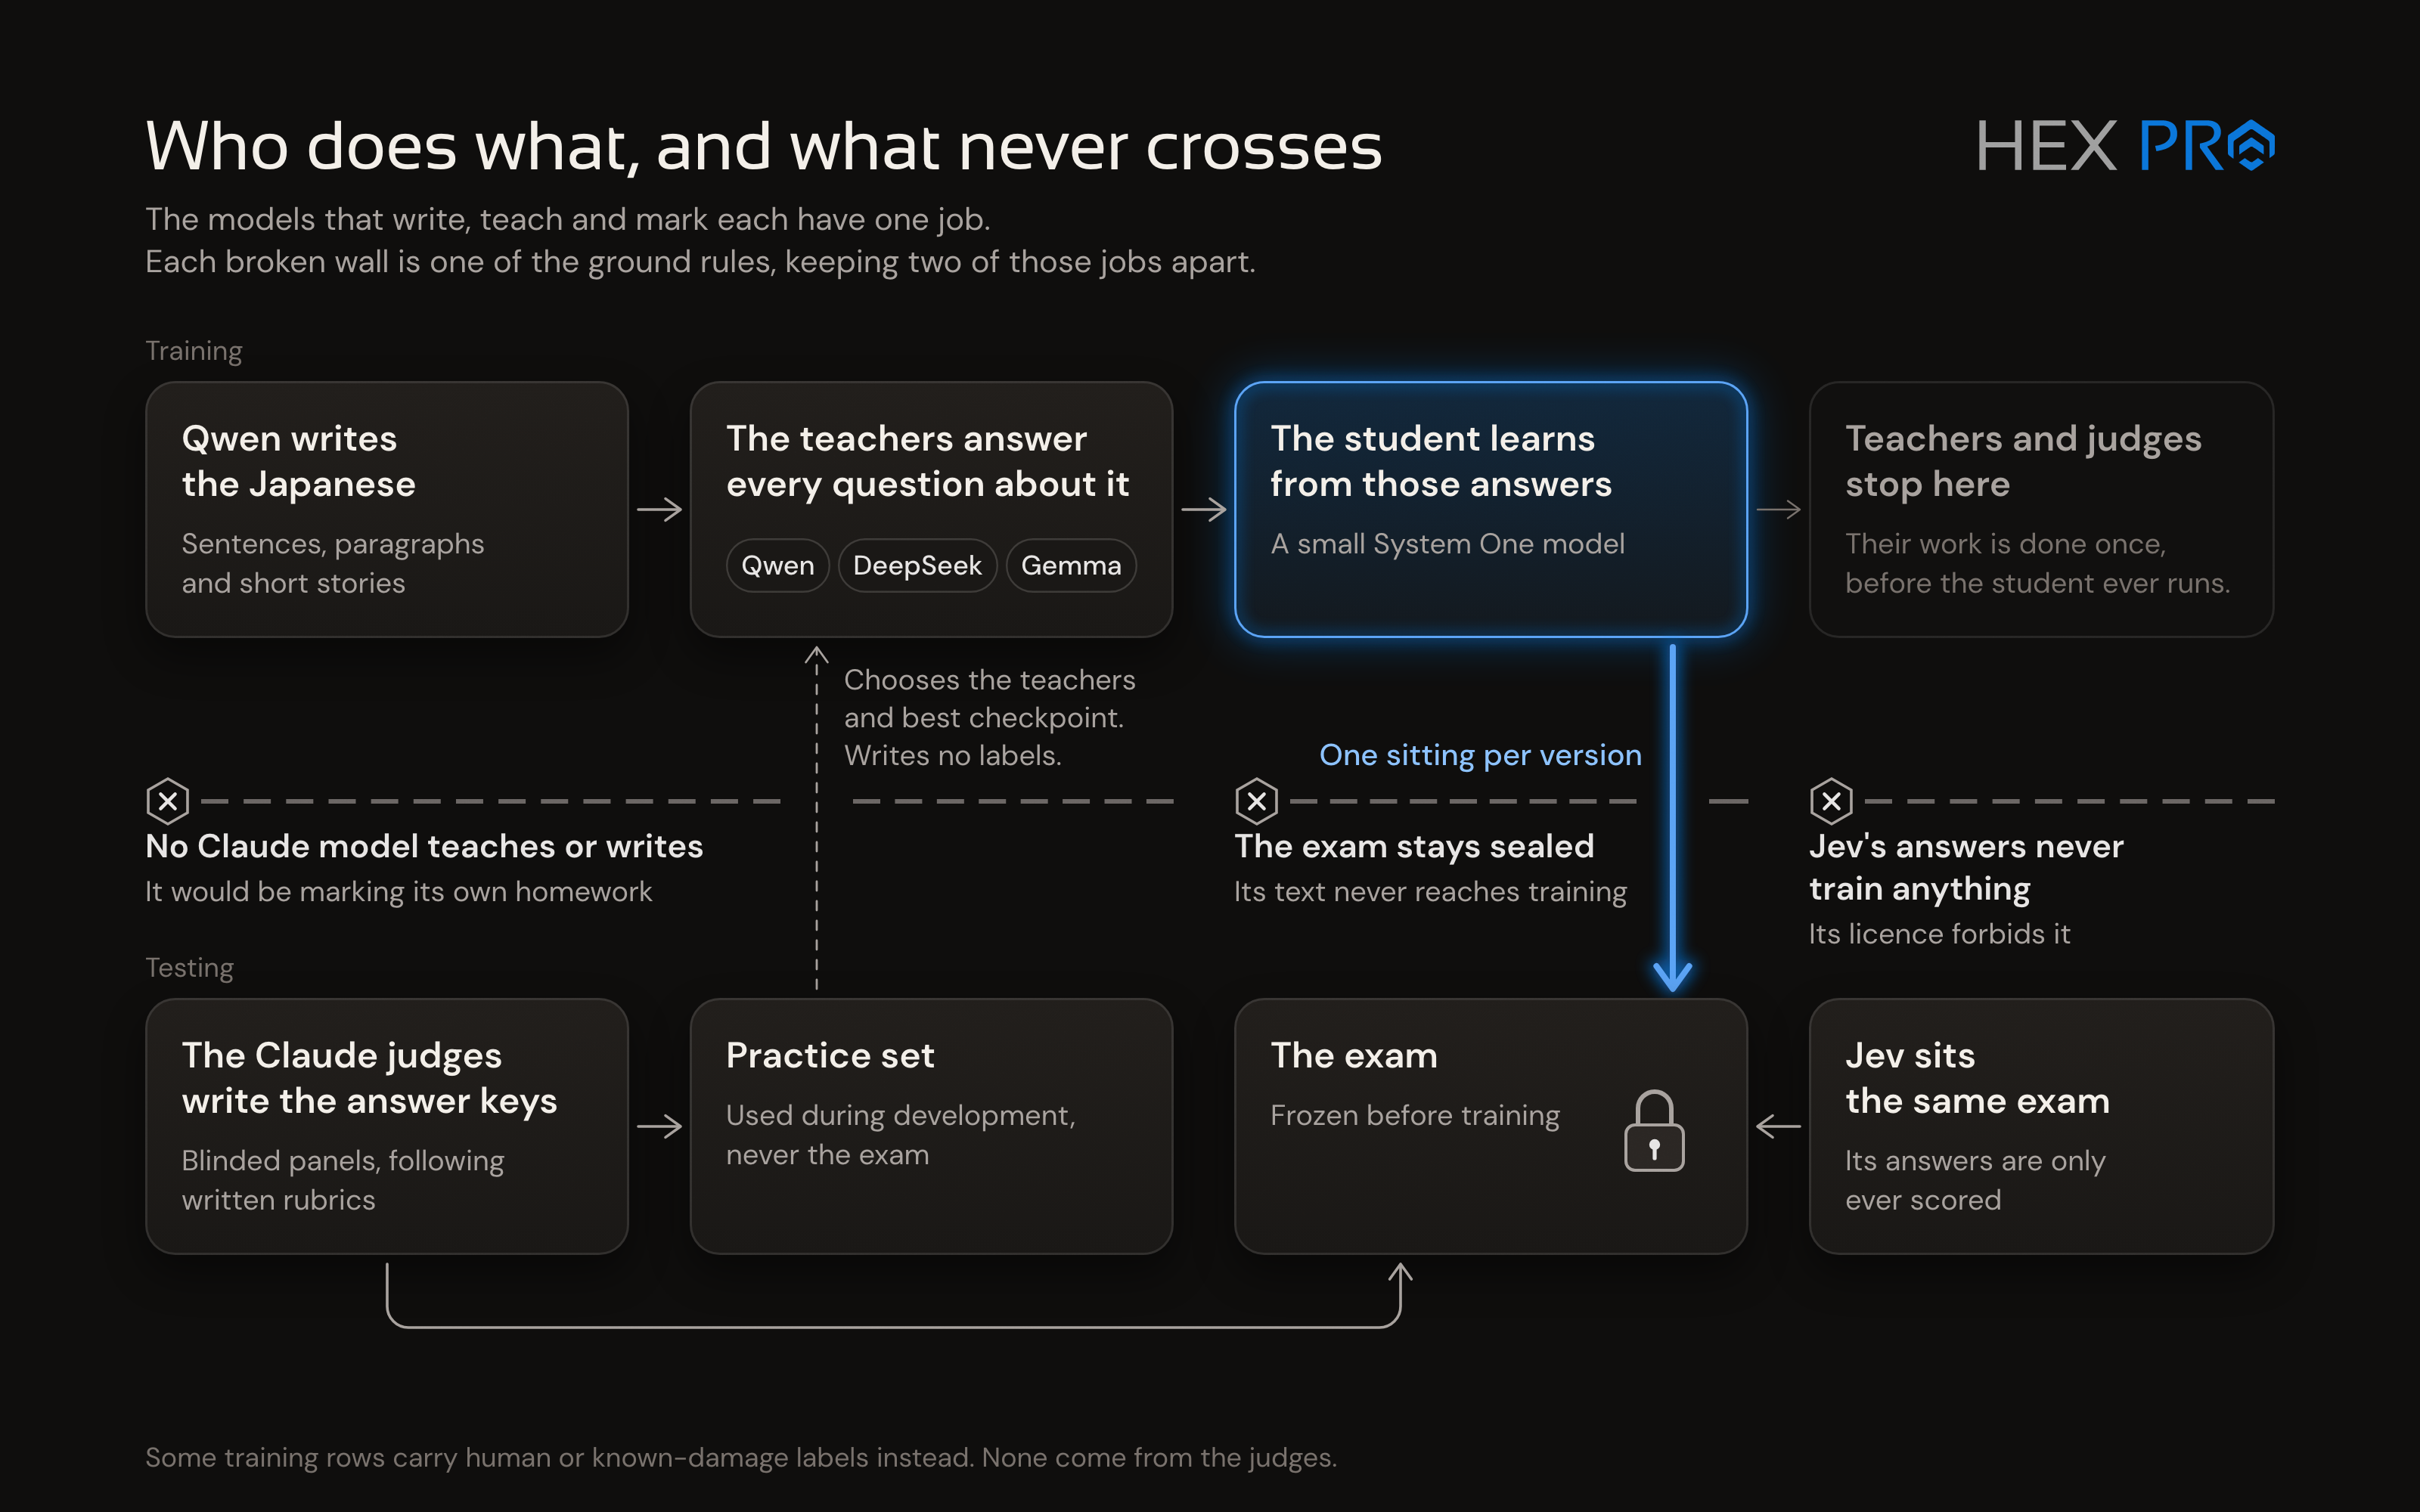 | القاعدة | السبب | كيف طُبّقت |
| --- | --- | --- |
| مخرجات Jev لا تدرّب أي شيء أبداً | ترخيص TypeSafe يحظر التقطير | عقود استيراد في الشفرة، وخطاف تدقيق يرفض أي قارئ لـ `quarantine/` باستثناء وحدة التقارير، وتعداد (enum) لمصادر التسميات لا يضم Jev |
| لا معلّم ولا مولّد من Claude | المعيار الذهبي لجنة من Claude؛ والمعلّم من Claude سيصحّح واجبه بنفسه | حارس استقلالية يتحقق من العائلة والنسب المعلن ومعرّف النموذج والمضيف. تحظر Anthropic استخدام نماذجها للتدريب، لذا استخدمنا نماذج مفتوحة الأوزان للتدريب. |
| الاختبار المعياري يُستهلك بحذر | كل اطلاع على المعيار الذهبي للاختبار يُضعفه | محاولة واحدة لكل إصدار في كل اختبار معياري، ورمز مالك أحادي الاستخدام لكل محاولة، وسجل وصول بسلسلة تجزئة، ولا يُتّخذ أي قرار بناءً على أرقام الاختبار المعياري |
وفي الواقع، ثمة عقبات قانونية جدية أمام تدريب نماذج الذكاء الاصطناعي. وعلى Hex Pro، بوصفها كياناً قانونياً، أن تلتزم بهذه القوانين بدقة. لذا بذلت جهداً كبيراً لأضمن التزامي بجميع متطلبات الترخيص.
### التجربة 1: Qwen 3.8 معلّماً
كانت التجربة الأولى بسيطة نسبياً. وكان الهدف معرفة ما إذا كان نموذج مدرَّب قادراً على بلوغ عتبة محددة مسبقاً.
1. ولّد Qwen 3.8 ما مجموعه 1,995 مثالاً باليابانية بالطريقة نفسها التي يتطلبها النموذج الأولي لـ Infinilang.
2. قيّم Claude Opus كل مخرَج بلجان من 3 مقيّمين عبر ست فئات، فأعطانا ذلك «المعيار الذهبي» الذي نقيس عليه.
3. ووسم Qwen 3.8، بصفته المعلّم، بيانات التدريب بتقييماته الخاصة للفئات الست نفسها.
وكانت الفئات الست في التجربة الأولى:
- **S1**: مدى طبيعية الجملة، **درجة من 5** (المقياس: [Spearman](https://en.wikipedia.org/wiki/Spearman%27s_rank_correlation_coefficient))
- **S2**: الجملة تبدو مفلترة أو تالفة، **نعم أو لا** (المقياس: [pAUROC](https://en.wikipedia.org/wiki/Partial_Area_Under_the_ROC_Curve))
- **S3**: الترجمة الإنجليزية أمينة، **نعم أو لا** (المقياس: pAUROC)
- **P1**: أفضل مرشحي الإصلاح الثلاثة أو لا أحد منهم، **اختيار من 4** (المقياس: التوافق مع المعيار الذهبي)
- **P2**: هل أي من مرشحي الإصلاح مقبول؟ **نعم أو لا** (المقياس: pAUROC)
- **G1**: الجملة سليمة نحوياً، **نعم أو لا** (المقياس: pAUROC)
كانت النتيجة مخيّبة للآمال. وأبرز ما لفت النظر كان S1 (الطبيعية)، الذي كان عليه بلوغ عتبة [Spearman](https://en.wikipedia.org/wiki/Spearman%27s_rank_correlation_coefficient) عند 0.60، لكنه قصّر عنها عند 0.452. وكانت غريزتي الفورية أن أتخلى عن فكرة تدريب Laya عند هذا الحد. كنت قد أمضيت عليها نحو يوم ونصف حتى تلك اللحظة، ولم تكن تلك النتائج جيدة بما يكفي.
فأوقفت التجربة هناك، إذ لم تكن تستحق الوقت. تشغيل Jev رخيص جداً، وتدريب نموذج سيكلّف أضعافاً مضاعفة مما سيكلّفه Jev في 5 سنوات من الاستخدام المكثف. وفي وقت لاحق من ذلك اليوم، قررت على سبيل النزوة أن أختبر Jev في التجربة نفسها، فوجدت شيئاً مثيراً للاهتمام *جداً*.
| الفئة | المعلّم | Jev | المقارنة | المعايرة (الثقة) |
|--------|--------:|----:|-----------:|------------------------:|
| S1 (Spearman) | 0.452 | 0.446 | +0.006 | Jev أفضل بنسبة 20.4% |
| S2 (AUROC) | 0.920 | 0.900 | +0.02 | Jev أفضل بنسبة 64.9% |
| S3 (AUROC) | 0.972 | 0.983 | -0.011 | المعلّم أفضل بنسبة 36% |
| P1 (التوافق) | 0.874 | 0.75 | **+0.124** | Jev أفضل بنسبة 14.5% |
| P2 (AUROC) | 0.878 | 0.849 | +0.029 | Jev أفضل بنسبة 75.7% |
| G1 (AUROC) | 0.782 | 0.766 | +0.016 | Jev أفضل بنسبة 72.5% |
***يا للهول!*** مهلاً مهلاً. ما هذه الأرقام؟ كان المعلّم على قدم المساواة مع Jev في جميع المقاييس، بل حقق فوزاً كبيراً في الاختيار بين مرشحي إصلاح الجمل. لكن الرقم الذي أقنعني أكثر من غيره كان 0.446 في S1. *فحتى Jev لم يبلغ عتبة 0.6.*
أعادت تلك النتائج الحياة إلى المشروع، فسعيت فوراً إلى البناء عليها. فبمحاولة سطحية، كنت قد عادلت Jev في مهام Infinilang تلك. وكان هناك موضع واحد ظل فيه Jev لا يُهزم طوال الوقت، وهو *المعايرة*. فبينما كانت النتائج الفعلية متينة مع Laya، تتفوق درجة «الثقة» التي يقدّمها Jev تفوقاً كبيراً من كل النواحي. فتقييم Jev متعدد الأبعاد، وهو *يعرف* متى يكون متأكداً من شيء ومتى لا يكون. وهذا مهم جداً لنموذج جاهز يمكن إدراجه في أي مهمة. أما لنموذج مصمَّم لمجموعة محددة جداً من المهام، فرقم المعايرة ذاك أقل ضرورة.
### التجربة 2: المفاضلة والتحسين
عند هذه النقطة، أُغلقت التجربة 1 وجُمّدت الاختبارات المعيارية. كان المال على وشك أن يُنفق، والأمور على وشك أن تصبح جدية. وصار الهدف الآن تحقيق تقدّم كبير على قدرات Jev في مهام Infinilang. ورأيت ثلاث طرق لتحسين نتائج التجربة 1.
1. مزيد من بيانات التدريب
2. نماذج لغوية أفضل
3. سلّم تقييم أكثر تنوعاً
وعند هذه النقطة، تقرر ألا أُجري اختبارات Jev المعيارية إلا *بعد* أن أجمع كل النتائج. فما إن أفتح اختبار Jev المعياري حتى أضطر إلى الانتقال إلى مجموعة بيانات جديدة لإبقاء Jev معزولاً.
كانت الخطوة الأولى فرز معلّمين بدلاء. كنت أبحث عن نماذج إما أكبر بكثير، وإما قد تؤدي أداءً أفضل مع قيود اليابانية في Infinilang. وكان المرشحون:
- DeepSeek V4.1: نموذج تفكير ضخم وقدير، باستدلال رخيص نسبياً. ونتائج قوية في اليابانية.
- Gemma 4 31B: اختُبر للنموذج الأولي لـ Infinilang، وتميّز بتجنّب تسرّب الكانجي غير المسموح به. وهو أيضاً صغير بما يكفي ليعمل على بنية خوادمي، فاختباره مجاني عملياً.
- Qwen 3.8 Flash Next: هو في الأساس نسخة تجريبية من Qwen 4. إنه نموذج من نوع خليط الخبراء ([MOE](https://en.wikipedia.org/wiki/Mixture_of_experts))، ما يجعله أكبر بكثير وأوسع معرفةً من Qwen 3.8 27B.
- Hy3 وInkling-Small: نموذجان أقل شهرة ظننت أنهما *قد* يملكان قدرات جيدة في اليابانية.
واستُبعدت نماذج أخرى، غالباً لأن تراخيصها لا تسمح باستخدامها في التدريب.
#### المفاضلة
استُبعد Qwen 3.8 Flash Next أولاً. فالمشكلة الكبرى كانت خطر التحيّز للذات، لأنه من العائلة نفسها التي ينتمي إليها المولّد (Qwen 3.8 27B). ومن المفيد الاطلاع على [*Extreme Self-Preference in Language Models*](https://arxiv.org/html/2509.26464v2) (Steven A. Lehr وMary Cipperman وMahzarin R. Banaji، 2026)، وهي دراسة أثبتت أن النماذج اللغوية الكبيرة تحب مخرجاتها وتميل إلى انتقاد مخرجات غيرها.
> *«التحيّز للذات سمة أساسية في الكائنات الحية. ولأن النماذج اللغوية الكبيرة (LLMs) تفتقر إلى الوعي، قد يُتوقع منها أن تتجنب مثل هذه التشوهات. ومع ذلك، وجدنا عبر 72 تجربة ونحو 41,000 استعلام تحيّزات هائلة للذات لدى ثمانية نماذج لغوية كبيرة واسعة الاستخدام.»*
كان خطر أن يؤثر التحيّز للذات في النتائج مرتفعاً جداً، وقد أظهرت الاختبارات أن نتائجه كانت متوافقة إلى حد كبير مع نتائج Qwen 3.8 27B على أي حال. ولم يكن من المنطقي أن أستثمر مالاً حقيقياً في نموذج يحمل هذا النوع من المخاطر، بينما يمكنني استخدام نسخة 27B مجاناً والحصول على نتيجة مماثلة.
ثم خرج Hy3 وInkling-Small. لا يوجد الكثير ليقال هنا. كانا مكلفين ولم يحققا نتائج أفضل من أي نموذج آخر.
تميّز DeepSeek V4.1 بوضوح على كل الأصعدة. وجاءت النتائج أبعد بكثير مما توقعت. لطالما كان انطباعي أن DeepSeek مجرد نموذج صيني مقلَّد رديء الجودة سرق كل شيء من OpenAI وAnthropic. ومع أن الشق الأخير صحيح على الأرجح، فإنه لم يعد رديء الجودة. لقد كان بوضوح أفضل نموذج مفتوح الأوزان يسمح أيضاً بالتدريب على بياناته. بارك الله في الصينيين.
وكان Gemma 4 آخر النماذج. في معظم الفئات، هيمن DeepSeek. وبلغ Gemma 4 مستوى DeepSeek في معظم النواحي، وتميّز خصوصاً في S3 (أمانة الترجمة). وأدى أداءً جيداً أيضاً في P2 (قبول أي إصلاح) وB2 (الالتزام بالموضوع). وبما أن اختباره مجاني، قررت أنه يستحق المضي معه.
وهكذا ستُجرى جميع الاختبارات اللاحقة على Qwen 3.8 27B وGemma 4 31B وDeepSeek V4.1.
#### تحسين سلّم التقييم
كانت التجربة الأولى تضم مجموعة محدودة من الفئات، لكن هناك طرقاً أكثر بكثير يمكن أن يُستخدم بها هذا النموذج داخل Infinilang، وأردت أن أتأكد من تدريبه على كل مهمة سيحتاج إلى أدائها.
تألّف سلّم التقييم الجديد من 14 فئة. وقد نُقّحت صياغة الفئات الست المذكورة أعلاه (S1 وS2 وS3 وP1 وP2 وG1) وأُحكمت، إلى جانب الإضافات الجديدة:
- **B1**: المقطع مترابط، **نعم أو لا** (المقياس: [pAUROC](https://en.wikipedia.org/wiki/Partial_Area_Under_the_ROC_Curve))
- **B2**: المقطع ملتزم بالموضوع، **نعم أو لا** (المقياس: pAUROC)
- **B3**: المقطع مناسب للقاصرين، **نعم أو لا** (المقياس: pAUROC)
- **B4**: لا علامات تجارية أو أماكن حقيقية، **نعم أو لا** (المقياس: pAUROC)
- **B5**: يمكن استنتاج كلمة N+1 (الكانجي الجديد) من السياق، **نعم أو لا** (المقياس: pAUROC)
- **B6**: المقطع جدير بإعادة الاستخدام، **درجة من 5** (المقياس: [Harrell's C](https://statisticaloddsandends.wordpress.com/2019/10/26/what-is-harrells-c-index/))
- **B7**: يابانية المقطع طبيعية، **درجة من 5** (المقياس: Harrell's C)
- **PS2**: يابانية المقطع تبدو تالفة، **نعم أو لا** (المقياس: pAUROC)
هذه المرة، لن تقتصر بيانات التدريب على سطر واحد من اليابانية (جملة أو جملتين)، بل ستكون مزيجاً من الجمل والفقرات والقصص القصيرة. ووُسّع سلّم التقييم ليغطي هذه الحاجة. وستلاحظ أيضاً أن هناك بضع ميزات أخرى كنت مهتماً بها، مثل التخزين المؤقت لإعادة الاستخدام مع مستخدمين آخرين، وتحديد المحتوى المناسب للقاصرين لأغراض القيود العمرية.
#### توليد بيانات التدريب
أمضت وحدة GPU لديّ 10 ساعات وهي تهدر مولّدةً مواضيع جديدة ومواد تدريب باستخدام Qwen 3.8 27B. واخترت أن أواصل توليد بيانات التدريب بـ Qwen هنا، لأنه النموذج الذي سيُستخدم في عمليات التوليد في Infinilang مستقبلاً على أي حال. واستخدام نموذج أقوى هنا سيأتي بنتيجة عكسية.
وانتهيت إلى 215,000 صف، مع أحكام لجان Claude للمعيار الذهبي على كل منها. وكان Jev أيضاً سيحصل على سلّم التقييم الموسّع والمحسّن، ما حسّن نتائجه مقارنةً بالاختبار المعياري للتجربة 1 تحسيناً كبيراً.
#### نتائج المفاضلة
لاحظ أن النتائج التالية تستخدم القواعد الجديدة التي طُوّرت مع سلّم التقييم المحسّن، ولذلك تتفوق على التجربة 1 تفوقاً كبيراً. كما أنني اختبرت في بعض الفئات حساب متوسط نتائج DeepSeek + Gemma وترجيحها بحسب اتفاقها مع بعضها. وثمة تحفّظ آخر: في حالات معينة، ومع نماذج معينة، أضرّ المزيد من التفكير بالنتيجة فعلاً. لذا فهذه النتائج هي أفضل ما استطعت تحقيقه بعد الضبط على تركيبات مختلفة من التفكير وعدمه، ومن القواعد وعدمها، لكل نموذج وفئة.
| الفئة | Jev | Qwen 3.8 | DeepSeek | Gemma | متوسط DS+G | مقارنةً بـ Jev |
|--------|----:|---------:|---------:|------:|--------------:|------------:|
| B1 (الترابط) | 0.897 | 0.432 | **0.921** | 0.912 | - | +0.024 |
| B2 (الالتزام بالموضوع) | 0.896 | 0.540 | **0.971** | 0.968 | - | +0.075 |
| B5 (استنتاج الكلمة) | 0.627 | 0.580 | **0.840** | 0.754 | 0.809 | +0.213 |
| B6 (جدارة إعادة الاستخدام) | 0.786 | 0.596 | **0.819** | 0.613 | 0.740 | +0.033 |
| B7 (طبيعية المقطع) | 0.826 | 0.317 | 0.617 | 0.672 | **0.681** | -0.145 |
| PS2 (تلف المقطع) | 0.635 | 0.537 | **0.943** | 0.937 | - | +0.308 |
| S1 (طبيعية الجملة) | 0.721 | 0.740 | 0.753 | 0.774 | **0.784** | +0.063 |
| S2 (تلف الجملة) | 0.760 | 0.926 | **0.956** | 0.953 | - | +0.196 |
| S3 (أمانة الترجمة) | 0.701 | 0.765 | 0.966 | **0.987** | - | +0.286 |
| G1 (السلامة النحوية) | 0.764 | **0.966** | 0.960 (K8) | 0.960 | - | +0.202 |
| P1 (أفضل إصلاح) | 0.671 | 0.801 | 0.851 | 0.857 | **0.864** | +0.193 |
| P2 (قبول أي إصلاح) | 0.653 | 0.759 | 0.855 | **0.872** | 0.872 | +0.219 |
| B3 (الملاءمة للقاصرين) | 0.984 | 0.948 | **1.000** | 0.994 | - | +0.016 |
| B4 (خلوّ من الأسماء الحقيقية) | 0.962 | **0.994** | 0.974 | 0.991 | - | +0.032 |
*K8: ثماني إجابات قصيرة مأخوذة كعيّنات مع إيقاف التفكير، في صورة مدرّج تكراري منعَّم
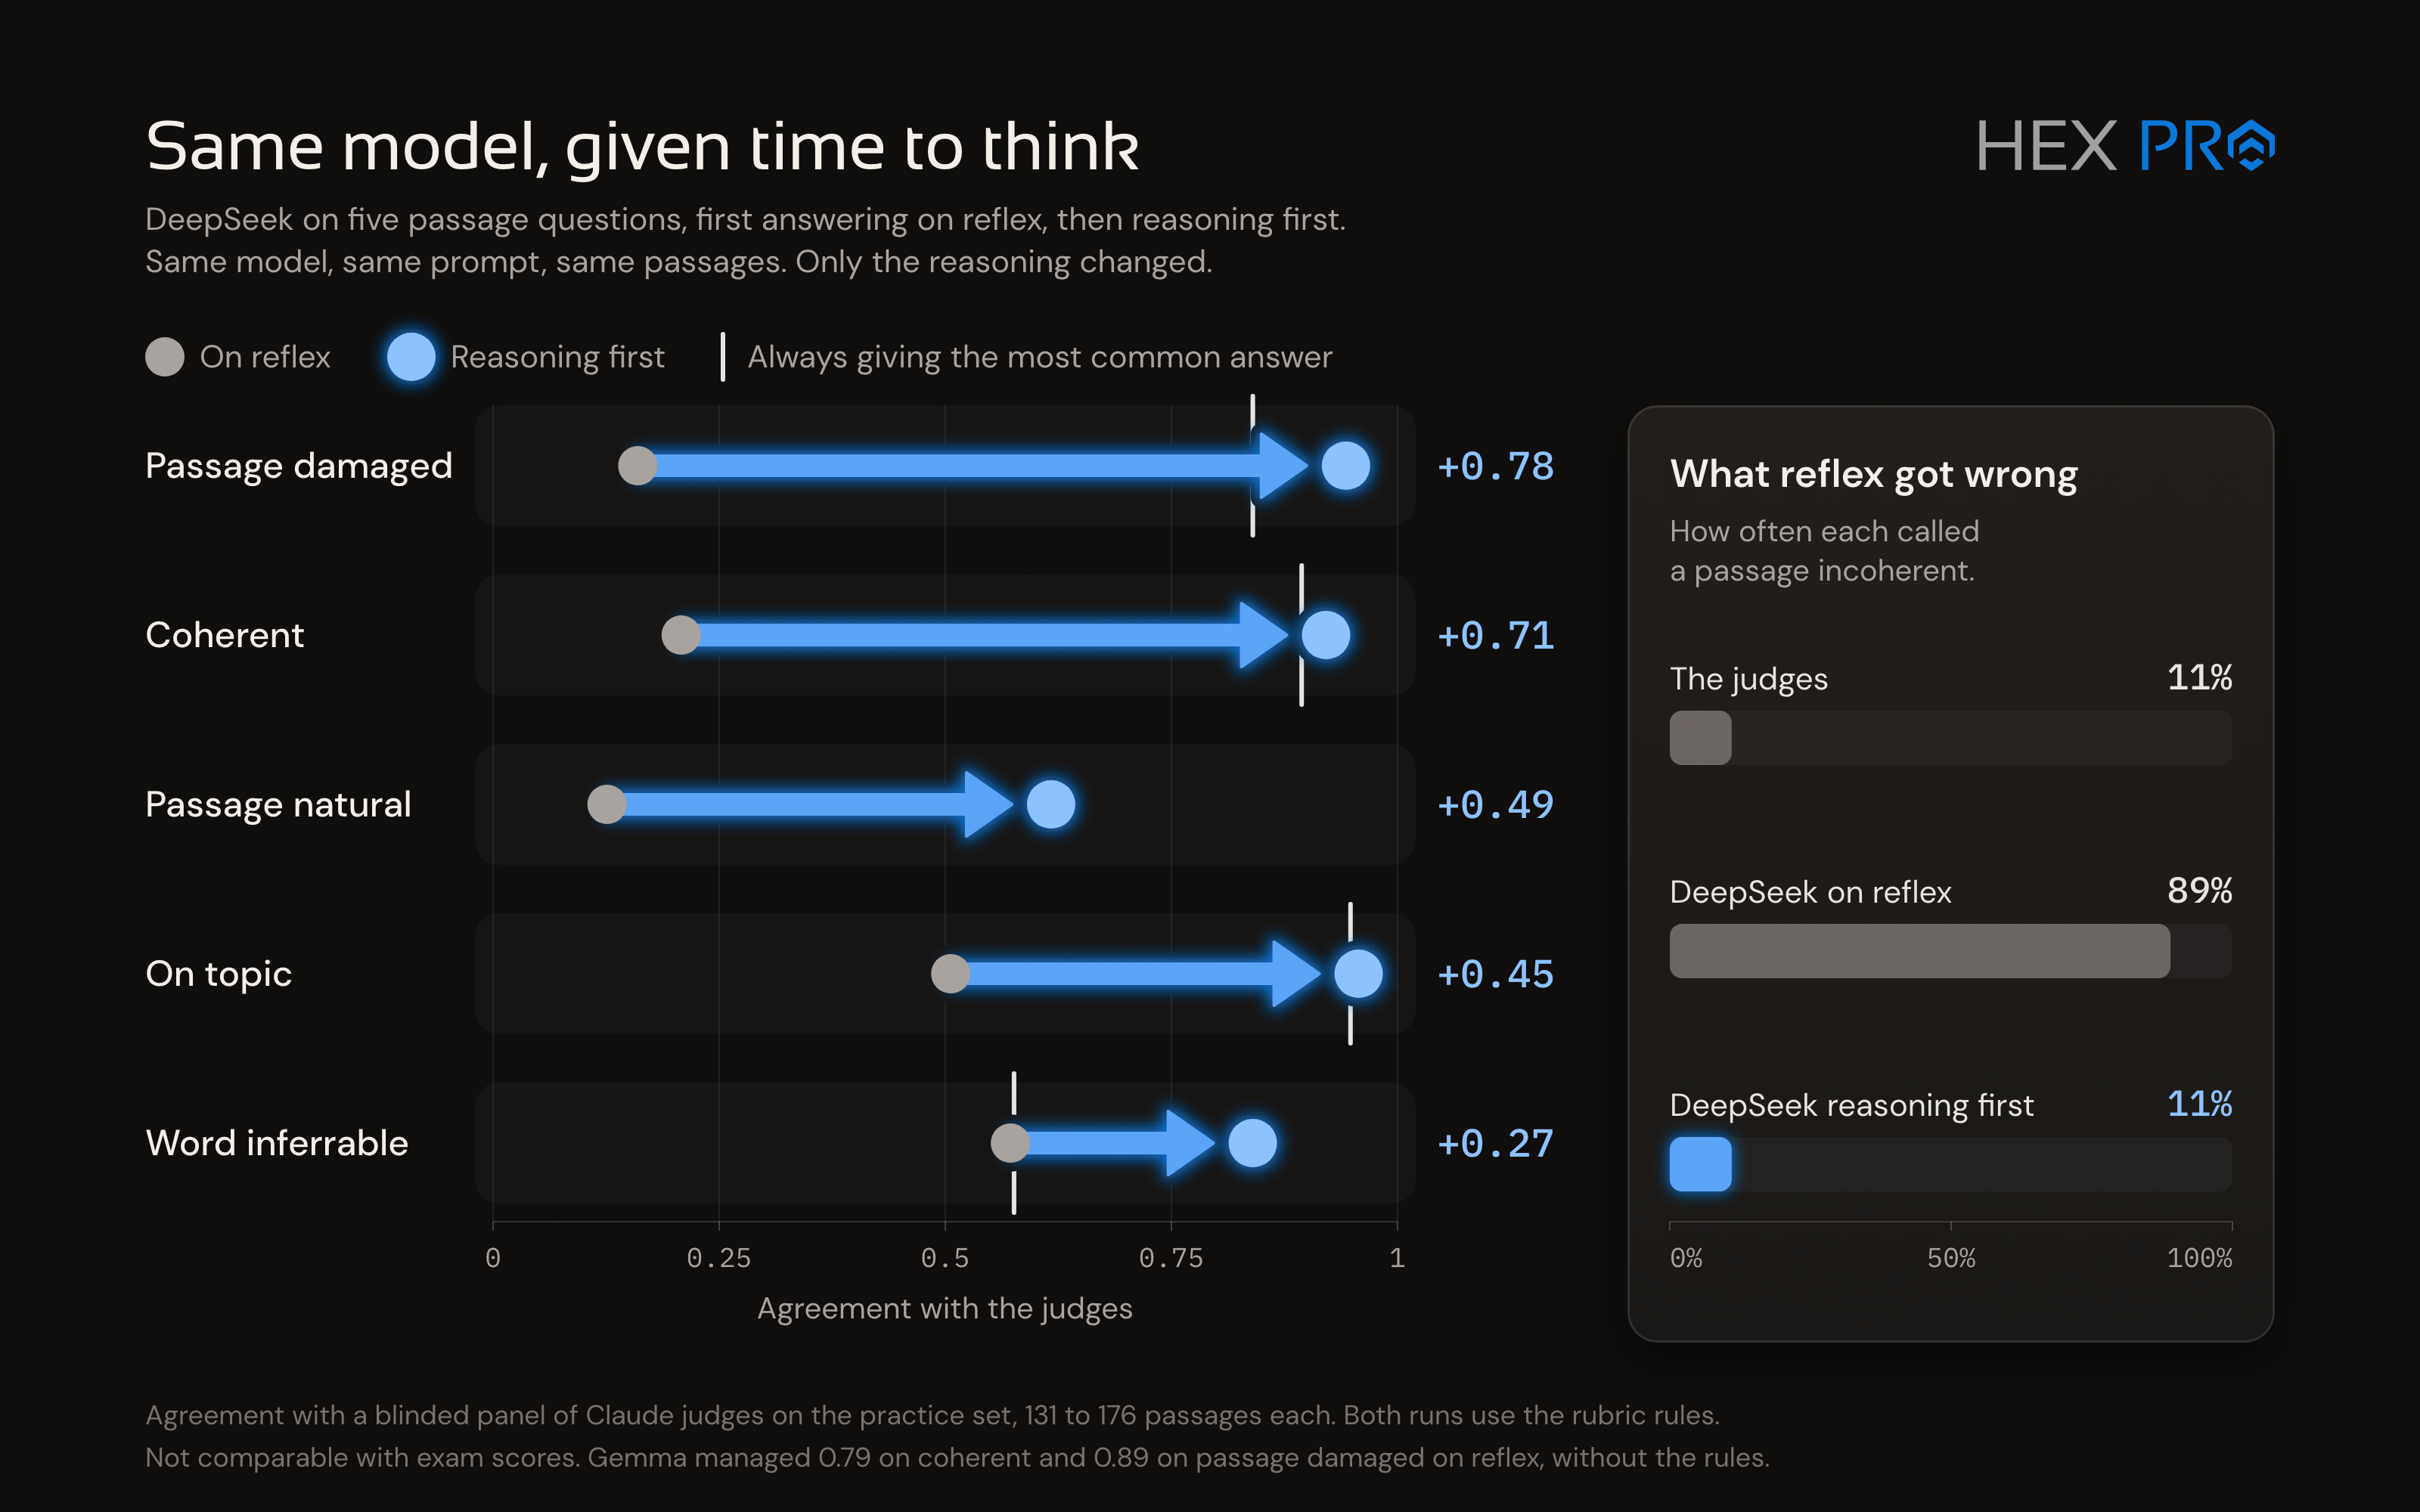 أعطتني هذه الأرقام فكرة جيدة إلى حد بعيد عما لديّ لأعمل به. وكما ذكرت سابقاً، اختبرت Jev أيضاً وفق هذه المعايير الجديدة، فوجدت أن أداءه كان أفضل بكثير هذه المرة. وقد تميّز Jev في النصوص الأطول، وهي مسألة ينبغي أخذها في الحسبان في سياق Laya، الذي لا يملك نافذة سياق بالطول نفسه ويتعامل مع النصوص الأطول بشكل أسوأ.
### التجربة 3: مرشحو الإنتاج
والآن بعد أن حسمت المعلّمين لكل فئة، حان وقت تدريب نموذج System One فعلاً. تذكّر أن التجربة 2 كانت تهدف إلى تحديد أفضل معلّم لكل فئة. وهذا لا يعني بالضرورة أن النموذج الطالب سيؤدي بمستوى المعلّم، إذ لا مفر من مقايضة ما حين تُجمع كل هذه المهام في نموذج واحد. وعلى من يفكر في استخدام Laya أن يأخذ في الحسبان عدد المهام التي يحتاج إلى أن يؤديها نموذج واحد. فعلى سبيل المثال، لو درّبت نموذجاً منفصلاً لكل فئة على حدة وحسّنته إلى أقصى حد، ثم وزّعت 14 نموذجاً في مواضع مدروسة من برنامجي، لحصلت على أفضل النتائج في كل شيء. لكن المشكلة حينها أنك تحتاج إلى تشغيل 14 نموذجاً منفصلاً، وهذا يعني تخصيص موارد GPU أكبر بكثير. فالمسألة مسألة حجم. إن كنت شركة عملاقة لديها المليارات لتنفقها على خوادم باهظة، فالقرار بديهي. فنموذج واحد من هذه النماذج يستطيع خدمة عدد فلكي من المستخدمين بأقل قدر من الموارد. أما لغيرك، فهذا على الأرجح ليس أفضل استخدام لقدرة GPU الثمينة لديك.
عند هذه النقطة، حان وقت الجد. شُغّلت وحدة GPU مرة أخرى، وهذه المرة أُمضيت 35 ساعة في توليد مزيد من بيانات التدريب ووسمها. ثم عملت لجان Claude للمعيار الذهبي مجدداً على البيانات الجديدة، ما كلّف أكثر من 200 مليون رمز (token) ضمن خطة Ultra (المعروفة سابقاً بـ Max 20x).
كان DeepSeek هو المكلف، فلأنه لا يمكن تشغيله محلياً، احتاج إلى استدلال سحابي. وقد اختير لـ 9 فئات وكلّف 233.56 دولاراً أسترالياً، واستغرق 18 ساعة ليكتمل. يبدو كل شيء بريئاً جداً بالدولار الأمريكي، لكن المعاملات المصرفية بالدولار الأسترالي تبدو أسوأ بكثير. أما استدلال Gemma 4 فجرى على بنيتنا التحتية الخاصة، فكان مجانياً، واستغرق نحو 60 ساعة لوسم الفئات القليلة التي خُصّصت له.
#### الطلاب الأربعة
في النهاية، درّبت أربعة مرشحين بضبط وأفكار مختلفة: `prod-q38` و`prod-ds41` و`prod-mix1` و`prod-mix2`. ودُرّب كل طالب بثلاث أذرع وبذرتين عشوائيتين لكل ذراع، لنضمن ألا تخدعنا نتيجة شاذة. ثم دُرّب المتأهلون إلى النهائي على ثلاث بذور إضافية.
- الذراع A: `laya-multilingual` (mmBERT) برأسه المدرَّب مسبقاً.
- الذراع B: `modernbert-ja-310m` برأس جديد.
- الذراع E: `sokudan-ja-310m` مزروعاً في بنية الذراع B.
وكانت هناك أيضاً ذراع D، وهي اختبار لزمن الاستجابة بنموذج من 130 مليون معامل، وقد تخلّفت في الأداء.
##### prod-q38: Qwen 3.8
هو الأول والأرخص تدريباً، واستخدم Qwen وحده بتهيئات مختلفة (مع التفكير أو بدونه، ومع القواعد أو بدونها) بحسب ما حقق أفضل النتائج. كنت أعلم أنه لن يؤدي بمستوى الآخرين، لكنه كان امتداداً للتجربة 1 ووفّر خط أساس لقياس مدى تحسّن النماذج الأخرى.
##### prod-ds41: DeepSeek وQwen
كان DeepSeek صاحب الأداء الأفضل بوضوح في التجربة السابقة، لكن Qwen تفوّق عليه أو اقترب منه كثيراً في بضع فئات. وحيثما عادله Qwen أو تجاوزه، استخدمت Qwen لتوفير بعض المال.
##### prod-mix1: DeepSeek وGemma وQwen
أخذ هذا الطالب الأفضل في كل فئة، وحاول أن يصنع منها الطبق المشكّل الأمثل. كما اختبر وضع DeepSeek مكان Qwen في المواضع التي بدا فيها أداء الطالب `prod-ds41` أسوأ من المتوقع.
##### prod-mix2: خلطة جديدة من DeepSeek وGemma وQwen
فكرة مشابهة لـ `prod-mix1`، لكن أُعيدت P1 وB3 إلى ما كانتا عليه في `prod-ds41` لمعرفة ما إذا كان ذلك يحسّن النتائج.
#### عن الأذرع
كان التدريب على أذرع مختلفة فكرة حكيمة، لأنه كشف بيانات مهمة جداً. فكل الأذرع المدرَّبة انطلاقاً من `laya-multilingual` (الذراع A) كانت أدنى من الذراع B والذراع E. وكانت هذه نتيجة مهمة، لأنها أظهرت أن النسخة متعددة اللغات، على الأقل في حالتي التي لم أحتج فيها إلا إلى اليابانية، كانت لا تصلح لشيء.
أنصح بشدة كل من يحاول تدريب نموذج System One بأن يتخلى عن نماذج Laya الجاهزة، وأن يدرّب انطلاقاً من رأس نظيف على ModernBERT. أو على الأقل أن يُجري اختبار الأذرع المتعددة كما فعلنا، كي لا يقع في فخ نقطة حفظ (checkpoint) أدنى مستوى.
#### الطلاب أمام الامتحان
هذه هي الأرقام النهائية لكل طالب مقابل أرقام Jev النهائية بسلّم التقييم المحسّن على بيانات التدريب الجديدة.
| الفئة | Jev | prod-q38 | prod-ds41 | prod-mix1 | prod-mix2 |
|---|---:|---:|---:|---:|---:|
| S1 | **0.721** | 0.604 | 0.641 | 0.620 | 0.639 |
| S2 | 0.760 | 0.879 | 0.889 | **0.890** | 0.884 |
| S3 | **0.701** | 0.552 | 0.631 | 0.574 | 0.521 |
| P1 | 0.671 | 0.833 | 0.825 | **0.857** | 0.813 |
| P2 | 0.603 | 0.788 | 0.852 | **0.887** | 0.820 |
| B1 | 0.897 | 0.734 | **0.921** | 0.898 | 0.894 |
| B2 | 0.846 | 0.858 | 0.890 | 0.884 | **0.900** |
| B3 | **0.984** | 0.938 | 0.955 | 0.933 | 0.955 |
| B4 | 0.962 | 0.968 | 0.943 | 0.957 | **0.969** |
| B5 | 0.627 | 0.571 | **0.656** | 0.627 | 0.614 |
| B6 | 0.777 | 0.841 | 0.843 | **0.879** | 0.867 |
| B7 | 0.826 | 0.847 | **0.882** | 0.878 | 0.871 |
| PS2 | 0.615 | 0.705 | 0.830 | 0.838 | **0.850** |
| G1 | 0.764 | 0.804 | **0.815** | 0.814 | **0.815** |
| **المؤشر المركّب** | 0.768 | 0.780 | **0.827** | 0.824 | 0.815 |
النتائج مذهلة لأنها ليست دائماً بديهية أو متوقعة. والأمر الجوهري الذي يجب إدراكه هو أن التدريب على قيم كل فئة يؤثر في جميع الفئات الأخرى بدرجة صغيرة لكنها تتراكم. لذا تأتي الأرقام متناثرة في كل اتجاه. ففي بعض الحالات يحقق الطالب نتيجة أفضل من المعلّم، وفي حالات كثيرة يحقق نتيجة أسوأ بقليل.
ومن الصعب جداً أيضاً تحديد فائز فعلي، لأن قيمة الفئات ليست متساوية. فعلى سبيل المثال، S1 (طبيعية اليابانية) فئة مهمة، وJev يتفوق فيها تفوقاً كبيراً على الآخرين. وفي المقابل، B7 (طبيعية اليابانية في *المقطع* كله) مهمة جداً أيضاً، وJev يتخلف فيها عن جميع النماذج الأخرى.
وعلى المنوال نفسه، «فوز» نموذج في فئات كثيرة لا يجعله أفضل تلقائياً. فـ `prod-ds41` و`prod-mix1` و`prod-mix2` متقاربة جداً في معظم الحالات. والفرق بين نتيجة `prod-mix1` في S2 البالغة 0.890 ونتيجة `prod-ds41` البالغة 0.889 معدوم عملياً. ويتضح ذلك أكثر إذا أزلنا الضجيج واكتفينا بعرض التفوق أو التأخر مقارنةً بـ Jev، ولكن فقط للنماذج التي تفوز بالفئة أو تتعادل على الفوز.
| الفئة | Jev | prod-q38 | prod-ds41 | prod-mix1 | prod-mix2 |
|---|---:|---:|---:|---:|---:|
| S1 (طبيعية الجملة) | 0.721 | -12% | -8% | -10% | -8% |
| S2 (تلف الجملة) | 0.760 | +12% | +13% | +13% | +12% |
| S3 (أمانة الترجمة) | 0.701 | -15% | -7% | -13% | -18% |
| P1 (أفضل إصلاح) | 0.671 | +16% | +15% | +19% | +14% |
| P2 (قبول أي إصلاح) | 0.603 | +19% | +25% | +28% | +22% |
| B1 (الترابط) | 0.897 | -16% | +2% | 0% | 0% |
| B2 (الالتزام بالموضوع) | 0.846 | +1% | +4% | +4% | +5% |
| B3 (الملاءمة للقاصرين) | 0.984 | -5% | -3% | -5% | -3% |
| B4 (خلوّ من الأسماء الحقيقية) | 0.962 | +1% | -2% | -1% | +1% |
| B5 (استنتاج الكلمة) | 0.627 | -6% | +3% | 0% | -1% |
| B6 (جدارة إعادة الاستخدام) | 0.777 | +6% | +7% | +10% | +9% |
| B7 (طبيعية المقطع) | 0.826 | +2% | +6% | +5% | +5% |
| PS2 (تلف المقطع) | 0.615 | +9% | +22% | +22% | +24% |
| G1 (السلامة النحوية) | 0.764 | +4% | +5% | +5% | +5% |
| المؤشر المركّب | 0.768 | +1% | +6% | +6% | +5% |
في رأيي، `prod-ds41` هو النموذج المتوازن المنشود. ولدى `prod-mix1` نتائج مبهرة في بضع فئات (لا سيما P1 وP2 وB6)، لكنه يخسر الكثير أمام Jev في فئات أخرى يخسر فيها `prod-ds41` أقل (S3 وS1 وB1 وB3). أما `prod-mix2` فلديه نقاط ضعف جدية مقارنةً بالاثنين الآخرين، إذ هو أضعف بوضوح في عدة فئات (S3 وP1 وP2 وB5)، وليس قوياً بشكل خاص في البقية. ومع ذلك، تتفوق النماذج الثلاثة على Jev عموماً في معظم الفئات، مع بضعة استثناءات يتفوق فيها Jev *حقاً* (S1 وS3 وB3).
لذا، إذا خُيّرت بين `prod-ds41` و`prod-mix1`، فإن `prod-ds41` يتقدم لمجرد أنه أكثر ثباتاً في قوته عبر جميع الفئات.
## الحكم
انتهى `prod-ds41` إلى انتزاع التاج ونيل اسم `infini-jp-v1`. وتُظهر الأرقام بوضوح شديد أنه قادر على أداء معظم الأدوار، باستثناء مخيّب هو S1، طبيعية الجملة، التي وجدت لها حلاً آخر على أي حال (سأتحدث عن ذلك لاحقاً).
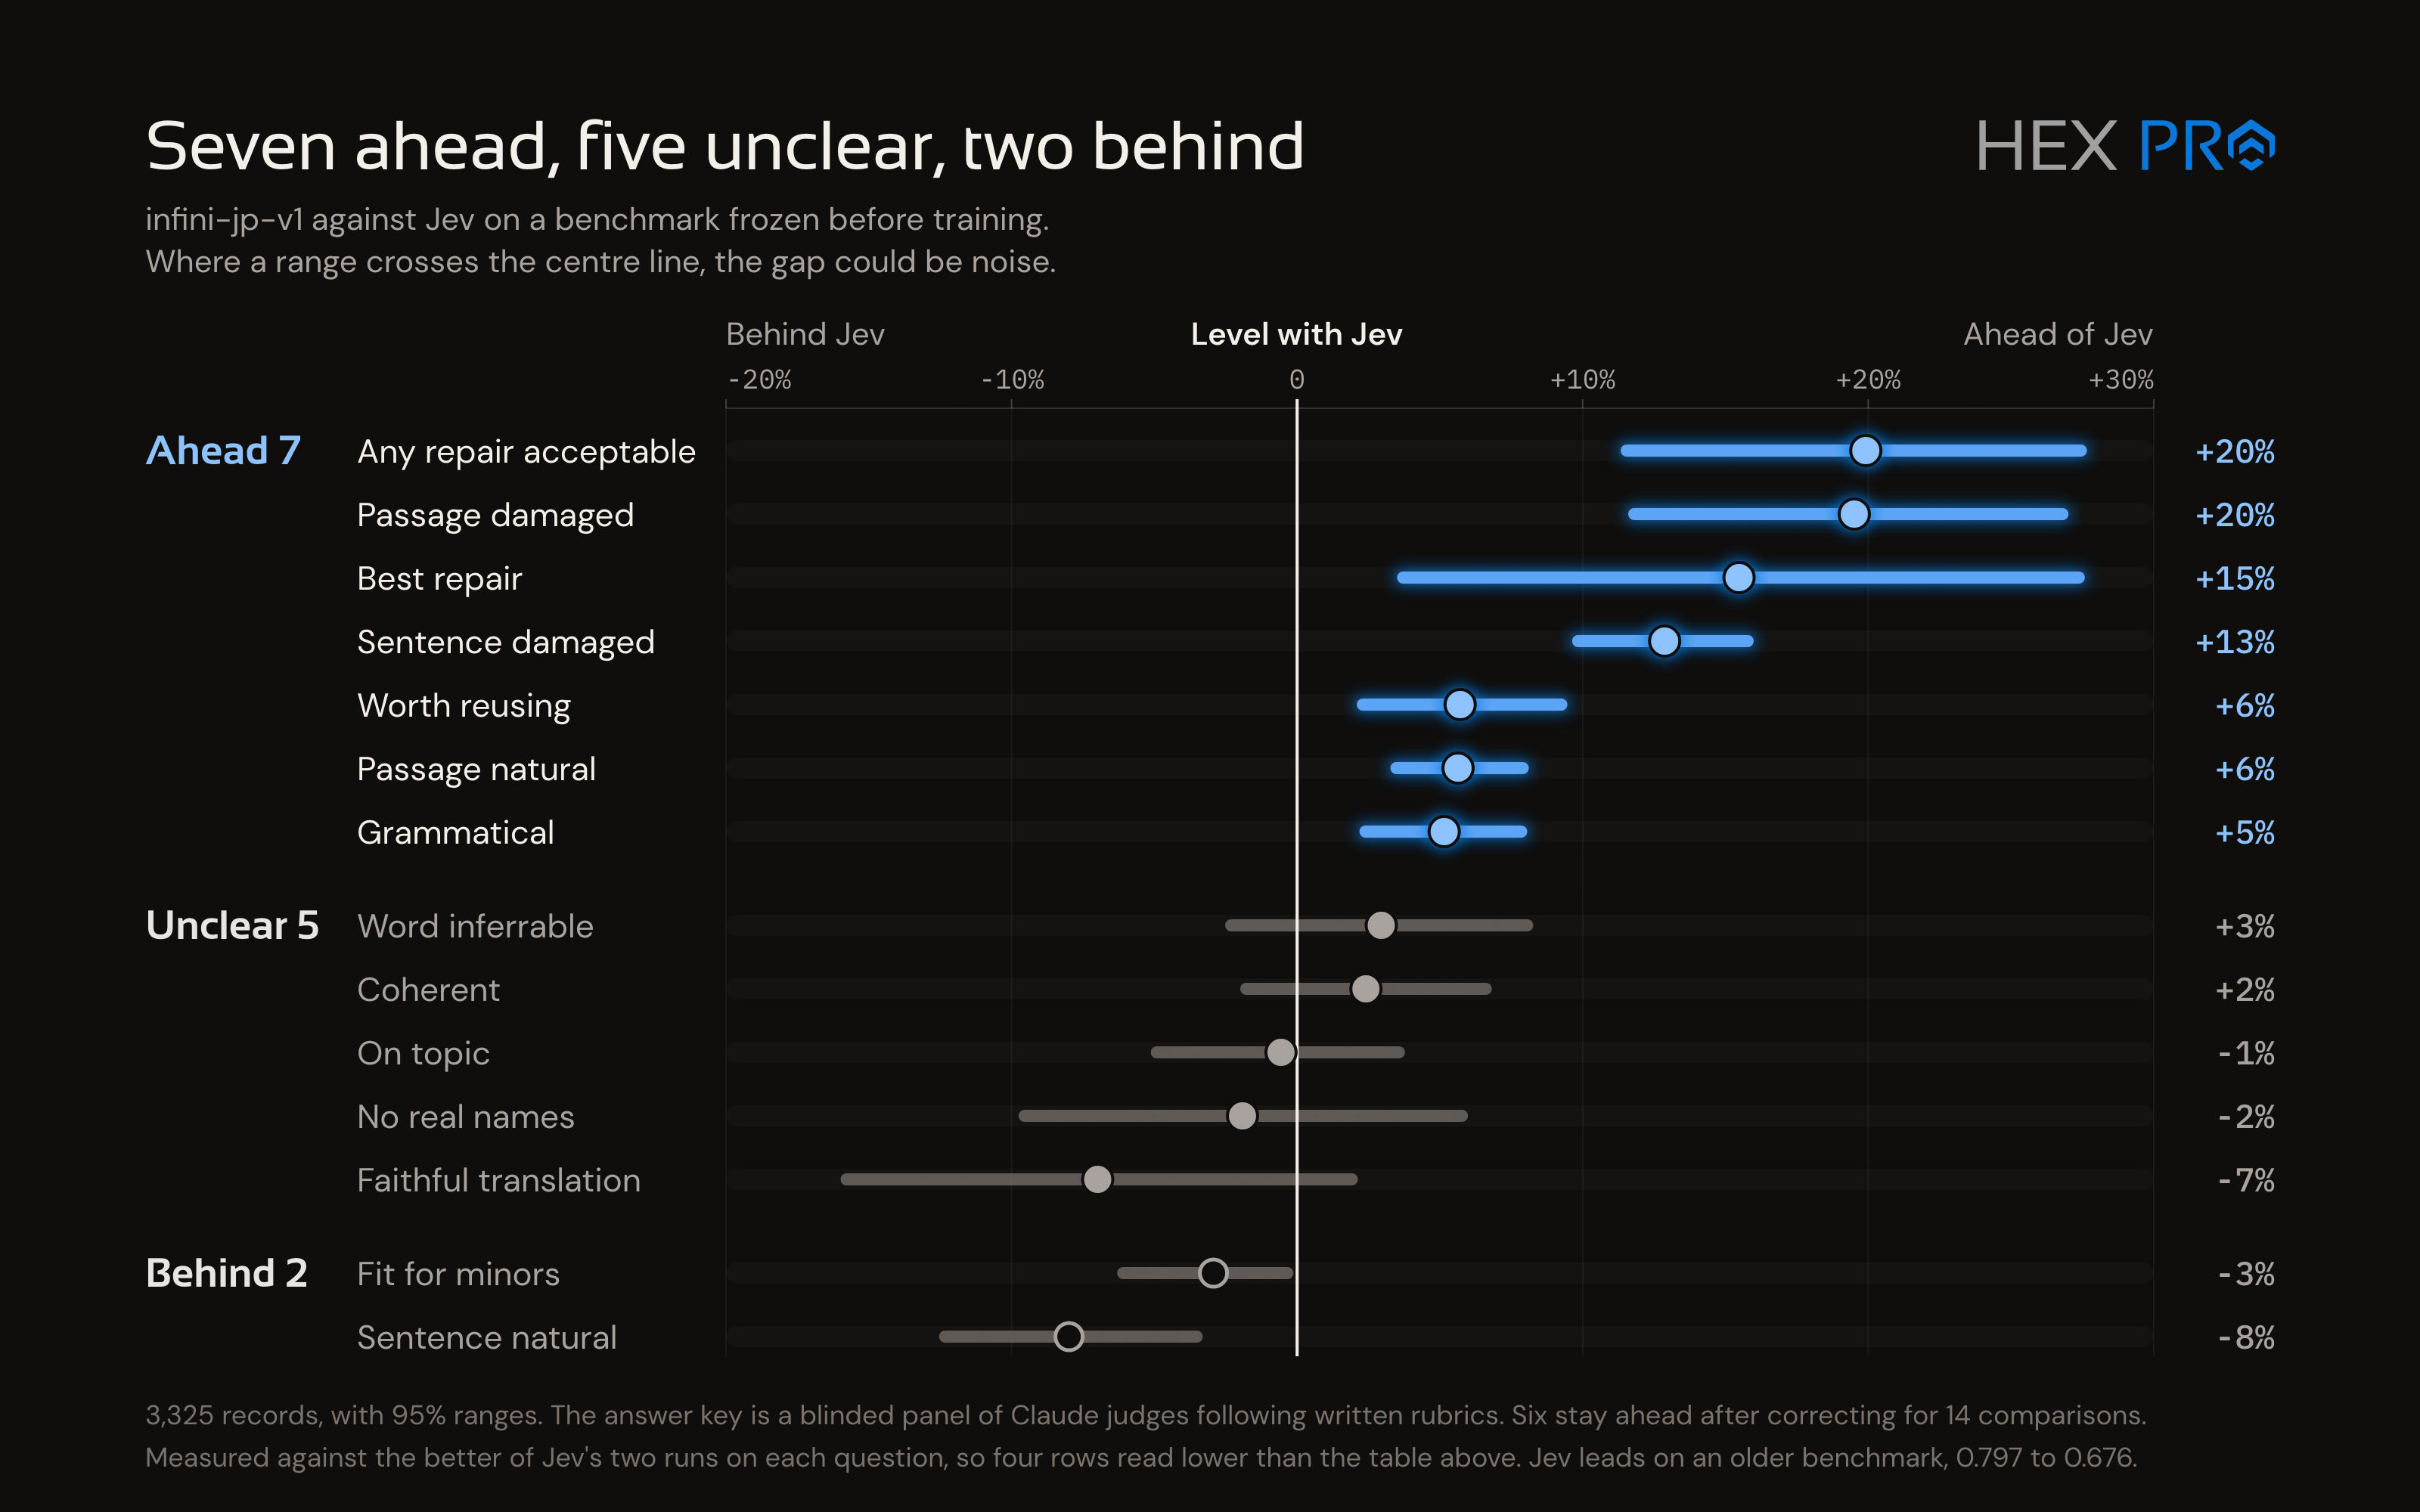 وبالعودة إلى السؤال الرئيسي: هل Laya أفضل من Jev؟ ربما؟ لكن على الأرجح لا. ومع أنه يتفوق على Jev في هذه الحالة، في هذه المجموعة بالذات من المهام، فلنُحصِ ما كلّفه تطويره.
### المال يا عزيزي، المال!
إجمالاً، أنفقت على هذا المشروع 270 دولاراً أمريكياً (389 دولاراً أسترالياً) في المجموع، منها 268.23 دولاراً أمريكياً على الاستدلال السحابي، و**0.21 دولار أمريكي على Jev**. رخيص بمعايير تدريب الذكاء الاصطناعي، إن صدّقنا مئات المليارات من الديون التي تتحملها Anthropic وOpenAI. لكنه ليس رخيصاً بمعايير شركة ناشئة برأس مال محدود وإيرادات ضئيلة (حتى الآن). ومع ذلك، كان بحثاً وتطويراً قيّماً لأنه أجاب عن أسئلة مهمة حول ما إذا كان عليّ استخدام هذه التقنية في مشاريعي الأخرى مستقبلاً. كما أصبح لديّ الآن مشروع لخط معالجة التدريب فيه أكثر من 1000 إيداع و14,522 اختباراً للوحدات، ما يعني أن تطوير نموذج System One آخر في المستقبل صار مجرد مسألة تنقيح لسلّم التقييم وإجراء مفاضلات النماذج.
### الوقت!
لم يكن المشروع رخيصاً من حيث الوقت الذي قضيته بنفسي في العمل عليه. ألف شكر لـ Dario على Claude Code، فقد تكفّل بكثير من الأعمال الروتينية (مراقبة انتهاء عمليات التشغيل، وجدولة الأجزاء التالية، وما إلى ذلك). وهذا يعني أدنى قدر من التوقف، إذ ظل العمل مستمراً طوال الليل. ومع ذلك، استغرق إنجاز هذا المشروع من بدايته إلى نهايته 24 يوماً. ولولا مساعدة الذكاء الاصطناعي لاستغرق ستة أشهر، لا شك لديّ في ذلك.
وبصرف النظر عن أن الذكاء الاصطناعي وفّر قدراً هائلاً من الوقت وأتاح لي العمل على أمور أخرى بالتوازي، فإن الوقت الذي استثمرته بنفسي كان سيساوي نحو 5000 دولار أسترالي بحسب أجري السابق. وهذه تكلفة *يجب* أخذها في الحسبان عند تدريب نموذج System One.
### قدرة GPU الحاسوبية والكهرباء
أنا محظوظ نوعاً ما لأنني أملك وحدة GPU سريعة وقوية من فئة المؤسسات. لكن هذا المشروع تطلّب أكثر من 40 ساعة من الاستخدام الحصري لوحدة GPU، وأخشى حتى أن أفكر في قيمة فاتورة الكهرباء. بل لا أريد أن أعرف أصلاً.
والتكلفة المستمرة الأخرى هنا أنه يشغل نحو 2GB من VRAM في خادمي.
### هل يستحق العناء؟
هذا سؤال مهم يصعب قياسه. وهذه هي الأسئلة التي كنت سأريد الإجابة عنها لو كنت أفكر في خوض هذه التجربة:
- هل Jev قادر على أداء المهمة جيداً؟
- ما حجم الاستدعاءات الذي تتوقعه؟
- كم عدد المهام التي تحتاج إلى أن يؤديها، وما مدى تنوعها؟
- كم من الوقت ستحتاج لاسترداد استثمارك؟
- ما أهمية راحة البال التي تمنحها معرفة أن برمجياتك ستعمل بعد أن تختفي TypeSafe؟
- ما مدى اهتمامك بدقة المعايرة/الثقة؟
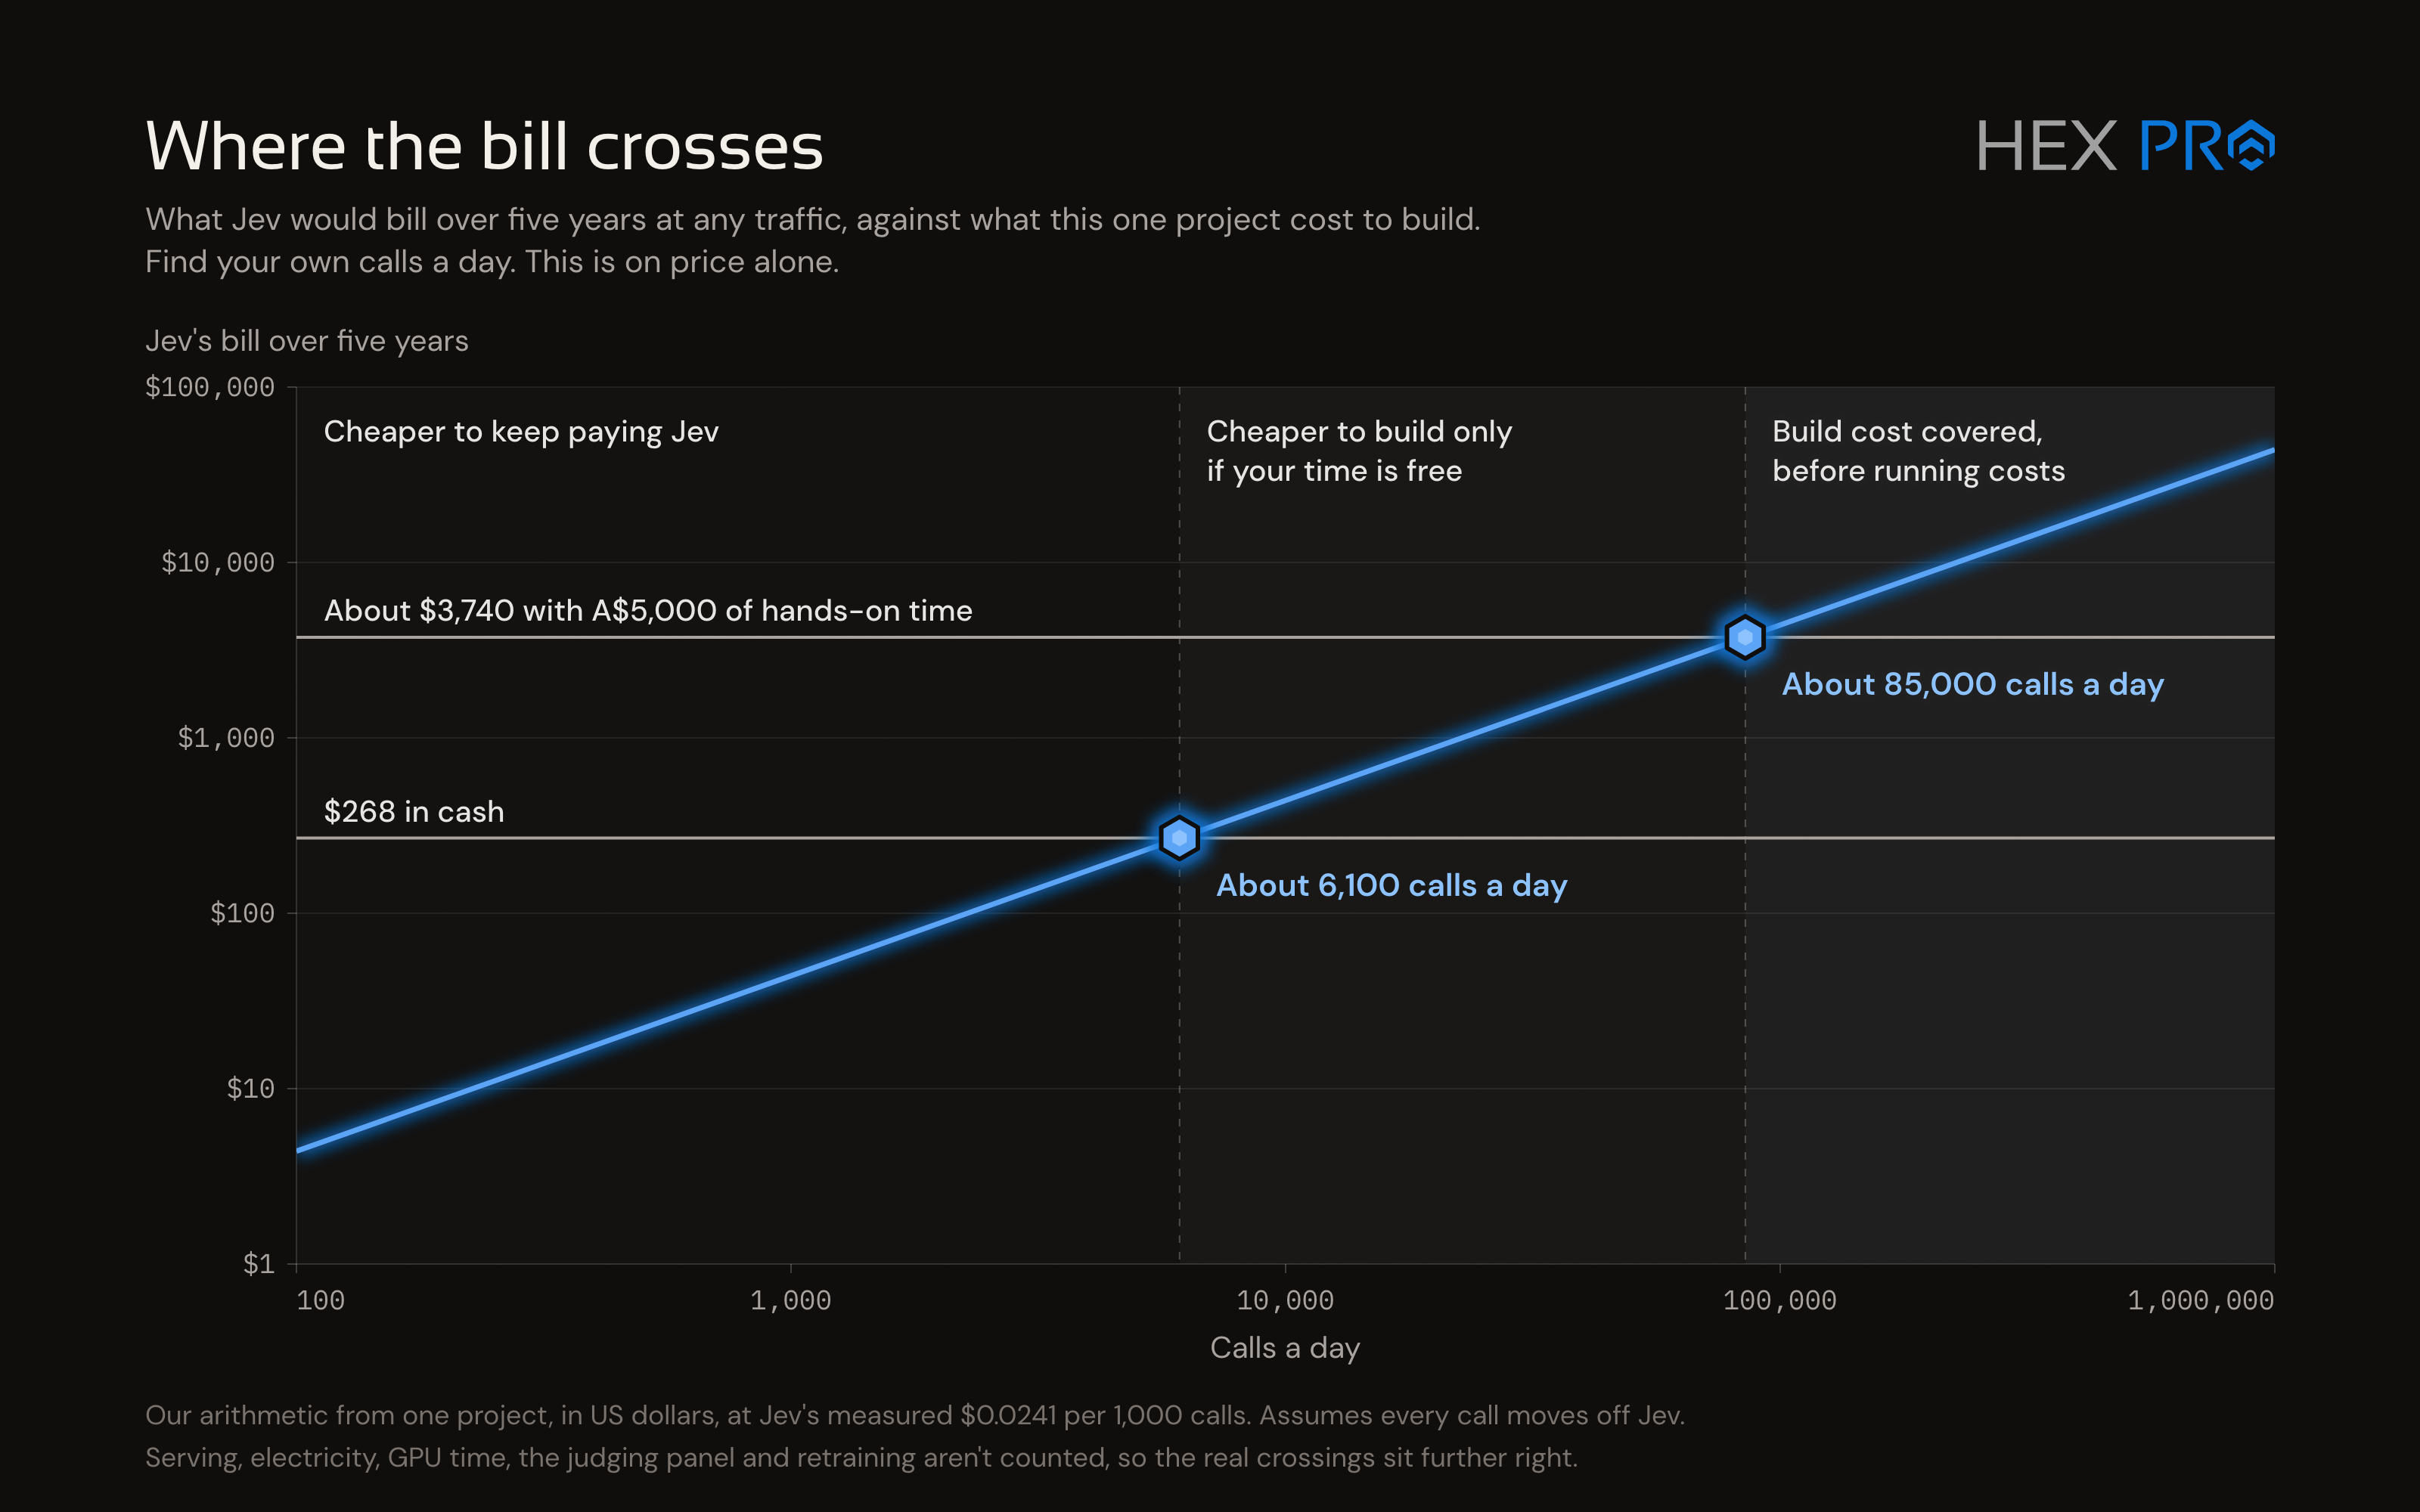 في حالتي، قد يساعد تحسّن القدرات Infinilang على تقديم أداء أفضل. وإن تحسّن أداء Infinilang نتيجةً لذلك، وأتاح لي بناء قاعدة مستخدمين أكبر، فسيسترد تكلفته حتماً. وهذا هو السبيل الوحيد لأبرّر استخدام Laya بدلاً من Jev.
### أكبر المزايا
- **زمن الاستجابة**: من أستراليا، يستغرق Jev نحو 258 ملّي ثانية ذهاباً وإياباً. أما Laya فمتوسطه نحو 19 ملّي ثانية، أي أنه أسرع من Jev بـ 13 مرة على الأقل، وأسرع من DeepSeek بـ 2000 مرة.
- **فرصة GPU**: يشغل 2GB من VRAM. هذا ليس بالقليل، لكنه ليس ضخماً أيضاً. وإليك الميزة الحقيقية: تلك الفئات الـ 14 من الأسئلة التي يجيب عنها `infini-jp-v1` هي أسئلة لم يعد على Qwen 3.8 27B أن يجيب عنها (بشكل رديء)، ما يحرّر وحدة GPU للرد على طلبات أخرى أهم وأنسب.
- **محاكاة نموذج متفوق**: لا تحتاج إلى تشغيل DeepSeek V4.1 لتحصل على إجابات قريبة جداً مما كان سيقدّمه. فأداء `infini-jp-v1` في هذه المهام أفضل بكثير من Qwen 3.8 27B، ولا تحتاج إلى استدعاء نموذج DeepSeek يتطلب 614GB من VRAM لتحقيق ذلك.
- **أمان الأعمال**: كما ذكرت مرات عدة، لا داعي لأن أقلق من اختفاء Jev فجأة حين أستخدم نموذجي الخاص. لا انقطاعات غير متوقعة، ولا سباق محموم بحثاً عن بديل. إن كانت برمجياتي تعمل، فأنا أعلم أن نموذج System One الخاص بي يعمل كذلك.
- **تفوّق في المهام المحددة؟**: ما إذا كان أداؤه أفضل فعلاً أمر لم يتضح بعد في بيئة الإنتاج. سنرى. وكما رأيت من النتائج، فهو نظرياً أفضل بنسبة 6% في Infinilang، لكن ذلك عبر جميع الفئات، وليس بالضرورة في الفئات التي يقوم عليها العمل.
## عن LoRA
لغير الملمّين،[ LoRA (التكيّف منخفض الرتبة)](https://en.wikipedia.org/wiki/LoRA_(machine_learning)) أشبه بشخصية جاهزة للتركيب والاستخدام في النموذج اللغوي. وربما سمعت الناس يسمّونها بدلاً من ذلك «الضبط الدقيق». وعلى عكس نموذج System One الذي يمثّل خدمة مستقلة بذاتها، تُطبَّق LoRA على النموذج اللغوي مباشرةً عند الاستدلال لتعديل أوزانه وجعله يتصرف بشكل مختلف.
ولذلك، درّبت في مرحلة لاحقة من تطوير Infinilang طبقة LoRA تساعد Qwen 3.8 27B على إنتاج مخرجات أعلى جودة واتباع قواعد أكثر صرامة. وهذا يعني أن `infini-jp-v1` سيصنّف مواد أعلى جودة، فلن يضطر إلى بذل جهد كبير، وينبغي أن يكون أثره أكثر موثوقية، لا سيما لدى المستخدمين الذين يملكون رصيداً أصغر من الكانجي.
وسأسعى إلى تحسين Infinilang أكثر فأكثر مع استمرار التطوير.